
Hermes AI 어시스턴트 - 설치, 설정, 워크플로 및 문제 해결
개발자를 위한 Hermes Agent 설치 및 빠른 시작
Hermes Agent는 로컬 머신 또는 저가형 VPS에서 실행되는 셀프 호스팅, 모델 독립형 AI 어시스턴트입니다. 터미널 및 메신저 인터페이스를 통해 작동하며, 반복적인 작업을 재사용 가능한 스킬로 변환함으로써 시간이 지남에 따라 성능을 향상시킵니다.
개발자를 위한 Hermes Agent 설치 및 빠른 시작
Hermes Agent는 로컬 머신 또는 저가형 VPS에서 실행되는 셀프 호스팅, 모델 독립형 AI 어시스턴트입니다. 터미널 및 메신저 인터페이스를 통해 작동하며, 반복적인 작업을 재사용 가능한 스킬로 변환함으로써 시간이 지남에 따라 성능을 향상시킵니다.
TGI 를 설치하고 빠르게 배포하며 더 빠르게 디버깅하세요.
Text Generation Inference(TGI) 는 매우 특유의 에너지를 지니고 있습니다. 추론 분야에서 가장 새로운 기술은 아니지만, 이미 프로덕션 환경에서 발생하는 문제를 잘 이해하고 있습니다.
16GB VRAM에서 llama.cpp의 토큰 처리 속도(테이블)
여기서는 16GB VRAM을 갖춘 GPU에서 구동되는 여러 LLM의 속도를 비교하고, 자가 호스팅에 가장 적합한 모델을 선택하는 과정을 다루고 있습니다.
GPU 및 영구 저장 기능을 갖춘 Compose 우선 Ollama 서버
Ollama는 베어 메탈(bare metal) 환경에서도 훌륭하게 작동합니다. 서비스처럼 다룰 때 더 재미가 생깁니다: 안정적인 엔드포인트, 고정된 버전, 영속적 저장소, 그리고 사용 가능하거나 불가능한 GPU.
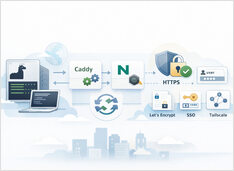
스트리밍 응답을 깨뜨리지 않고 HTTPS를 사용한 Ollama
리버스 프록시 뒤에 Ollama 를 실행하는 것은 HTTPS, 선택적 접근 제어, 예측 가능한 스트리밍 동작을 얻는 가장 간단한 방법입니다.
SGLang 로 오픈 모델을 빠르게 제공하세요.
SGLang 은 단일 GPU 에서 분산 클러스터에 이르기까지 저지연 및 고휘도 추론을 제공하도록 설계된 대규모 언어 모델 및 멀티모달 모델용 고성능 서비스 프레임워크입니다.
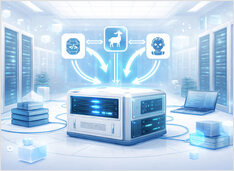
클라이언트 변경 없이 로컬 LLM을 핫스왑하세요.
가까운 미래에는 vLLM, llama.cpp 등 다양한 스택을 여러 포트에서 동시에 관리하게 될 것입니다. 하지만 다운스트림의 모든 시스템은 여전히 단일 /v1 기반 URL을 요구합니다. 그렇지 않으면 포트, 프로필, 일회용 스크립트를 계속 치환하는 수고스러운 일이 반복됩니다. llama-swap은 이러한 스택 앞단에 배치되는 /v1 프록시입니다.
대부분의 로컬 AI 설정은 모델과 런타임으로 시작합니다.
Ultrawork 를 실행할 때 실제로 어떤 일이 일어나는지 알아봅니다.
Oh My Opencode 는 “가상의 AI 개발 팀"을 약속합니다. Sisyphus 가 전문가들을 지휘하고, 작업이 병렬로 실행되며, 마법 같은 ultrawork 키워드가 모든 것을 활성화합니다.
Oh My Opencode 를 설치하고 더 빠르게 배포하세요.
Oh My Opencode 는 OpenCode 를 **멀리 에이전트 코딩 하네스 (multi-agent coding harness)**로 변신시킵니다. 오케스트레이터가 작업을 병렬로 실행하는 전문 에이전트에게 위임합니다.
OpenCode LLM 테스트 — 코딩 및 정확도 통계
로컬 호스팅된 Ollama 및 llama.cpp 기반 LLM들과 OpenCode가 어떻게 작동하는지 테스트해 보았습니다. 비교를 위해 OpenCode Zen의 일부 무료 모델도 추가했습니다.
시시포스와 그 전문 에이전트 팀을 소개합니다.
OpenCode 의 가장 큰 능력 향상은 전담 에이전트 (specialised agents) 에서 비롯됩니다: 오케스트레이션, 계획, 실행, 연구의 의도적인 분리입니다.
CLI 설치, 플래그, 헤드리스, 로컬 모델
OpenHands는 샌드박스 내에서 파일을 편집하고 명령을 실행하는 오픈소스 코딩 에이전트입니다. 이 CLI 퀵스타트는 2026년 10월 26일에 패키지 1.16.0 버전으로 검증되었습니다.
분산형 로컬 AI 를 통해 OpenAI 호환 API 를 LocalAI 로 몇 분 안에 자체 호스팅하세요.
LocalAI 는 자신의 하드웨어 (노트북, 워크스테이션, 온프레미스 서버) 에서 AI 워크로드를 실행하기 위해 설계된 자체 호스팅, 로컬 우선 추론 서버로, OpenAI API 와의 호환성을 제공하여 기존 도구를 그대로 사용할 수 있도록 합니다.
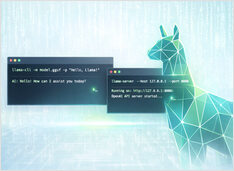
CLI 및 서버에서 GGUF 모델 실행하기
llama.cpp는 GGUF 모델용 C/C++ 추론 엔진입니다: 대화형 챗에는 llama-cli, 스크립트된 프롬프트에는 llama-completion, OpenAI 호환 HTTP API에는 llama-server를 제공합니다.
인공지능(AI)은 소프트웨어의 작성, 검토, 배포, 유지보수 방식을 근본적으로 변화시키고 있습니다. AI 코딩 어시스턴트부터 GitOps 자동화 및 DevOps 워크플로까지, 개발자들은 이제 소프트웨어 수명주기 전반에 걸쳐 AI 기반 도구에 의존하고 있습니다.