
RAG에서의 Chunking 전략 비교: 대안, 트레이드오프 및 예시
RAG에서의 청크링 전략 비교
Chunking은 Retrieval ‑ Augmented Generation (RAG)에서 가장 과소평가되는 하이퍼파라미터입니다: 이는 조용히 LLM이 “보는” 내용을 결정하며, 데이터의 인gestion 비용을 얼마나 많이 증가시키는지, 그리고 각 답변당 LLM의 컨텍스트 창을 얼마나 많이 소모하는지를 결정합니다.
RAG에서의 청크링 전략 비교
Chunking은 Retrieval ‑ Augmented Generation (RAG)에서 가장 과소평가되는 하이퍼파라미터입니다: 이는 조용히 LLM이 “보는” 내용을 결정하며, 데이터의 인gestion 비용을 얼마나 많이 증가시키는지, 그리고 각 답변당 LLM의 컨텍스트 창을 얼마나 많이 소모하는지를 결정합니다.
기본 RAG부터 프로덕션 환경까지: 청킹, 벡터 검색, 리랭킹 및 평가를 한 번에 정리한다.
자체 호스팅 LLM으로 데이터와 모델을 제어하세요
자체 호스팅 LLM은 데이터, 모델 및 추론을 당신의 통제 하에 유지하며, 팀, 기업, 국가를 위한 **AI 주권**으로 가는 실용적인 경로를 제시합니다.
2026년 10월 트렌딩 Python 저장소
이번 달의 Python 생태계는 Claude Skills와 AI 에이전트 툴링으로 가득 차 있습니다. 이 개요에서는 GitHub의 가장 인기 있는 Python 저장소를 분석합니다.
2026년 10월 트렌딩 Go 저장소
Go 생태계는 지속적으로 번성하고 있으며, 이번 달 트렌딩 목록은 AI 에이전트 인프라 중심으로 구성되어 있습니다. 이 개요는 이번 달 GitHub의 주요 트렌딩 Go 저장소들을 분석합니다.
로컬 LLM로 Cognee 테스트 - 실제 결과
Cognee는 문서에서 지식 그래프를 구축하기 위한 Python 프레임워크입니다. 하지만 이 프레임워크는 자가 호스팅된 모델과 호환됩니까?
자체 호스팅된 Cognee를 위한 LLM에 대한 고찰
Best LLM for Cognee을 선택할 때는 그래프 생성 품질, 환상 발생 비율, 하드웨어 제약 조건 사이에서 균형을 유지해야 합니다.
Cognee는 Ollama를 통해 32B 이상의 저환상 모델을 사용하여 우수한 성능을 보입니다. 그러나 중간 규모의 모델도 가벼운 설정에 적합합니다.
Python과 Ollama를 활용한 AI 검색 에이전트 구축
Ollama의 Python 라이브러리에 이제 네이티브 Ollama 웹 검색 기능이 추가되었습니다. 몇 줄의 코드만으로 웹의 실시간 정보를 활용하여 로컬 LLM을 강화할 수 있으며, 이는 환각(hallucination)을 줄이고 정확도를 높이는 데 도움이 됩니다.
RAG 스택에 적합한 벡터 DB 를 선택하세요
올바른 벡터 저장소 를 선택하는 것은 RAG 애플리케이션의 성능, 비용 및 확장성을 결정짓는 핵심 요소입니다. 이 포괄적인 비교 자료는 2024-2025 년에 가장 인기 있는 옵션들을 다룹니다.
Go와 Ollama로 AI 검색 에이전트 만들기
Ollama의 웹 검색 API는 실시간 웹 정보를 활용하여 로컬 LLM을 보완할 수 있습니다. 이 가이드에서는 단순한 API 호출부터 전체 기능을 갖춘 검색 에이전트까지, Go에서 웹 검색 기능을 구현하는 방법을 보여드립니다.
2026년 최고의 로컬 LLM 호스팅 도구 비교. API 성숙도, 하드웨어 지원, 도구 호출 및 실전 사용 사례.
로컬에서 LLM을 실행하는 것은 이제 개발자, 스타트업, 심지어 엔터프라이즈 팀들에게도 현실적인 선택지가 되었습니다. 그러나 올바른 도구, 즉 Ollama, vLLM, LM Studio, LocalAI 또는 기타 도구를 선택하는 것은 목표에 달려 있습니다:
오픈 모델로 저비용 하드웨어에서 엔터프라이즈 AI 배포
AI 의 민주화는 이제 현실이 되었습니다. Llama, Mistral, Qwen 과 같은 오픈소스 LLM 이 독점 모델들과 경쟁할 수준에 도달함에 따라, 팀들은 소비자용 하드웨어를 활용한 AI 인프라 구축 을 통해 비용을 절감하면서도 데이터 프라이버시와 배포에 대한 완전한 통제를 유지할 수 있게 되었습니다.
LongRAG, Self-RAG, GraphRAG - 차세대 기법
검색 증강 생성 (RAG)은 단순한 벡터 유사도 검색을 훨씬 넘어 진화해 왔습니다. LongRAG, Self-RAG, GraphRAG는 이러한 기능의 최전선을 대표합니다.
지능형 토큰 최적화로 LLM 비용을 80% 절감하세요
토큰 최적화는 비용 효율적인 LLM 애플리케이션을 예산 소모 실험과 구분 짓는 핵심 기술입니다.
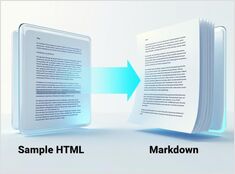
HTML을 깨끗하고 LLM에 적합한 Markdown으로 변환하는 Python
HTML을 Markdown으로 변환은 웹 콘텐츠를 대규모 언어 모델(LLM), 문서 시스템, 또는 Hugo와 같은 정적 사이트 생성기로 준비하는 현대 개발 워크플로우에서 근본적인 작업입니다. 이 가이드는 우리의 2026년 문서 도구: Markdown, LaTeX, PDF 및 인쇄 워크플로우 허브의 일부입니다.
Ollama를 Go와 통합하기: SDK 가이드, 예제 및 프로덕션 베스트 프랙티스
이 가이드에서는 Ollama용 Go SDK에 대한 포괄적인 개요를 제공하고 기능 세트를 비교합니다.