
Open WebUI: Selbstgehostete LLM-Schnittstelle
Selbstgehostete ChatGPT-Alternative für lokale LLMs
Open WebUI ist eine leistungsstarke, erweiterbare und umfangreiche selbstgehostete Web-Schnittstelle zur Interaktion mit großen Sprachmodellen.
Selbstgehostete ChatGPT-Alternative für lokale LLMs
Open WebUI ist eine leistungsstarke, erweiterbare und umfangreiche selbstgehostete Web-Schnittstelle zur Interaktion mit großen Sprachmodellen.
Schnelle LLM-Inferenz mit der OpenAI-API
vLLM ist eine hochleistungsfähige, speichereffiziente Engine für die Inferenz und Bereitstellung von großen Sprachmodellen (LLMs), entwickelt vom Sky Computing Lab der UC Berkeley.
Gedanken zu LLMs für selbstgehostete Cognee
Die Wahl des Besten LLM für Cognee erfordert das Ausbalancieren von Graph-Qualität, Halluzinationsraten und Hardware-Beschränkungen.
Cognee leistet sich besonders gut mit größeren, niedrig-halluzinierenden Modellen (32B+) über Ollama, doch mittelgroße Optionen sind für leichtere Systeme geeignet.
Vergleichen Sie die besten Tools für das lokale Hosten von LLMs im Jahr 2026. Reife der API, Hardware-Support, Tool-Calling und reale Anwendungsfälle.
Das lokale Ausführen von LLMs ist nun auch für Entwickler, Startups und sogar Enterprise-Teams praktikabel.
Doch die Wahl des richtigen Tools – Ollama, vLLM, LM Studio, LocalAI oder andere – hängt von Ihren Zielen ab:
„Kontextgrößen im Docker Model Runner konfigurieren mit Umgehungsmöglichkeiten“
Einrichten von Kontextgrößen im Docker Model Runner ist komplexer, als es sein sollte.
GPU-Beschleunigung für Docker Model Runner mit NVIDIA CUDA-Unterstützung aktivieren
Docker Model Runner ist das offizielle Tool von Docker, um KI-Modelle lokal zu verwenden, aber GPU-Beschleunigung mit NVidia in Docker Model Runner erfordert eine spezifische Konfiguration.
Schnellreferenz für Docker Model Runner-Befehle
Docker Model Runner (DMR) ist Docks offizielle Lösung zur lokalen Ausführung von KI-Modellen, eingeführt im April 2025. Dieses Cheat Sheet bietet eine schnelle Referenz für alle wesentlichen Befehle, Konfigurationen und Best Practices.
Vergleichen Sie Docker Model Runner und Ollama für lokale LLM
Große Sprachmodelle (LLMs) lokal ausführen wird zunehmend beliebt, um den Schutz der Privatsphäre, den Kostenkontroll und die Offline-Fähigkeiten zu gewährleisten. Der Markt hat sich im April 2025 deutlich verändert, als Docker Docker Model Runner (DMR) eingeführt hat, seine offizielle Lösung zur Bereitstellung von KI-Modellen.
Ollama mit Go integrieren: SDK-Anleitung, Beispiele und bewährte Methoden für die Produktion.
Dieser Leitfaden bietet einen umfassenden Überblick über die verfügbaren Go SDKs für Ollama und vergleicht ihre Funktionsumfänge.
+ Konkrete Beispiele mit dem Einsatz von Think-LLMs
In diesem Beitrag untersuchen wir zwei Möglichkeiten, Ihre Python-Anwendung mit Ollama zu verbinden: 1. Über die HTTP REST API; 2. Über die offizielle Ollama Python-Bibliothek.
Meine Sicht auf den aktuellen Entwicklungsstand von Ollama
Ollama ist schnell zu einem der beliebtesten Tools für den lokalen Betrieb von LLMs geworden. Sein einfaches CLI und das durchdachte Modell-Management haben es zu einer ersten Wahl für Entwickler gemacht, die mit KI-Modellen außerhalb der Cloud arbeiten möchten.
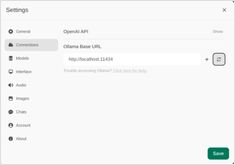
Schneller Überblick über die wichtigsten UIs für Ollama im Jahr 2025
Locally gehostete Ollama ermöglicht es, große Sprachmodelle auf Ihrem eigenen Gerät auszuführen, aber die Verwendung über die Befehlszeile ist nicht benutzerfreundlich. Hier sind mehrere Open-Source-Projekte, die ChatGPT-ähnliche Schnittstellen bereitstellen, die mit einer lokalen Ollama verbunden sind.
qwen3 8b, 14b und 30b, devstral 24b, mistral small 24b
In diesem Test vergleiche ich, wie verschiedene LLMs, die auf Ollama gehostet werden, Hugo- Seiten von englisch auf deutsch übersetzen.
Kurze Liste von LLM-Anbietern
Die Verwendung von LLMs ist nicht sehr teuer, es könnte kein Bedarf bestehen, neue, unglaublich leistungsstarke GPUs zu kaufen.
Hier ist eine Liste der LLM-Anbieter in der Cloud mit den LLMs, die sie hosten.
Vergleich zweier deepseek-r1-Modelle mit zwei Basismodellen
DeepSeek’s erste Generation von Reasoning-Modellen mit Leistungen, die vergleichbar sind mit OpenAI-o1, einschließlich sechs dichter Modelle, die aus DeepSeek-R1 basierend auf Llama und Qwen destilliert wurden.

Aktualisierte Ollama-Befehlsliste - ls, ps, run, serve usw.
Dieses Ollama-CLI-Cheatsheet konzentriert sich auf die Befehle, die Sie täglich verwenden (ollama ls, ollama serve, ollama run, ollama ps, Modellverwaltung und gängige Workflows), mit Beispielen, die Sie kopieren und einfügen können.