Llm

Ollama와 vLLM, LM Studio: 2026년 로컬 LLM 실행의 최선의 방법은?

Ollama와 vLLM, LM Studio: 2026년 로컬 LLM 실행의 최선의 방법은?

2026년 최고의 로컬 LLM 호스팅 도구 비교. API 성숙도, 하드웨어 지원, 도구 호출 및 실전 사용 사례.

로컬에서 LLM을 실행하는 것은 이제 개발자, 스타트업, 심지어 엔터프라이즈 팀들에게도 현실적인 선택지가 되었습니다. 그러나 올바른 도구, 즉 Ollama, vLLM, LM Studio, LocalAI 또는 기타 도구를 선택하는 것은 목표에 달려 있습니다:
AI/ML 오케스트레이션을 위한 Go 마이크로서비스

AI/ML 오케스트레이션을 위한 Go 마이크로서비스

Go 마이크로서비스로 강력한 AI/ML 파이프라인 구축하기

AI 및 ML 워크로드가 점차 복잡해짐에 따라, 강력한 오케스트레이션(Orchestration) 시스템에 대한 필요성이 커지고 있습니다. Go의 단순성, 성능, 그리고 동시성 처리 능력은 모델 자체가 Python으로 작성된 경우에도 ML 파이프라인의 오케스트레이션 레이어를 구축하는 데 이상적인 선택지로 자리 잡고 있습니다.

소비자용 하드웨어를 활용한 AI 인프라

소비자용 하드웨어를 활용한 AI 인프라

오픈 모델로 저비용 하드웨어에서 엔터프라이즈 AI 배포

AI 의 민주화는 이제 현실이 되었습니다. Llama, Mistral, Qwen 과 같은 오픈소스 LLM 이 독점 모델들과 경쟁할 수준에 도달함에 따라, 팀들은 소비자용 하드웨어를 활용한 AI 인프라 구축 을 통해 비용을 절감하면서도 데이터 프라이버시와 배포에 대한 완전한 통제를 유지할 수 있게 되었습니다.

Python에서 FLUX.1-dev GGUF Q8 실행

Python에서 FLUX.1-dev GGUF Q8 실행

GGUF 양자화로 FLUX.1-dev 가속화

FLUX.1-dev 은 텍스트에서 이미지를 생성하는 강력한 모델로, 놀라운 결과를 제공하지만 24GB 이상의 메모리 요구 사항으로 인해 많은 시스템에서 실행하기 어렵습니다. GGUF quantization of FLUX.1-dev 은 메모리 사용량을 약 50% 줄이며 우수한 이미지 품질을 유지하는 해결책을 제공합니다.

파이썬으로 HTML을 Markdown으로 변환하는 방법: 포괄적인 가이드

파이썬으로 HTML을 Markdown으로 변환하는 방법: 포괄적인 가이드

HTML을 깨끗하고 LLM에 적합한 Markdown으로 변환하는 Python

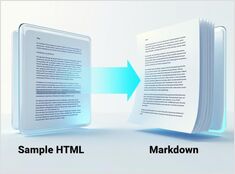
HTML을 Markdown으로 변환은 웹 콘텐츠를 대규모 언어 모델(LLM), 문서 시스템, 또는 Hugo와 같은 정적 사이트 생성기로 준비하는 현대 개발 워크플로우에서 근본적인 작업입니다. 이 가이드는 우리의 2026년 문서 도구: Markdown, LaTeX, PDF 및 인쇄 워크플로우 허브의 일부입니다.

LLM ASIC 및 전용 추론 칩(왜 중요한가)

LLM ASIC 및 전용 추론 칩(왜 중요한가)

ASIC과 맞춤형 실리콘은 LLM 추론 속도와 효율성을 높입니다

AI의 미래는 단순히 더 스마트한 모델에 관한 것이 아닙니다. 동시에, 이러한 모델이 실제로 서빙되는 방식에 부합하는 실리콘 기술에 관한 것이기도 합니다. LLM 추론을 위한 전용 하드웨어는 비트코인 마이닝이 GPU에서 목적론적 ASIC로 이동했던 경로를 떠올리게 하며, 모델과 정밀도 레시피가 계속 진화하기 때문에 더 어려운 제약 사항이 따릅니다.