AI Coding

Entscheidungsprotokolle für KI-gesteuerte Softwareentwicklung

Entscheidungsprotokolle für KI-gesteuerte Softwareentwicklung

„Halten Sie die Intention nahe am Code.“

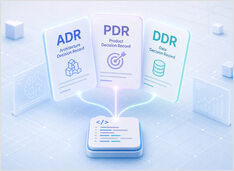
Entscheidungsprotokolle sind die fehlende Speicherschicht in der KI-gestützten Softwareentwicklung. Sie erfassen nicht nur das, was gebaut wurde, sondern auch das Warum – und diese Unterscheidung wird entscheidend, wenn KI-Tools Ihren Code schreiben.
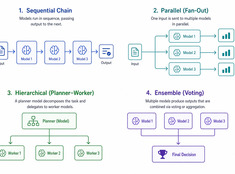
Systemdesign mehrerer Modelle: Wenn ein Modell nicht ausreicht

Systemdesign mehrerer Modelle: Wenn ein Modell nicht ausreicht

Wählen Sie das einfachste Muster, das funktioniert.

Einzelsystemen mit einem einzigen Modell sind einfach. Mehrfachmodell-Systeme sind leistungsstark. Die Herausforderung besteht nicht darin, Modelle auszuwählen, sondern darin, die Architektur zu gestalten, die sie orchestriert.

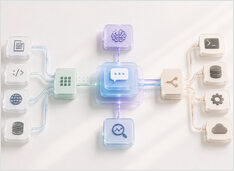
Architektur von KI-Assistenten: LLM, Memory, Tools, Routing, Observability

Architektur von KI-Assistenten: LLM, Memory, Tools, Routing, Observability

Wie ernsthafte Assistenten tatsächlich aufgebaut sind.

Ein produktionsreifes KI-Assistenzsystem ist nicht „ein LLM mit einem Prompt“. Es ist ein System, das Absicht akzeptiert, Zustand behält, entscheidet, wann es Informationen abrufen oder Aktionen ausführen soll, und genügend Laufzeitdetails offenlegt, um Fehlfunktionen zu debuggen.

Strukturierte Ausgabevalidierung von LLMs in Python, die standhält

Strukturierte Ausgabevalidierung von LLMs in Python, die standhält

Hören Sie auf, auf Vibes zu vertrauen. Validieren Sie Verträge.

Die meisten Tutorials zu „strukturierten Ausgaben“ von LLMs sind wenig ernst gemeint. Sie lehren Sie, höflich um JSON zu bitten und darauf zu hoffen, dass das Modell sich entsprechend verhält. Das ist keine Validierung. Das ist Optimismus mit geschweiften Klammern.

llama.swap Modellumschalter: Schnelleinstieg für OpenAI-kompatible lokale LLMs

llama.swap Modellumschalter: Schnelleinstieg für OpenAI-kompatible lokale LLMs

Lokale LLMs per Hot-Swap austauschen, ohne die Clients anzupassen.

Bald jonglierst du mit vLLM, llama.cpp und weiteren – jeder Stack auf seinem eigenen Port. Alles, was downstream liegt, erwartet weiterhin eine einzige /v1-Basis-URL; andernfalls musst du ständig Ports, Profile und Einmalskripte umstellen. llama-swap ist die /v1-Proxy-Schicht vor diesen Stacks.