Ai

Ollama vs. vLLM vs. LM Studio: Bester Weg, LLMs lokal auszuführen (2026)?

Ollama vs. vLLM vs. LM Studio: Bester Weg, LLMs lokal auszuführen (2026)?

Vergleichen Sie die besten Tools für das lokale Hosten von LLMs im Jahr 2026. Reife der API, Hardware-Support, Tool-Calling und reale Anwendungsfälle.

Das lokale Ausführen von LLMs ist nun auch für Entwickler, Startups und sogar Enterprise-Teams praktikabel.
Doch die Wahl des richtigen Tools – Ollama, vLLM, LM Studio, LocalAI oder andere – hängt von Ihren Zielen ab:
KI-Infrastruktur auf Consumer-Hardware

KI-Infrastruktur auf Consumer-Hardware

Bereitstellung von Enterprise-KI auf kostengünstiger Hardware mit Open-Modellen

Die Demokratisierung der KI ist da. Mit Open-Source-LLMs wie Llama, Mistral und Qwen, die nun proprietäre Modelle herausfordern, können Teams eine leistungsstarke KI-Infrastruktur mit Consumer-Hardware aufbauen – und dabei die Kosten drastisch senken, während sie die vollständige Kontrolle über Datenschutz und Bereitstellung behalten.

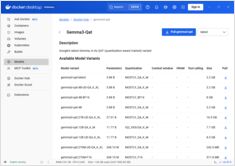
FLUX.1-dev mit GGUF Q8 ausführen

FLUX.1-dev mit GGUF Q8 ausführen

Beschleunigen Sie FLUX.1-dev mit GGUF-Quantisierung

FLUX.1-dev ist ein leistungsstarkes Text-zu-Bild-Modell, das beeindruckende Ergebnisse liefert, aber dessen Speicherbedarf von über 24GB die Nutzung auf vielen Systemen erschwert. GGUF-Quantisierung von FLUX.1-dev bietet eine Lösung, indem sie den Speicherbedarf um etwa 50% reduziert, während die Bildqualität erhalten bleibt.

Immich selbst hosten: Private Fotowolke

Immich selbst hosten: Private Fotowolke

Ihre Fotos auf selbstgehostetem KI-gestütztem Backup

Immich ist eine revolutionäre Open-Source-Lösung für die selbstgehostete Verwaltung von Fotos und Videos, die Ihnen die vollständige Kontrolle über Ihre Erinnerungen gibt. Mit Funktionen, die denen von Google Photos in nichts nachstehen – einschließlich KI-gestützter Gesichtserkennung, intelligenter Suche und automatischer Mobilgeräte-Sicherung – und dabei Ihre Daten privat und sicher auf Ihrem eigenen Server halten.

LLM-ASICs und spezialisierte Inferenz-Chips (weshalb sie wichtig sind)

LLM-ASICs und spezialisierte Inferenz-Chips (weshalb sie wichtig sind)

ASICs und maßgeschneiderte Chips steigern die Geschwindigkeit und Effizienz der LLM-Inferenz

Die Zukunft der KI dreht sich nicht nur um intelligentere Modelle. Es geht auch um Silizium, das dazu passt, wie diese Modelle tatsächlich bereitgestellt werden. Spezialisierte Hardware für LLM-Inferenz folgt einem Weg, der an den Übergang beim Bitcoin-Mining von GPUs zu zweckgebauten ASICs erinnert, nur mit härteren Einschränkungen, da sich Modelle und Präzisionsverfahren ständig weiterentwickeln.