Llm

KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

KV-Cache auf 16-GB-GPUs: Lange Kontexte wirklich unterbringen

Warum 128K Kontext auf 16 GB scheitert

Ein Modell kann einen 128K-Kontextfenster bewerben und trotzdem bei 40K Tokens auf einer 16-GB-GPU scheitern. Die architektonische Obergrenze hat nie versprochen, dass Modellgewichte, KV-Cache, Rechenspeicher und der Desktop-Compositor gleichzeitig auf Ihrer Grafikkarte Platz finden würden.
Was kommt nach LLMs? Mamba, Diffusion und Weltmodelle

Was kommt nach LLMs? Mamba, Diffusion und Weltmodelle

Was kommt nach LLMs? Das post-Transformer-Zeitalter.

Der KI-Hype folgt einem Rhythmus: ungefähr alle drei Jahre wird die Architektur, auf die alle setzen, durch eine neuere ersetzt. Die nächste Änderung formiert sich bereits in den Forschungslaboren.

Superpowers Quickstart: Installation, Workflow und Test

Superpowers Quickstart: Installation, Workflow und Test

Erzwungene SDD-Fähigkeiten, installiert mit einem einzigen Befehl.

Superpowers bündelt eine vollständige, spec-gesteuerte Methodik in installierbare Claude-Skills und erzwingt Brainstorming, Planung, subagentenbasierte Implementierung und striktes TDD (Testgetriebene Entwicklung), anstatt diese Struktur der freien Gestaltung zu überlassen.

Pi Coding Agent im Test: Minimale, anpassbare KI-CLI zum Programmieren

Pi Coding Agent im Test: Minimale, anpassbare KI-CLI zum Programmieren

Ein kleiner Coding-Agent, der darauf ausgelegt ist, von Ihnen geformt zu werden.

Pi Coding Agent ist ein minimalistisches, quelloffenes Terminal-Coding-Harness, das mit vier Standard-Tools ausgeliefert wird und das meiste Verhalten an Erweiterungen, Skills und Ihren eigenen Workflow überlässt.

Datengravitation: Die echten Kosten der API-first-KI

Datengravitation: Die echten Kosten der API-first-KI

Warum Ihr KI-Stack jeden Monat klebriger wird.

Jeder API-Aufruf fühlt sich wie eine simple Transaktion an – bis genug von ihnen akkumuliert sind, sodass Ihre Feinabstimmungsdaten, Bewertungsumgebungen und Tool-Schemata alle um einen einzigen Anbieter herum geformt werden, und der Wechsel keine bloße Routing-Änderung mehr ist.

Claude Code Subagenten: Einrichtung, Konfiguration und Einsatzszenarien

Claude Code Subagenten: Einrichtung, Konfiguration und Einsatzszenarien

Delegieren Sie die lärmintensive Arbeit und halten Sie Ihren Kontext sauber.

Die meisten Claude Code-Sitzungen werden aus demselben Grund langsam und unübersichtlich: Jeder explorative Grep-Durchlauf, jeder Log-Dump und jedes „Ich checke noch eine Datei“ bleibt für immer im Hauptchatverlauf stehen.

Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

Ollama zu vLLM: Wann Sie Ihren lokalen LLM-Server migrieren sollten

Wann von Ollama auf vLLM wechseln

Ollama ist einer der einfachsten Wege, ein lokales Sprachmodell auszuführen, aber die Bequemlichkeit kann den Moment verbergen, in dem ein lokales Experiment zu einem gemeinsamen Inferenzdienst wird, der eine bessere Planung und Beobachtbarkeit benötigt.

Specs, Tests und Code in der KI-Entwicklung synchron halten

Specs, Tests und Code in der KI-Entwicklung synchron halten

Verhindern Sie, dass KI-Agenten von den Spezifikationen, Tests und dem Code abweichen.

KI-Coding-Agenten liefern Features schnell, aber Spezifikationen, Tests und Code veralten stillschweigend und gehen auseinander. Dieser Leitfaden behandelt ein Nachverfolgungsmodell (Traceability), die Zuordnung von Spezifikation zu Test und von Spezifikation zu Code sowie die CI-Prüfungen, die Abweichungen vor einem Merge erkennen.

GPUs für KI im Jahr 2026: NVIDIA, AMD und Intel im Vergleich

GPUs für KI im Jahr 2026: NVIDIA, AMD und Intel im Vergleich

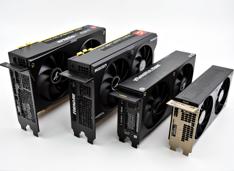
Vergleich von AI-GPUs dreier Anbieter

Die Landschaft der KI-Hardware hat sich 2026 erheblich verändert. NVIDIA, AMD und Intel konkurrieren alle um Entwickler, die GPUs benötigen, die in der Lage sind, lokale Large Language Models (LLMs) und KI-Inferenz-Arbeitslasten auszuführen.

Sicherheit von A2A- und MCP-Agenten: Identität, Delegation und Audit-Trails

Sicherheit von A2A- und MCP-Agenten: Identität, Delegation und Audit-Trails

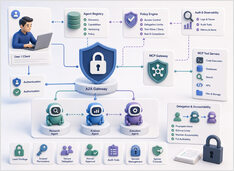
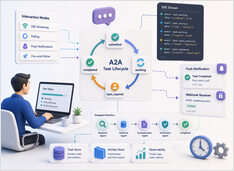
Protokollsicherheit definiert, wer handeln darf, nicht das Modell.

Prompt-Injection erhält den größten Teil der Aufmerksamkeit im Bereich der Sicherheit von LLM-Systemen, und das zu Recht, aber sie ist nicht das einzige Problem, sobald Agenten beginnen, Tools aufzurufen und Arbeit an andere Agenten zu delegieren.

Spekulatives Dekodieren: 20–50 % schnellere LLM-Inferenz

Spekulatives Dekodieren: 20–50 % schnellere LLM-Inferenz

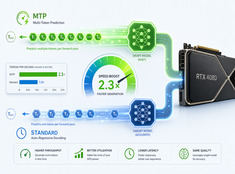
Schnellere LLM-Inferenz ohne Qualitätsverlust – Ein praktischer Leitfaden

Ein 70B-Modell erzeugt pro Vorwärtsdurchlauf ein einzelnes Token, wobei jeder Durchlauf Gewichte aus dem VRAM neu lädt, die Aufmerksamkeit über den gesamten Kontext berechnet und den Speicher synchronisiert. Zwischen den Tokens verbringt die GPU Zeit im Leerlauf, während sie darauf wartet, dass sequenzielle Abhängigkeiten aufgelöst werden.