
Das Google A2A-Protokoll 2026: Adoption, Hype und Realität
A2A ist nicht tot. Es ist einfach nicht universell.
Googles Agent2Agent-Protokoll, meist als A2A abgekürzt, hatte ein seltsames erstes Jahr.
A2A ist nicht tot. Es ist einfach nicht universell.
Googles Agent2Agent-Protokoll, meist als A2A abgekürzt, hatte ein seltsames erstes Jahr.
Zuverlässige Polling-Muster für KI-Agenten.
Polling-Agenten gehören zu den wenig glamourösen Aspekten der Architektur von KI-Assistenten, sind jedoch gleichzeitig eine der nützlichsten Komponenten.
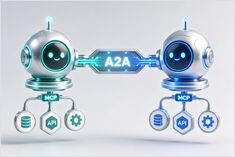
MCP gibt Agenten Werkzeuge. A2A gibt Agenten Peers.
Die Architektur von KI-Agenten beginnt sich in zwei Schichten zu gliedern.
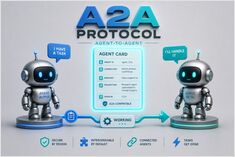
A2A macht Agents zu Netzwerkpeers.
Das A2A-Protokoll (Agent2Agent Protocol) ist ein offener Standard für die Kommunikation zwischen unabhängigen KI-Agenten-Systemen.
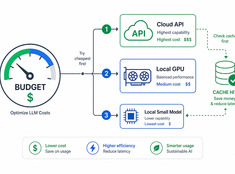
Setze Token gezielt dort ein, wo es wirklich zählt.
LLM-Kosten skalieren linear mit der Nutzung. Ein System, das 10.000 Anfragen pro Tag zu 0,01 USD pro Anfrage verarbeitet, kostet 100 USD täglich – 365 USD pro Jahr. Im Unternehmensumfeld belaufen sich diese Kosten auf über 10.000 USD.
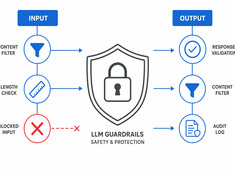
Kontrollieren Sie das Risiko, nicht nur das Modell.
LLMs sind unvorhersehbar. Sie halluzinieren, lecken Daten, generieren schädliche Inhalte oder lehnen legitime Anfragen ab. Guardrails (Schutzmechanismen) begrenzen das Modellverhalten, ohne die Fähigkeiten einzuschränken.
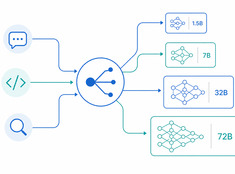
Das richtige Modell für die richtige Aufgabe.
Ein Modell mit 70 Milliarden Parametern für die Zusammenfassung einer 200-Wörter-E-Mail einzusetzen, ist verschwenderisch. Ein 3-Milliarden-Modell zur Überprüfung von Produktionscode einzusetzen, ist fahrlässig. Die meisten Systeme bewegen sich irgendwo dazwischen – und genau hier setzt Modell-Routing an.
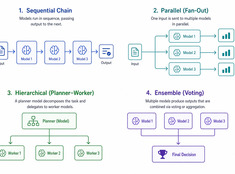
Wählen Sie das einfachste Muster, das funktioniert.
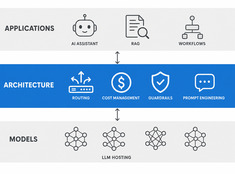
Einzelsystemen mit einem einzigen Modell sind einfach. Mehrfachmodell-Systeme sind leistungsstark. Die Herausforderung besteht nicht darin, Modelle auszuwählen, sondern darin, die Architektur zu gestalten, die sie orchestriert.
Arbeits-, strukturiertes und Abrufgedächtnis für Assistenten.
Speicher wandelt Assistenten von reaktiv in persistent um, aber genau dort verrotten auch viele Systeme still vor sich hin. Umfragen zeigen, dass die Trennung in Kurzzeit- und Langzeitgedächtnis für modernes Agenten-Gedächtnis nicht mehr ausreicht; OpenAI und LangGraph-SDKs deuten auf einen simpleren Stack hin — Arbeitsgedächtnis, dauerhafter Zustand und Abruf (Retrieval).
Wie ernsthafte Assistenten tatsächlich aufgebaut sind.
Ein produktionsreifes KI-Assistenzsystem ist nicht „ein LLM mit einem Prompt“. Es ist ein System, das Absicht akzeptiert, Zustand behält, entscheidet, wann es Informationen abrufen oder Aktionen ausführen soll, und genügend Laufzeitdetails offenlegt, um Fehlfunktionen zu debuggen.
KI verändert das Wissensmanagement, nicht seinen Zweck.
KI ersetzt nicht das Wissensmanagement; sie verändert dessen Gestalt für Einzelpersonen und Teams gleichermaßen.
Sterne, Tokens, Downloads – wer gewinnt wirklich?
Open-Source-KI-Agent-Frameworks erleben auf GitHub einen rasanten Popularitätsanstieg. Zwei Projekte im Kern des Ökosystems für self-hosted KI-Systeme — OpenClaw und Hermes Agent — haben einen solchen Vorsprung herausgearbeitet, dass der Rest des Feldes um einen weit entfernten dritten Platz kämpft.
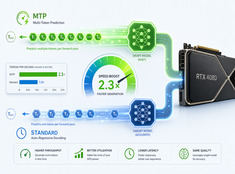
MTP vs. Standard-Decoding auf der RTX 4080 – echte Benchmarks
Ich habe die Leistung des spekulativen Dekodierens (Multi-Token Prediction, MTP) in Qwen 3.6 27B und 35B auf einer RTX 4080 mit 16 GB VRAM getestet.
Kostenfreier VRAM, ohne den llama-server zu beenden.
llama.cpp Router-Modus ist eine der nützlichsten Änderungen an llama-server in den letzten Jahren. Er gibt lokalen LLM-Betreibern endlich etwas, das dem Modellmanagement-Erlebnis ähnelt, das man von Ollama erwartet, während er die rohe Leistung und die niedrige Kontrollstufe beibehält, die llama.cpp überhaupt erst interessant machen.
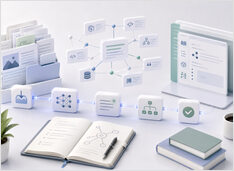
Kompiliertes Wissen für KI-Systeme
Die Prämisse ist einfach: Kompiliertes Wissen ist wiederverwertbarer als abgerufene Fragmente. RAG wurde zur Standardantwort auf eine einfache Frage – wie gewähre ich einem LLM Zugriff auf externes Wissen?