Lernen Sie Sisyphus und sein Team spezialisierten Agenten kennen.
Der größte Sprung in den Fähigkeiten von OpenCode stammt von spezialisierten Agenten: einer bewussten Trennung von Orchestrierung, Planung, Ausführung und Recherche.
Installieren Sie Oh My Opencode und liefern Sie schneller aus.
Oh My Opencode verwandelt OpenCode in einen Multi-Agent-Coding-Rahmen: Ein Orchestrator delegiert Aufgaben an spezialisierte Agenten, die parallel arbeiten.
OpenCode LLM-Test — Statistiken zu Codierung und Genauigkeit
Ich habe getestet, wie sich OpenCode mit mehreren lokal auf Ollama und llama.cpp gehosteten LLMs verhält, und habe zum Vergleich einige kostenlose Modelle von OpenCode Zen hinzugefügt.
OpenHands ist ein Open-Source-Coding-Agent, der Dateien bearbeitet und Befehle in einer Sandbox ausführt. Dieser CLI-Schnellstart wurde am 26.10.2026 anhand des Pakets 1.16.0 überprüft.
Bereitstellen von OpenAI-kompatiblen APIs mit LocalAI in wenigen Minuten auf dem eigenen Server.
LocalAI ist ein selbstgehosteter, lokal-first Inferenzserver, der sich wie eine Drop-in OpenAI API verhält, um KI-Arbeitslasten auf Ihrer eigenen Hardware (Laptop, Workstation oder lokaler Server) auszuführen.
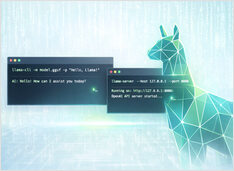
llama.cpp ist eine C/C++-Inferenz-Engine für GGUF-Modelle: llama-cli für interaktive Chats, llama-completion für skriptgesteuerte Prompts und llama-server für eine OpenAI-kompatible HTTP-API.
Künstliche Intelligenz verändert grundlegend, wie Software entwickelt, überprüft, deployed und gewartet wird. Von KI-gesteuerten Coding-Assistenten über GitOps-Automatisierung bis hin zu DevOps-Workflows verlassen sich Entwickler heute auf KI-gestützte Tools über den gesamten Software-Lebenszyklus hinweg.
So installieren, konfigurieren und verwenden Sie OpenCode
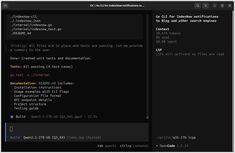
OpenCode ist ein quelloffener KI-Coding-Agent, den Sie in der Terminalumgebung (TUI + CLI) ausführen können, mit optionalen Oberflächen für Desktop und IDE. Dies ist der OpenCode Quickstart: Installation, Verifikation, Verbindung eines Modells/Anbieters und Ausführung echter Workflows (CLI + API).
LLM-Inferenz sieht aus wie „nur eine weitere API" – bis die Latenzspitzen auftreten, Warteschlangen sich stauen und Ihre GPUs eine Speichernutzung von 95 % haben, ohne dass eine offensichtliche Erklärung dafür vorhanden ist.
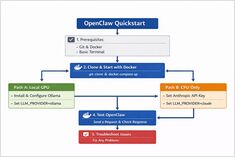
OpenClaw ist ein selbst gehosteter KI-Assistent, der mit lokalen LLM-Runtimes wie Ollama oder mit cloudbasierten Modellen wie Claude Sonnet ausgeführt werden kann.
Temporal ist ein Open-Source-Workflow-Engine für den Enterprise-Einsatz, die es Entwicklern ermöglicht, langlebige, skalierbare und fehlerresistente Workflow-Anwendungen mit bekannten Programmiersprachen wie Go zu entwickeln.
End-to-End-Beobachtbarkeitsstrategie für LLM-Inferenz und LLM-Anwendungen
LLM-Systeme versagen auf Arten, die herkömmliches API-Monitoring nicht aufdecken kann – Warteschlangen füllen sich stillschweigend, der GPU-Speicher sättigt lange bevor die CPU ausgelastet wirkt, und die Latenz steigt im Batching-Layer an, nicht im Anwendungslayer.
Metriken, Dashboards, Logs und Alerting für Produktionssysteme – Prometheus, Grafana, Kubernetes und KI-Workloads.
Beobachtbarkeit ist das Fundament zuverlässiger Produktionsumgebungen.
Ohne Metriken, Dashboards und Alarmierung treiben Kubernetes-Cluster unbeobachtet umher, KI-Workloads fallen still aus und Latenzverschlechterungen werden übersehen, bis Benutzer sich beschweren.
Von Basis-RAG bis zur Produktion: Chunking, Vektorsuche, Reranking und Evaluation in einem Leitfaden.
Production-focused guide to building RAG systems: chunking, vector stores, hybrid retrieval, reranking, evaluation, and when to choose RAG over fine-tuning.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.