
OpenClaw-Produktionskonfigurationen mit Plugins und Skills
Wie reale OpenClaw-Systeme tatsächlich strukturiert sind
OpenClaw wirkt in Demos einfach. In der Produktion wird es zu einem System.
Wie reale OpenClaw-Systeme tatsächlich strukturiert sind
OpenClaw wirkt in Demos einfach. In der Produktion wird es zu einem System.
Claude-Abos versorgen Agenten nicht länger
Die ruhige Lücke, die eine Welle an Experimenten mit Agenten antrieb, ist nun geschlossen.
Selbst gehostete KI-Suche mit lokalen LLMs
Vane ist einer der pragmatischeren Vertreter im Bereich „KI-Suche mit Quellenangaben": eine selbst gehostete Antwort-Engine, die die Live-Webrecherche mit lokalen oder Cloud-LLMs kombiniert, während der gesamte Stack unter Ihrer Kontrolle bleibt.
Agentic Coding, jetzt mit lokalen Modell-Backends.
Claude Code ist nicht einfach nur Autovervollständigung mit besserem Marketing. Es ist ein agentenbasiertes Coding-Tool: Es liest Ihre Codebasis, editiert Dateien, führt Befehle aus und integriert sich in Ihre Entwicklungstools.
Hermes-Agent: Installation und Schnellstart für Entwickler
Hermes Agent ist ein selbst gehosteter, modell-agnostischer KI-Assistent, der auf einem lokalen Rechner oder einem kostengünstigen VPS läuft, über Terminal- und Messaging-Schnittstellen arbeitet und mit der Zeit besser wird, indem er wiederkehrende Aufgaben in wiederverwendbare Skills umwandelt.
Installiere TGI, schieß schnell ab, debugge noch schneller.
Text Generation Inference (TGI) hat eine sehr spezifische Energie. Es ist nicht das neueste Kind auf der Inferenz-Straße, aber es ist dasjenige, das bereits gelernt hat, wie Produktion funktioniert –
Token-Geschwindigkeit von llama.cpp auf 16 GB VRAM (Tabellen).
Hier vergleiche ich die Geschwindigkeit mehrerer LLMs, die auf einer GPU mit 16 GB VRAM laufen, und wähle die beste Option für das Selbst-Hosting aus.
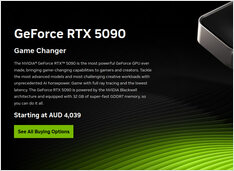
Die RTX 5090 ist in Australien knapp und überhöht im Preis.
Australien verfügt über RTX 5090-Lagerbestände. Kaum. Und wenn Sie eine finden, zahlen Sie einen Aufpreis, der sich von der Realität zu lösen scheint.
Remote-Zugriff auf Ollama ohne öffentliche Ports
Ollama ist am glücklichsten, wenn es wie ein lokaler Daemon behandelt wird: Die CLI und Ihre Apps kommunizieren mit einer Loopback-HTTP-API, und der Rest des Netzwerks erfährt nie von ihrer Existenz.
Compose-first Ollama-Server mit GPU und Persistenz.
Ollama läuft hervorragend auf Bare-Metal-Systemen. Es wird noch interessanter, wenn man es wie einen Dienst behandelt: mit einem stabilen Endpunkt, festgelegten Versionen, persistentem Speicher und einer GPU, die entweder verfügbar ist oder eben nicht.
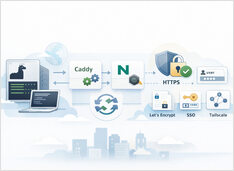
HTTPS mit Ollama, ohne die Streaming-Antworten zu beeinträchtigen.
Das Betreiben von Ollama hinter einem Reverse-Proxy ist der einfachste Weg, HTTPS, optionale Zugriffskontrolle und ein vorhersagbares Streaming-Verhalten zu erhalten.
RAG-Einbettungen – Python, Ollama, OpenAI-APIs.
Wenn Sie sich mit retrieval-augmented generation (RAG) beschäftigen, führt dieser Abschnitt Sie in einfachen Worten durch Text-Embeddings – was sie sind, wie sie in Suche und Abruf passen und wie man zwei gängige lokale Setups von Python aus mit Ollama oder einer OpenAI-kompatiblen HTTP-API aufruft (wie sie von vielen llama.cpp-basierten Servern bereitgestellt werden).
Dienen Sie Open-Modelle schnell mit SGLang.
SGLang ist ein leistungsfähiges Bereitstellungsframework für große Sprachmodelle und multimodale Modelle, das entwickelt wurde, um Inferenz mit geringer Latenz und hohem Durchsatz von einzelnen GPUs bis hin zu verteilten Clustern zu ermöglichen.
Lokale LLMs per Hot-Swap austauschen, ohne die Clients anzupassen.
Bald jonglierst du mit vLLM, llama.cpp und weiteren – jeder Stack auf seinem eigenen Port. Alles, was downstream liegt, erwartet weiterhin eine einzige /v1-Basis-URL; andernfalls musst du ständig Ports, Profile und Einmalskripte umstellen. llama-swap ist die /v1-Proxy-Schicht vor diesen Stacks.
Die meisten lokalen KI-Setups beginnen mit einem Modell und einer Laufzeitumgebung.
Was genau passiert, wenn Sie Ultrawork ausführen?
Oh My Opencode verspricht ein „virtuelles KI-Entwicklerteam" — Sisyphus dirigiert Spezialisten, Aufgaben werden parallel ausgeführt und das magische Schlüsselwort ultrawork aktiviert alles.