Lernen Sie Sisyphus und sein Team spezialisierten Agenten kennen.
Der größte Sprung in den Fähigkeiten von OpenCode stammt von spezialisierten Agenten: einer bewussten Trennung von Orchestrierung, Planung, Ausführung und Recherche.
Installieren Sie Oh My Opencode und liefern Sie schneller aus.
Oh My Opencode verwandelt OpenCode in einen Multi-Agent-Coding-Rahmen: Ein Orchestrator delegiert Aufgaben an spezialisierte Agenten, die parallel arbeiten.
OpenCode LLM-Test — Statistiken zu Codierung und Genauigkeit
Ich habe getestet, wie sich OpenCode mit mehreren lokal auf Ollama und llama.cpp gehosteten LLMs verhält, und habe zum Vergleich einige kostenlose Modelle von OpenCode Zen hinzugefügt.
OpenHands ist ein Open-Source-Coding-Agent, der Dateien bearbeitet und Befehle in einer Sandbox ausführt. Dieser CLI-Schnellstart wurde am 26.10.2026 anhand des Pakets 1.16.0 überprüft.
Bereitstellen von OpenAI-kompatiblen APIs mit LocalAI in wenigen Minuten auf dem eigenen Server.
LocalAI ist ein selbstgehosteter, lokal-first Inferenzserver, der sich wie eine Drop-in OpenAI API verhält, um KI-Arbeitslasten auf Ihrer eigenen Hardware (Laptop, Workstation oder lokaler Server) auszuführen.
LLM-Inferenz sieht aus wie „nur eine weitere API" – bis die Latenzspitzen auftreten, Warteschlangen sich stauen und Ihre GPUs eine Speichernutzung von 95 % haben, ohne dass eine offensichtliche Erklärung dafür vorhanden ist.
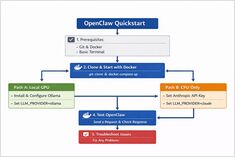
OpenClaw ist ein selbst gehosteter KI-Assistent, der mit lokalen LLM-Runtimes wie Ollama oder mit cloudbasierten Modellen wie Claude Sonnet ausgeführt werden kann.
AWS S3, Garage oder MinIO – Übersicht und Vergleich.
AWS S3 bleibt die „Standard“-Referenz für Objektspeicher: Es ist voll verwaltet, stark konsistent und für eine extrem hohe Haltbarkeit und Verfügbarkeit ausgelegt.
Garage und MinIO sind selbst gehostete, S3-kompatible Alternativen: Garage ist für leichte, geografisch verteilte kleine bis mittelgroße Cluster konzipiert, während MinIO einen breiten Abdeckungsbereich der S3-API und hohe Leistungsfähigkeit in größeren Bereitstellungen betont.
Garage ist ein quelloffenes, selbstgehostetes, S3-kompatibles Objekt-Speichersystem, das für kleine bis mittlere Bereitstellungen konzipiert wurde, mit einem starken Fokus auf Ausfallsicherheit und geografische Verteilung.
Strategic guide to hosting large language models locally with Ollama, llama.cpp, vLLM, or in the cloud. Compare tools, performance trade-offs, and cost considerations.
Daten und Modelle mit selbst gehosteten LLMs kontrollieren
Das Selbst-Hosting von LLMs hält Daten, Modelle und Inferenzen unter Ihrer Kontrolle – ein praktischer Weg zur AI Sovereignty für Teams, Unternehmen und Nationen.
LLM-Geschwindigkeitstest auf RTX 4080 mit 16 GB VRAM
Das lokale Ausführen großer Sprachmodelle bietet Privatsphäre, Offline-Fähigkeit und null API-Kosten.
Dieser Benchmark zeigt genau, was man von 14 populären
LLMs auf Ollama auf einer RTX 4080 erwarten kann.
Die Go-Ökosysteme blühen weiterhin auf, und die Trendliste für diesen Monat ist stark von KI-Agenten-Infrastruktur geprägt. Diese Übersicht analysiert die top trendigen Go-Repositories auf GitHub in diesem Monat.
Heute untersuchen wir die Top-Level-Verbraucher-GPUs und RAM-Module. Speziell betrachte ich die Preise für RTX-5080 und RTX-5090 sowie 32GB (2x16GB) DDR5 6000.
Self-gehostete ChatGPT-Alternative für lokale LLMs
[Open WebUI](https://www.glukhov.org/de/llm-hosting/llm-frontends/ „Open WebUI LLM-Oberfläche“) ist eine leistungsstarke, erweiterbare und funktionsreiche, selbst gehostete Web-Oberfläche zur Interaktion mit großen Sprachmodellen.
vLLM im Jahr 2026 installieren, bereitstellen und optimieren
vLLM ist ein hochdurchsatzstarker, speichereffizienter Inferenz- und Serving-Engine für Large Language Models (LLMs), der vom Sky Computing Lab der UC Berkeley entwickelt wurde.