
AIアシスタントアーキテクチャ:LLM、メモリ、ツール、ルーティング、オブザーバビリティ
シリアスなアシスタントは実際にはどのように構築されているか。
本番環境で運用されるAIアシスタントは、「プロンプトを与えたLLM」ではありません。ユーザーの意図を受け取り、状態を保持し、検索やアクションを行うタイミングを判断し、障害のデバッグに必要なランタイムの詳細情報を公開するシステムです。
アシスタントが単一のモデル呼び出しの範囲を超えた際に、そのシステムレベルの視点を探るのが、AIシステム クラスター です。
OpenAIは、エージェントを計画を立て、ツールを呼び出し、協働し、マルチステップの作業に必要な状態を保持するアプリケーションとして説明しています。一方、Anthropicは同じ課題を、ファイル、コマンド、Webアクセス、コードを安全に実行できる管理されたハーネスとして捉えています。
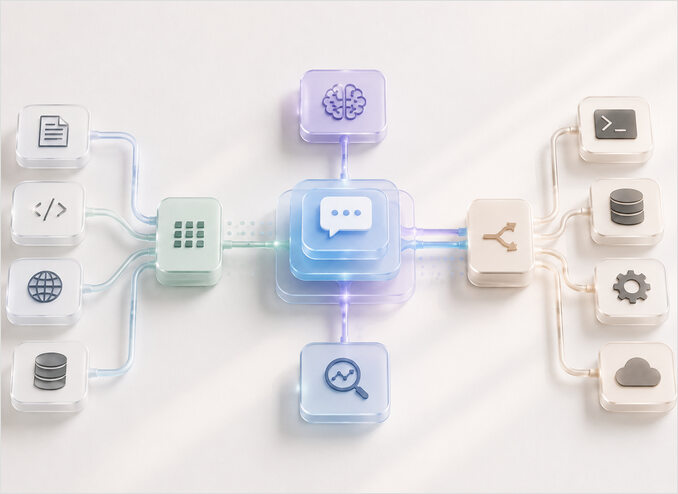
最もクリーンなアーキテクチャは、責任を5つのレイヤーに分けることです:LLM、メモリ、ツール、ルーティング、オブザーバビリティ。この分割は、主要プロバイダーAPI、MCP、vLLMやllama.cppのようなセルフホストランタイム、そしてOpenClaw やHermesのような実在のアシスタントシステムによって公開されている機能と合致しています。
メモリは、「より長いコンテキスト」として扱うべきではありません。検索システムは、外部の知識を明示的な非パラメトリックメモリに変換します。これは、検索拡張生成(RAG) で深く扱われているのと同じ設計空間です。Anthropicのコンテキストに関するガイダンスと「Lost in the Middle」の論文はどちらも、コンテキストに多くのトークンを詰め込むだけでは、信頼できる想起(リコール)が保証されないことを警告しています。
ツールの使用は、魔法ではなく、コントラクトの境界です。OpenAIの関数呼び出し、Anthropicのツール使用、MCPはすべて同じパターンに依存しています:モデルが構造化されたリクエストを発行し、あるランタイムがそれを実行し、その結果が会話に戻るものです。その境界が杜撰であれば、アシスタントも杜撰になります。
私のバイアスはシンプルです:退屈なところから始めること。1つのオーケストレーター、1つの永続メモリパス、リクエストごとに1つのトレース、ツール実行のための1つの明示的なポリシー。マルチエージェントのグラフは有用ですが、単一エージェントの障害ケースを推測なしで説明できるようになった後でなければ意味がありません。
AIアシスタントシステムとは何か
実用的な定義は次のようになります。AIアシスタントシステムとは、モデルインターフェース、コンテキストのアセンブリ、ツール実行、状態管理、テレメトリを組み合わせることで、ユーザーの意図を応答やアクションに変換するランタイムです。そのため、有用なドキュメントはモデルカードだけではありません。有用なドキュメントは、APIリファレンス、ツールコントラクト、検索ガイド、ルーティングドキュメント、トレーシングドキュメントです。OpenAIのResponses APIは、状態を持つインタラクション、組み込みツール、関数呼び出しを公開しています。AnthropicのClaude APIは、Messagesへの直接アクセスおよびManaged Agentsを公開しています。OpenClawとHermesはさらに一歩進んで、これらの機能を永続ゲートウェイ、チャネル、セッション、メモリの背後に置いた場合の挙動を示しています。
言い換えれば、アシスタントシステムは、チャット補完よりも幅広いコントラクトを持っています。良い内部コントラクトは、次のようなものになります。
AssistantRequest  = ユーザー意図 + 識別子 + セッション + 添付ファイル + ポリシー
AssistantResponse = 回答 + アクション + 引用 + 状態変化 + トレースID
このコントラクトは重要です。なぜなら、本番環境でのすべての対立は最終的に、これらの質問のいずれかに収斂するからです:どのコンテキストが見えていたのか、どのツールが実行されたのか、どのモデルが回答したのか、どのメモリが読み書きされたのか、そしてトレースがシステムがどこで時間を費やしたかを示しているのか。OpenTelemetryは、トレースをアプリケーションを通じたリクエストのパスとして定義しており、これが真面目なアシスタントに必要なアブストラクションにそのまま該当します。LangSmithとOpenLITは、その考え方をLLM、ツール、ベクトルストア、エージェントワークフローのために特殊化しています。
コアコンポーネントとインターフェース
以下のコンポーネントの分割は、私が最も堅牢だと感じているものです。また、これが公式APIや、実際に運用されているオープンソースランタイムと最も整合性があります。
| レイヤー | 主な責任 | 典型的なインターフェース | 技術の例 |
|---|---|---|---|
| LLMレイヤー | 推論、生成、判断、構造化呼び出しの発行 | Responses API、Messages API、OpenAI互換またはAnthropic互換のエンドポイント | OpenAI、Anthropic、vLLM、llama.cpp、Ollama |
| メモリレイヤー | セッション状態、永続的なメモ、検索可能な知識の保持 | エンベディング、ベクトル検索、メモリ読み書きツール、検索API | OpenAIエンベディングとベクトルストア、Pinecone、Weaviate、pgvector、Milvus、Hermesメモリ、OpenClawメモリ |
| ツールレイヤー | モデルの外側でデータを読み取り、アクションを実行 | JSONスキーマツール、MCPツール、ファイルおよびWeb検索、ネイティブランタイムツール | OpenAI関数呼び出し、Anthropicツール使用、MCP、LangChainツール、LlamaIndexクエリツール |
| ルーティングレイヤー | モデル、バックエンド、ポリシー、テナントパスの選択 | モデルエイリアス、フェイルオーバーグループ、ヘルスチェック、予算、チャネルバインディング | LiteLLM、OpenClawマルチエージェントルーティング、Hermesプロバイダーランタイム解決 |
| オブザーバビリティ | 何が起きたか、なぜ起きたかの説明 | トレース、スパン、ログ、メトリクス、評価実行 | OpenTelemetry、LangSmith、OpenLIT |
上記の表は、公式プロバイダーインターフェース、MCP、ベクトルデータベースのドキュメント、およびvLLM、llama.cpp、OpenClaw、Hermesのランタイムドキュメントから導出されたものです。
LLMレイヤーは3つのことを適切に行うべきです:現在のワーキングコンテキストを消費し、最終回答または構造化アクションリクエストを発行し、リトライとトレーシングを支援するために十分なメタデータを返すこと。OpenAIのResponses APIは、状態を持つインタラクションおよび組み込みツールと関数呼び出しに対して明示的に設計されています。AnthropicのMessages APIは、tool_useブロックとtool_resultのリターンを介して同じコアループを公開し、Managed Agentsは、ループを自分自身で構築したくない場合にホストされたハーネスを提供します。vLLMやllama.cppのようなセルフホストランタイムは、推論を自分の環境内に配置できるようにしながら、馴染みのあるプロバイダースタイルのインターフェースを維持するため重要です。
メモリレイヤーは、精神的に3つのバケットに分割されるべきです:ワーキングメモリ、永続的なシンボリックメモリ、検索可能なセマンティックメモリ。OpenAIエンベディングは、インデックス付けおよび検索可能なベクトルを返します。OpenAI RetrievalとFile Searchは、ベクトルストアの上にセマンティック検索とキーワード検索を重ね合わせます。Pinecone、Weaviate、pgvector、Milvusは4つの一般的なストレージ形状を表しています:完全に管理されるもの、オープンソースのベクトルネイティブ、Postgresネイティブ、分散型ベクトルデータベース。HermesとOpenClawは、すべてのメモリがベクトルストアにあるべきではないという有用な注意点をもたらします:ファイルバックのメモ、レビュー済みプロモーション、セッションスコープのスナップショットの方が、より誠実な設計であることが多いのです。AIアシスタントにおけるメモリシステム はクロスフレームワークのモデルをマッピングし、Hermes Agent メモリシステム は、有界コアメモリとフローズンセッションスナップショットを1つのプロダクト内で解説します。
ツールレイヤーは、アシスタントがサマライザーではなくなり、ソフトウェアとして振る舞い始める場所です。OpenAIの関数呼び出しは、ツールをモデルが呼び出すかどうかを決定できる、スキーマで定義された機能として扱います。Anthropicは同じことをより明示的に述べています:ツール使用はアプリケーションとモデル間のコントラクトであり、モデルは決してそれ自身で何も実行しない。MCPはそのコントラクトをクライアントサーバープロトコルに一般化し、ホストがツール、プロンプト、リソースを公開する1つ以上のサーバーに接続します。これは、GoでのMCPサーバー で段階的に説明されているのと同じ境界です。LangChainとLlamaIndexは、ここにオーケストレーションライブラリとして快適に位置づきます:LangChainはビルド済のエージェントアーキテクチャと統合に焦点を当て、LlamaIndexはコンテキスト増強データアクセス、クエリエンジン、ワークフローに焦点を当てます。
ルーティングレイヤーが存在するのは、「どのモデルか?」が唯一の質問ではないからです。「どのプロバイダーパスか、どのテナントか、どの予算か、どのレイテンシクラスか、どのフォールバックか?」も必要です。LiteLLMが有用なのは、その公式ドキュメントが驚くほど具体的だからです:加重ピッキング、最も暇なサーバー選択、レイテンシベース、コストベースのルーティング、有界フェイルオーバーはすべて第一級のパターンです。OpenClawはルーティングをチャネルとエージェント分離へと上方に拡張し、Hermesは要約、コンテキスト圧縮、MCPツールルーティングのようなメインと補助作業のためのモデルスロットへと下方に拡張します。これが正しいメンタルモデルです:ルーターはモデルより多くものを選択します。それは実行レーンを選択するのです。
オブザーバビリティレイヤーは、アーキテクチャが伝説(フォークローア)に変わりゆくのを防ぐものです。OpenTelemetryはトレースのアブストラクションを与えます。LangSmithはLLMアプリケーションのステップに対するエンドツーエンドの可視性を与え、クラウド、ハイブリッド、セルフホストされたデプロイメント形状をサポートします。OpenLITは、ゼロコードと手動計装のオプション、LLM、エージェントフレームワーク、ベクトルデータベース、GPUのサポートを含む、OpenTelemetryネイティブのAIオブザーバビリティを与えます。推論とエージェントワークフロー全体の本番メトリクス、トレース、SLOパターンについては、LLMシステムのためのオブザーバビリティ を参照してください。アシスタントにリクエストごとのトレースがなければ、モデル呼び出しごとのスパンがなければ、ツール実行のためのイベント履歴がなければ、まだアーキテクチャを持っていません。ただの雰囲気にすぎません。
キャプチャ、エンリッチ、レスポンド
実システムで繰り返し現れるシーケンスは、capture -> enrich -> respond -> record です。異なるフレームワークはこれを変えてラップしますが、フローは安定しており、背骨として扱うことができます。
キャプチャ ステップは、外見以上に重要であることが多いです。OpenClawとHermesはどちらも、インクリースがテキストの入力だけでなく、チャネルメタデータ、識別子、認可、セッション境界、ダイレクトメッセージ、グループ、cronティック、配信セマンティクスを含むため、アシスタントの前に永続ゲートウェイを置いています。そのレイヤーをスキップして生チャットウィジェットのアブストラクションに依存すれば、結局、アドホックなミドルウェアとして後から増設することになります。
エンリッチ ステップは、成熟したシステムがトイデモから逸脱する場所です。OpenAI RetrievalとFile Searchは、ベクトルストアと検索呼び出しを通じて検索を明示的にします。LlamaIndexは、データコネクタ、インデックス、クエリエンジン、ワークフローを通じて同じパターンを形式化します。Hermesは、モデル所有権をメインと補助のスロットに分割し、圧縮、要約、ルーティングなどの作業をより小さいまたはより専門的なモデルにオフロードすることでさらに進んでいます。これは窃取に値する設計パターンです:最も高価なモデルトークンを雑用に使うべきではありません。
レスポンド ステップは「テキストを生成する」ことではありません。「現在のループを閉じる」ことです。モデルが直接回答できる場合は、そうします。ツールが必要であれば、構造化リクエストを発行します。Anthropicのツール使用コントラクトとOpenAIの関数呼び出しガイドは、どちらもこれを明示的にしています。これがアーキテクチャ的に重要なのは、出力が今や言語と制御フローの両方を含むからです。あなたのレスポンスオブジェクトは、散文の一部であり、ランタイムプランの一部でもあります。
レコード ステップは、整合性セマンティクスが現れる場所です。Pineconeは書き込みパスと読み取りパスを分離し、永続的な確認後に書き込みを処理します。Hermesメモリは、セッションごとにフローズンスナップショットとして注入されるため、プレフィックスキャッシュのパフォーマンスを維持できます。これは、新しい書き込みが現在のセッションプロンプトに自動的に現れないことを意味します。OpenClawのDreamingシステムは、レビューされ、根拠を持つ候補のみをMEMORY.mdに昇格させ、常時オンではなくオプトインです。実用的な教訓は、メモリが本当に書き込み後読み込み(read-after-write)であることはめったにないということです。段階的な可視性を設計する必要があります。
OpenClawとHermesを参照システムとして
OpenClawとHermesは、単一のプロバイダーAPIのラッパーではなく、ゲートウェイ、セッション、ツール、メモリ、複数のモデルバックエンドを持つ長時間実行システムとしてアシスタントを提示するため、有用な参照ケースです。
| アーキテクチャ上の懸念 | OpenClawのマッピング | Hermesのマッピング |
|---|---|---|
| イングレスとサーフェス | チャットアプリとチャネルサーフェスを接続するセルフホストゲートウェイ | 多数の外部プラットフォームを接続する単一のバックグラウンドメッセージングゲートウェイ |
| オーケストレーション | チャネルとAIインタラクションのためのゲートウェイ中心のコントロールプレーン | プロンプトアセンブリ、プロバイダー選択、ツールディスパッチ、リトライ、フェイルオーバーを処理するAIAgentループ |
| ルーティング | 受信トラフィックを隔離されたエージェントにバインドするマルチエージェントルーティング(個別のワークスペースとセッションを持つ) | メインと補助のモデルスロットが、コア推論を圧縮、要約、承認、MCPルーティングから分離 |
| メモリ | ファイルバックメモリに加え、オプションのアクティブメモリと背景Dreaming昇格 | MEMORY.mdとUSER.mdがフローズンセッションスナップショットとして注入され、外部メモリプロバイダーを追加 |
| ツールと拡張 | ビルトインツール、セッションツール、プロバイダープラグイン、カスタムおよびセルフホストエンドポイント | 40以上のツール、ビルトインMCPクライアント、ツールセット、スキル、メモリプロバイダープラグイン |
このマッピングは、公式OpenClawとHermesドキュメントおよびリポジトリに基づいています。OpenClawは、ゲートウェイアーキテクチャ、マルチエージェントルーティング、vLLMとOllamaを含むカスタムおよびセルフホストプロバイダーサポート、オプションのアクティブメモリ、Dreamingベースの昇格を文書化しています。Hermesは、メッセージングゲートウェイ、中央AIAgentループ、メインと補助のモデルスロット、ビルトインメモリ、ネイティブMCP統合を文書化しています。
私のやや意見を帯びた解釈では、両システムは同じアーキテクチャ論を異なるアクセントで述べています。OpenClawは強くゲートウェイファーストです。Hermesは強くエージェントループファーストです。しかし、両者は、アシスタントが単なる「プロンプトプラスモデル」だという浅い考えを拒否しています。チャネル、識別子、メモリセマンティクス、ツールサーフェス、バックエンドの異種性は第一級の懸念としてモデル化します。これこそが、本番アーキテクチャがやるべきことです。
両システムに触発された実用的なハイブリッドスタックは次のようになります:
edge:
  gateway: hermesまたはopenclaw

routing:
  proxy: litellm
  policy: レイテンシと予算を考慮
  tenancy: セッションとチャネルスコープ

llm:
  primary: openai responsesまたはanthropic messages
  local_fallback: vllm
  local_dev: ollamaまたはllama.cpp

memory:
  session: sqliteまたはpostgres
  semantic: pgvectorまたはweaviate
  embeddings: openai embeddingsまたはollama embeddings

tools:
  contract: json schema tools plus mcp
  examples: filesystem, browser, web search, internal APIs

observability:
  traces: opentelemetry
  ai_dashboards: openlitまたはlangsmith
  evals: openai evals plus app-specific regression sets
そのスタックは、ベンダーが規定した青写真ではなく、論理的なデプロイメントパターンです。これが機能するのは、公式インターフェースが整合しているからです:OpenAIとAnthropicはツール指向のAPIを公開し、vLLMとllama.cppはプロバイダースタイルのエンドポイントをエミュレートし、Ollamaはローカルモデルとエンベディングを処理し、MCPは外部ツールを標準化し、LiteLLMはルーティングとフェイルオーバーを処理し、OpenTelemetry互換プラットフォームはパス全体をトレースできます。
パターン、表、トレードオフ
名付ける価値のある繰り返し可能なアシスタントパターンがいくつかあります。管理アシスタントは、ランタイムの大部分をプロバイダーAPI内に保持します。検索ファーストアシスタントは、メモリと検索を主要な差別化要素として扱います。ツールファーストアシスタントは、チャットボットよりもオペレーターのように振る舞います。ゲートウェイアシスタントは、メッセージングサーフェスを通じた常時アクセスを優先します。スペシャリストメッシュは、作業を複数のエージェントまたはルートに分解します。OpenAI、Anthropic、LlamaIndex、LiteLLM、OpenClaw、Hermesの公式ドキュメントはすべて、これらのパターンのバージョンをサポートしています(名前付けは異なるかもしれませんが)。
| パターン | 最適化する対象 | 最適なユースケース | 隠れたコスト |
|---|---|---|---|
| 管理アシスタント | 納品のスピード | 内部コーパイロットとサポートボット | プロバイダーロックイン、ランタイム詳細への制御が少ない |
| 検索ファーストアシスタント | 所有データに基づく根拠のある回答 | ドキュメント、サポート、知識作業 | 検索品質が実際の製品となる |
| ツールファーストアシスタント | 会話よりもアクション | オープスワークフロー、データ取得、自動化 | サイドエフェクト、リトライ、承認がコア懸念となる |
| ゲートウェイアシスタント | 普遍的なアクセス | チャットサーフェス全体の個人およびチームアシスタント | 識別子、セッション、セキュリティの複雑性 |
| スペシャリストメッシュ | 労務の分担 | 実所有境界を持つ複雑なワークフロー | より難しいデバッグ、オーケストレーション、評価設計 |
スペシャリストメッシュパターンは、エージェント数が増えるにつれて、明確なエンジニアリング規律に成長します。6つの正規の調整パターン — オーケストレーターワーカー、シーケンシャルパイプライン、ファンアウト、階層型、スワーム、メッシュ — と、特定の障害モード、本番意思決定フレームワークについては、マルチエージェントオーケストレーションパターン を参照してください。
このパターン表は、プロバイダードキュメント、フレームワークドキュメント、参照システムからの統合であり、ある1つのベンダーからの主張ではありません。
| オプション形状 | 典型的なコンポーネント | 強み | 弱み |
|---|---|---|---|
| 管理型 | OpenAI ResponsesまたはAnthropic Managed Agents、ホストされたファイル検索またはベクトルストア | 最速のパス、動く部品が少ない、ホストされたツール | データパスとランタイムセマンティクスへの制御が最低 |
| ハイブリッド | プロバイダーAPIプラスセルフホストルーターとベクトルストア | スピードと制御の良いバランス | 維持すべきコントラクトが多い |
| セルフホスト | vLLMまたはllama.cppまたはOllama、MCP、セルフホストベクトルDB、OTel | 強いプライバシーとデプロイメント制御 | 最大の運用負担、ハードウェアとチューニングのオーバーヘッド |
表注:OpenAIのホストFile Searchは管理ツールです。Anthropicは管理ハーネスを提供します。Pineconeは管理ベクトルサービスです。一方、vLLM、llama.cpp、Ollama、pgvector、Weaviate、Milvus、LangSmithセルフホスト、OpenLITはすべて、程度の差こそあれセルフマネージドまたはハイブリッドの動作をサポートします。
| ベクトルストア | 形状 | チームが選んだ理由 | 注意点 |
|---|---|---|---|
| Pinecone | 管理ベクトルサービス | 強い運用の簡素さとスケーラブルな管理アーキテクチャ | 外部依存性と管理サービスの経済性 |
| Weaviate | オープンソースベクトルデータベース | ベクトルプラスインバージョンインデックスと柔軟なインデックス選択 | ホストオンリーパスよりも多くのクラスタチューニング |
| pgvector | Postgres拡張機能 | 関係データと既存のSQLスタックでベクトルを保持 | すべての高規模ANNワークロードに最適な適合ではない |
| Milvus | 分散ベクトルデータベース | 目的構築のスケーリングと管理Zilliz Cloud周辺のエコシステム | 運用すべきもう一つの専門データストア |
表注:Pineconeは管理コントロールプレーンとリージョナルデータプレーンを文書化しています。Weaviateは複数のベクトルインデックスタイプを持つベクトルとインバージョンインデックスを文書化しています。pgvectorはPostgresに完全および近似近傍探索を追加します。Milvusはオープンソースの高パフォーマンス、スケーラブルなベクトルデータベースとして位置付けられ、管理オプションとしてZilliz Cloudがあります。
| LLMオプション | インターフェーススタイル | 最も得意とする点 | 注意点 |
|---|---|---|---|
| OpenAI Responses | 状態レスポンスプラス組み込みツール | 快速スタート、ホストされたツール、構造化ループ | プラットフォーム固有のアブストラクションを引き継ぐ |
| Anthropic Messages | 明示的なツール使用コントラクトを持つ直接モデルアクセス | クリアなツール境界とカスタムループでの良い制御 | Managed Agentsを使わない限り、より多くのランタイムがあなたの責任 |
| vLLM | OpenAI互換とAnthropic互換のセルフホストサービング | 高スループットのセルフホスト推論 | 実際のインフラストラクチャとモデルサービングの作業 |
| Ollama | シンプルなローカルモデルとエンベディングランタイム | ローカル開発と小規模セルフホストスタック | チューニング済みの分散ランタイムと同じクラスのサービングシステムではない |
| llama.cpp | プロバイダー互換ルートを持つ軽量ローカルサーバー | エッジ、CPUファースト、制約環境 | より多くの手動チューニングと能力マッチングを行う |
表注:OpenAIはResponsesを、状態レスポンスと組み込みツールのための高度なインターフェースとして文書化しています。AnthropicはMessages APIとツール使用コントラクトをManaged Agentsから別々に文書化しています。vLLMはOpenAI互換サーバーとAnthropic Messages APIサポートを公開します。Ollamaはローカルエンベディングとモデルワークフローを文書化します。llama.cppはOpenAI互換チャット、レスポンス、エンベディングルート、およびAnthropic互換チャット補完を文書化しています。
| 制約またはトレードオフ | 管理型へのバイアス | セルフホストへのバイアス | 実用的な緩和策 |
|---|---|---|---|
| レイテンシ | しばしばより良い初回イテレーションと少ないローカルチューニングタスク | モデルとデータがローカルに置かれウォームに保たれた場合、勝ちうる | ルーティングティア、ホットキャッシュ、より小さい補助モデルの使用 |
| コスト | 開始が容易で、トークンスケールでは変動 | 安定した利用率でのより良い償却 | 直感で最適化する前に実際のトラフィックを計測 |
| プライバシーとレジデンシー | 非機密データに対しては簡単 | 機密および規制フローに対する強い制御 | ハイブリッド境界を使用し、動かせないもののみ保持 |
| 整合性 | ホストされたツールにはまだ段階的可視性セマンティクスがある | セルフホストメモリパイプラインもデータを段階的に昇格 | レイヤーごとに書き込み後読み込みルールを明示的に定義 |
| スケーリング | コントロールプレーンの痛みが少ない | 安定した専門ワークフローへのより良い調整 | バッチング、キューイング、隔離テナントの使用 |
| デバッグ可能性 | 不透明なプロバイダー内部を見過ごしやすい | 自分で作った複雑さに溺れやすい | すべてのリクエストをトレースし、すべてのルートを評価 |
このトレードオフマトリクスは、ベンダーベンチマークではなく、公式ドキュメントからのアーキテクチャ推論です。整合性の行は、多くのブログ記事が認めるよりも重要かもしれません:Pineconeは書き込みパスと読み取りパスを分離し、Hermesはメモリをセッション開始プロンプトにフリーズし、OpenClawは段階的なレビューを通じて永続メモリを昇格させます。これは、「メモリが更新された」ことと「メモリが現在の回答に見える」ことは、しばしば異なる真実であることを意味します。
障害モードと緩和策
ほとんどのアシスタントが失敗するのは、ベースモデルが「悪い」からではありません。周囲のシステムがモデルに嘘をつき、適切なコンテキストを餓死させ、ツールが漂流するのを許し、デバッグを不可能にするからです。
| 破綻する場所 | 典型的な症状 | 通常の原因 | 緩和策 |
|---|---|---|---|
| プロンプトアセンブリ | 自信満々だが的外れな回答 | 無関連なコンテキストが多すぎ、順序が悪い | コンテキスト予算の設定、リランキング、主要事実を上部に保持 |
| 検索 | 正しいトーン、誤った事実 | 悪いチャンク分割、古いインデックス、弱いフィルタ | 検索を別々に評価、メタデータフィルタとハイブリッド検索の追加 |
| ツール境界 | 誤ったアクションまたは重複アクション | 緩いスキーマ、冪等性なしのリトライ | 厳密なスキーマ、冪等性キー、承認ゲート |
| ルーティング | リクエストごとに激しく不一致の動作 | 品質管理なしのコストまたはレイテンシルーティング | スティッキーセッションとルートごとの評価の追加 |
| メモリ | 古いまたは毒された想起 | 急進的な書き込み、弱いレビュー、セッション間リーク | ワーキングメモリと永続メモリを分離、昇格のレビュー |
| オブザーバビリティ | 何が起きたか不明 | トレースの欠如またはスパン粒度なし | 検索、モデル、ツール呼び出しのためのルートおよびサブスパンの発行 |
| ハルシネーション制御 | 妥当だが根拠のない主張 | 弱いグラウンディングまたは検証パスなし | 参照ドキュメント検証、自己一致性チェック、評価ゲート |
この表の証拠ベースは広範囲ですが、一貫しています。Anthropicのツールドキュメントは、ツール使用がコントラクトの境界であることを明確にします。OpenAI Guardrailsは、File Searchを介した参照ナレッジベースに対するハルシネーション検出を含みます。SelfCheckGPTは、サンプル間の自己一致性が根拠のない主張の検出に役立つことを示します。「Lost in the Middle」の結果とAnthropicのコンテキストガイダンスはどちらも、同じ運用上の教訓を強化しています:より多くのトークンでコンテキストのキュレーションの必要性が除去されるわけではない。
優先される緩和スタックは、退屈で繰り返しの多いものであってよいです:すべてのリクエストをトレースし、プロンプトにバージョン管理を施し、検索を独立して評価し、ツールを冪等にし、ルートやメモリポリシーを変更する前に回帰評価を実行する。OpenAIのEvalsドキュメントとリポジトリは、なぜこれが重要かについて率直に述べています:評価なしでは、モデルやプロンプトの変更がユースケースにどう影響するかを理解することは難しく、時間のかかるものです。これはプロンプトと同様に、ルーターや検索にも当てはまります。
さらなる読書
深く掘り下げる場合は、アシスタントアーキテクチャを設計またはレビューしながら開いておくのに最も有用な一次情報源があります。
-
OpenAI: Responses Overview, Function Calling, Using Tools, Retrieval, File Search, Evals, リモートツールサーバー用のMCP.
-
Anthropic: API Overview, Tool Use, ツール使用コントラクト, Managed Agents, Context Windows, MCPコネクタ.
-
MCP自体: Architecture OverviewとSpecificationは直接読む価値があります。なぜなら、ホスト、クライアント、サーバー、ツール、プロンプト、リソース、トランスポート、能力交渉をクリーンに説明しているからです。MCPとAgent2Agentプロトコルの実用的な比較、およびマルチエージェントシステムが両方のレイヤーを必要とするタイミングについては、A2A vs MCP: AIエージェントは本当に両方のプロトコルが必要か? を参照してください。A2Aの概念自体 — Agent Cards、タスクライフサイクル、メッセージ、パーツ、成果物 — については、A2Aプロトコルとは何か? Agent Cardsとタスクの解説 を参照してください。
-
バックグラウンドとプロアクティブなアシスタント: ツールレイヤーは、アシスタントがどのように動作するかの一部にすぎません。アシスタントが自ら監視、判断、動作させる方法 — スケジューラ、キューベースワーカー、クレームプロトコル、永続ワークフロー、セマンティックポーリング — については、AIアシスタントにおけるポーリングエージェント: 11の実装パターン を参照してください。
-
決定権限: モデルが決定、推奨、または情報提供のみすべきであるか — 5つの決定ロール、最小の有能ティアへの信頼度ベースのルーティング、破壊半径に合わせた承認ゲート — については、決定LLM: モデルが決定すべき時 — そしてすべきでない時 を参照してください。
-
A2Aプロトコルと採用: エージェントが独立してデプロイされ、所有境界を超えて協働する必要がある場合、A2Aが関連してきます。A2Aが実際に牽引力を持っている場所、それが提起するセキュリティ上の質問、および採用すべきかの意思決定フレームワークに関する2026年の実用的な見解については、Google A2A Protocol in 2026: 採用、 hype、現実 を参照してください。これらのエージェントが単一のチャットターンではなく長時間実行タスクを交換する場合、長時間エージェントワークフローのためのA2Aストリーミングと非同期タスク がプロトコル境界でのSSE、プッシュ、input_required設計をカバーします。
-
フレームワークとルーティング: LangChain Overview, LlamaIndexコンテキスト増強ドキュメント, LiteLLMルーティングドキュメント, LangSmithオブザーバビリティドキュメント.
-
セルフホストランタイムとアシスタントシステム: vLLM, llama.cppサーバー, Ollamaエンベディング, OpenClawドキュメントとリポジトリ, Hermesドキュメントとリポジトリ.
-
ストレージとオブザーバビリティ: Pinecone, Weaviate, pgvector, Milvus, OpenTelemetry, OpenLIT.
-
研究論文: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Lost in the Middle, SelfCheckGPT.
