
「観測性チームのための現代的アラートシステム設計」
アラート通知はノイズを流すための仕組みではなく、対応のためのシステムである
アラートは、監視機能として語られることが多すぎます。 その枠組みは便利ですが、真の問題を隠してしまいます。
アラート通知はノイズを流すための仕組みではなく、対応のためのシステムである
アラートは、監視機能として語られることが多すぎます。 その枠組みは便利ですが、真の問題を隠してしまいます。
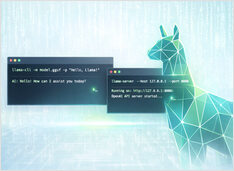
CLIおよびサーバーでGGUFモデルを実行する
llama.cpp は GGUF モデル向け C/C++ 推論エンジンです。対話型チャット用の llama-cli、スクリプトによるプロンプト処理用の llama-completion、OpenAI 互換 HTTP API 用の llama-server が含まれます。
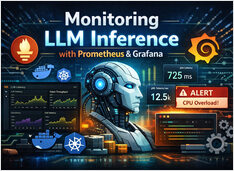
Prometheus と Grafana を用いた LLM の監視
LLM の推論は「ただの API」のように見えますが、レイテンシが急増し、キューが backlog して、GPU のメモリ使用率が 95% に達しても明確な説明ができない状況に直面した際に、その真の姿が明らかになります。
LLM推論およびLLMアプリケーションのためのエンドツーエンドの可視化戦略
LLM(大規模言語モデル)システムは、従来のAPIモニタリングでは検知できない方法で失敗します。キューが静かに埋め尽くされ、CPUが忙しい状態になる遥か前にGPUメモリが飽和し、レイテンシはアプリケーションレイヤーではなくバッチ処理レイヤーで急増します。
本番環境のメトリクス、ダッシュボード、ログ、およびアラート機能 — Prometheus、Grafana、Kubernetes、およびAIワークロード
可観測性は、信頼性の高い本番環境システムの基盤です。
メトリクス、ダッシュボード、アラートがないと、Kubernetesクラスターは状態が不安定になり、AIワークロードはサイレントに失敗し、レイテンシの劣化はユーザーからの苦情があるまで気づかれません。
プロメテウスで堅牢なインフラストラクチャのモニタリングを構築しましょう
Prometheus は、クラウドネイティブなアプリケーションとインフラストラクチャのモニタリングにおいて事実上の標準となり、メトリクスの収集、クエリ、可視化ツールとの統合を提供しています。
グラファナの設定をマスターしてモニタリングと可視化を実現しましょう
Grafana は、メトリクス、ログ、トレースを視覚的に表現し、アクション可能なインサイトに変換するための、監視および観測性のための主要なオープンソースプラットフォームです。