
virt-cloneとvirt-sysprepを使用してVirt-ManagerでVMをクローンする
VMのクローニングは、アイデンティティではなく、バイト単位のコピーを行う。
Virt-Manager(libvirtのGUI)は、KVMディスクをコピーし、クローンにUUIDとMACアドレスを割り当てます。ゲストOSは、virt-sysprepがそれらをクリアするまで、machine-idとSSHホストキーを保持し続けます。
VMのクローニングは、アイデンティティではなく、バイト単位のコピーを行う。
Virt-Manager(libvirtのGUI)は、KVMディスクをコピーし、クローンにUUIDとMACアドレスを割り当てます。ゲストOSは、virt-sysprepがそれらをクリアするまで、machine-idとSSHホストキーを保持し続けます。
MinIOに次いでセルフホスト型S3を選んだ理由
Amazon S3はオブジェクトストレージの事実上のAPIとして定着しています。オープンソースのMinIOリポジトリが2026年4月にアーカイブ化された後、信頼性の高いセルフホスト型代替手段が7つ残っています。
WordPressのSEOプラグイン「Yoast」からローカルAIへ
WordPressのSEOプラグインは、WordPressのコア機能の上に、メタデータ、サイトマップ、スキーマ、AIレイヤーを付加します。2026年現在、このレイヤーには自分のハードウェア上で推論を実行するプラグインが含まれています。
WordPressプラグインを超えたオープンソースSEO
セルフホスティングされた SEO ツールは、クローラー、Search Console ダッシュボード、ランキングトラッカー、MCP サーバー、ローカル AI をカバーします。本ガイドでは、主要なオープンソースプラットフォームと、有料 SEO API なしで動作する機能を比較します。
検索を超えて調査を行うセルフホスト型エージェント
ディープリサーチ(Deep Research)は、もはや検索ボックスに向かせたモデルというわけではなく、独自のソフトウェアのカテゴリとして確立しつつあります。本記事では、12のセルフホスト型システムとその背後にあるリサーチアーキテクチャを比較します。

「llama-serverがOllamaに勝つとき」
Ollamaとllama.cppは、競合する推論エンジンであるかのように比較されがちです。しかし、実際の選択は、管理されたモデルサービスと、直接操作するツールキットのどちらを選ぶかです。
16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
なぜAIスタックは毎月より強力な依存関係を生み出すのか
すべてのAPI呼び出しは、簡単な取引のように感じられます。しかし、それらが積み重なり、ファインチューニング用のデータ、評価ハーネス、ツールスキーマがすべて1つのベンダーに合わせて形作られると、ベンダーの切り替えは「ルーティングの変更」では済まなくなります。
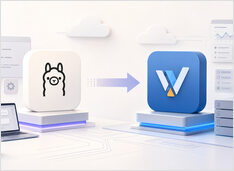
OllamaからvLLMへの移行タイミング
Ollamaはローカルでの言語モデル実行において最も手軽な方法の一つですが、その手軽さゆえに、ローカルの実験がスケジューリングや可観測性が必要な共有推論サービスへと移行すべきタイミングを隠してしまいます。
適切なコンテナワークフローを選択してください。
Docker ComposeとPodman Quadletは重複する問題を解決しますが、異なる設計理念から来ています。どちらを選ぶかは、アプリケーションスタックとして考えるか、Linuxサービスとして考えるかに依存します。
systemd によって管理される起動時の Docker Compose
Linux サーバー上の Docker Compose は、ブート時に起動し、シャットダウン時にクリーンに停止し、手動介入なしで再起動に耐えられるべきです。
Ubuntuで適切なDockerのインストールパスを選択してください。
Ubuntu に Docker をインストールするのは本来シンプルであるはずですが、実際には複数の「Docker 関連」の選択肢が同じコマンド名を巡って競合しており、それぞれ異なるパッケージ構成、アップグレード動作、セキュリティへの影響を持っています。
推測不要でUbuntuのAPTを修復する
長期間稼働している Ubuntu マシンでは、APT のエラーはよく発生します。これらは通常、リリースアップグレード、サードパーティリポジトリの変更、PPA の削除、手動インストールされた .deb ファイル、または中断されたパッケージインストールの後に現れます。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
スマートフォンからHermesと会話する
スマートフォンからテキストでヘルメスエージェントとチャットすることはすでに可能でしょう。 今、あなたはエージェントと直接会話し、音声で返信を受け取りたいと考えています。 これは通常、正しい選択です。特にHermesを永続的な自己ホスト型アシスタントとして使用している場合には顕著です。 小さな画面で長いプロンプトをタイプするのは、時間がかかり、誤りも生じやすいものです。