
GitHubの注目オープンソースAIプロジェクト、2026年10月
ジョブ別で分類したオープンソースAI
GitHub の月間トレンドページは言語フィルターがあるため、対象となるセットがすでに定義されており、機能しています。オープンソース AI に関しては、より異なる問いを立てます。対象となる作業は 5 つの言語にまたがり、有用な切り分けはリポジトリが担う役割です。
ジョブ別で分類したオープンソースAI
GitHub の月間トレンドページは言語フィルターがあるため、対象となるセットがすでに定義されており、機能しています。オープンソース AI に関しては、より異なる問いを立てます。対象となる作業は 5 つの言語にまたがり、有用な切り分けはリポジトリが担う役割です。
検索を超えて調査を行うセルフホスト型エージェント
ディープリサーチ(Deep Research)は、もはや検索ボックスに向かせたモデルというわけではなく、独自のソフトウェアのカテゴリとして確立しつつあります。本記事では、12のセルフホスト型システムとその背後にあるリサーチアーキテクチャを比較します。
トピックではなく、アクションでノートを整理する。
トピック別にノート整理するのは理にかなっているように思えます。しかし、PostgreSQLに関するノートが5つの異なるフォルダに散らばり、今日の課題に必要な特定のノートが見つからない状況に陥ると、その方法は通用しなくなります。
アシスタントのためのワーキングメモリ、構造化メモリ、検索メモリ
メモリはアシスタントを反応型のシステムから持続的なシステムへと変えますが、同時に多くのシステムが静かに腐敗していく場所でもあります。最近の調査では、現代的なエージェントのメモリに対して、短期記憶と長期記憶の二元論はもはや十分ではないと指摘されています。OpenAIやLangGraphのSDKは、よりシンプルなスタックを提唱しています。すなわち、ワーキングメモリ、永続状態、そして検索(リトリーバル)です。
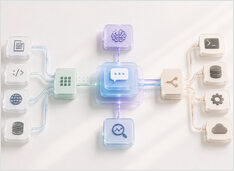
シリアスなアシスタントは実際にはどのように構築されているか。
本番環境で運用されるAIアシスタントは、「プロンプトを与えたLLM」ではありません。ユーザーの意図を受け取り、状態を保持し、検索やアクションを行うタイミングを判断し、障害のデバッグに必要なランタイムの詳細情報を公開するシステムです。
AIは知識管理の目的を変えず、手法を変革する。
AIは知識管理を置き換えるものではありません。むしろ、個人およびチームにとって知識管理の形そのものを変革しています。
検索は知識構造ではない
最新の知識システムのほとんどは検索(Retrieval)を最適化しています。それは理解できることです。検索は目に見えやすく、デモンストレーションも容易で、機能すると魔法のように感じられます。質問を入力すれば、答えが返ってきます。
AIシステム向けの構造化された知識
前提はシンプルです。コンパイルされた知識は、取得された断片的な情報よりも再利用性が高いというものです。 RAG(検索強化生成)は、LLM(大規模言語モデル)に外部知識へのアクセスをどのように与えるかという直接的な問いに対するデフォルトの答えとなりました。
現代の知識システムの地図
PKM、RAG、ウィキ、AIメモリシステム、そして今実用化が進むAI支援ワークフローは、しばしば同じ問題を解決するかのように論じられます。 しかし、実際にはそうではありません。 これらはすべて知識を扱いますが、動作するレイヤーは異なります。
ノートは記憶です。セカンドブレインは計算です。
情報過多(インフォメーション・オーバーロード)の問題は、単なる情報の量というよりも、処理されていない入力に起因するものです。現代の知的労働では、開きっぱなしのブラウザタブ、チャットのやり取り、ドキュメント、ハイライト、スニペット、トランスクリプト、スクリーンショット、そして書きかけのメモといった痕跡を残します。
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
RAG エンベッディング - Python、Ollama、OpenAI API。
検索拡張生成 (RAG) を実装されている方に向けて、このセクションではテキスト埋め込み(text embeddings)について平易な言葉で解説します。埋め込みとは何か、検索や検索(リトリバル)にどのように組み込まれるか、そしてOllamaやllama.cppベースのサーバーが提供するOpenAI 互換の HTTP API を使用して、Pythonから 2 つの一般的なローカル環境を呼び出す方法を説明します。
グラフ、Cypher、ベクトル、およびオペレーションの強化。
Neo4j は、関係そのものがデータであるときに選択するソリューションです。ドメインが白板に描かれた円と矢印の図のように見える場合、それをテーブルに無理やり押し込むのは苦痛を伴います。
ほとんどのローカルAIセットアップは、モデルとランタイムから始まります。
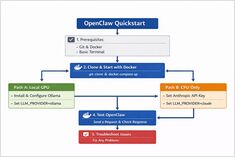
Ollamaを使用してOpenClawをローカルにインストール
OpenClawは、OllamaなどのローカルLLMランタイムや、Claude Sonnetなどのクラウドベースのモデルと併用して実行できる、セルフホスト型のAIアシスタントです。
OpenClaw AI アシスタント ガイド
ほとんどのローカルAI環境の構築は、同じところから始まります。モデル、ランタイム、そしてチャットインターフェースです。