
OpenClawからHermes Agentへの安全な移行方法
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。

「llama-serverがOllamaに勝つとき」
Ollamaとllama.cppは、競合する推論エンジンであるかのように比較されがちです。しかし、実際の選択は、管理されたモデルサービスと、直接操作するツールキットのどちらを選ぶかです。
エンジンごとに最適なAMDバックエンドを選択する
ROCm と Vulkan はどちらも AMD GPU をローカル LLM ホスティングで高速化しますが、互換性はありません。適切な選択は、エンジン、GPU、およびワークロードに依存します。

16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
「なぜあなたのAIスタックは月々強固になっていくのか」
すべての API 呼び出しは、単なる取引のように感じられます。しかし、それらが十分に蓄積されると、ファインチューニングデータ、評価ハネス、ツールスキーマがすべて特定のベンダー围绕して形作られ、切り替えが単なるルーティングの変更では済みなくなるのです。
コンパイルされた知識の信頼性を確保する
LLMウィキは、古い事実が依然として妥当に見えるようになり、矛盾が磨き上げられ、生成された要約が元々の情報源から逸脱した際に失敗します。
ローカルナレッジのためのプライベート同期
Syncthingは、あなたが管理するデバイス間でファイルを同期し続けるため、クラウドロックインを回避する自己ホスト型ナレッジインフラにおいて最も実用的なツールの一つとなっています。
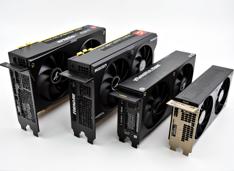
3社によるAI GPUの比較
2026年、AIハードウェアの状況は大きく変化しました。NVIDIA、AMD、Intelの各社が、ローカル環境で大型言語モデル(LLM)やAI推論ワークロードを実行できるGPUを必要とする開発者を獲得するため、激しい競争を繰り広げています。
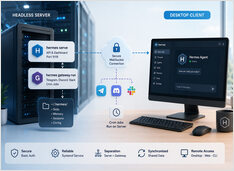
リモートデスクトップアクセスに対応したヘッドレスHermesサーバー
ヘッドレスサーバーで Hermes エージェントを実行し、別のマシンのデスクトップクライアントから接続するには、2つのサーバープロセスと1つのクライアント接続が必要です。
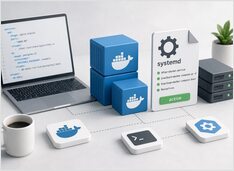
systemd によって管理される起動時の Docker Compose
Linux サーバー上の Docker Compose は、ブート時に起動し、シャットダウン時にクリーンに停止し、手動介入なしで再起動に耐えられるべきです。
Ubuntuで適切なDockerのインストールパスを選択してください。
Ubuntu に Docker をインストールするのは本来シンプルであるはずですが、実際には複数の「Docker 関連」の選択肢が同じコマンド名を巡って競合しており、それぞれ異なるパッケージ構成、アップグレード動作、セキュリティへの影響を持っています。
推測不要でUbuntuのAPTを修復する
長期間稼働している Ubuntu マシンでは、APT のエラーはよく発生します。これらは通常、リリースアップグレード、サードパーティリポジトリの変更、PPA の削除、手動インストールされた .deb ファイル、または中断されたパッケージインストールの後に現れます。
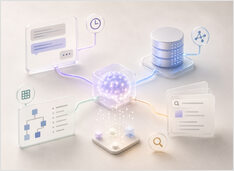
アシスタントのためのワーキングメモリ、構造化メモリ、および検索メモリ
メモリはアシスタントを反応型から永続型へと変えますが、同時に多くのシステムが静かに劣化してしまう箇所でもあります。調査では、短期的メモリと長期的メモリの二分法是では現代のエージェントメモリには不十分であると指摘されています。OpenAIやLangGraphのSDKは、よりシンプルな構成、つまりワーキングメモリ、永続的な状態、および検索による取得(リトリーブ)へと焦点を移しています。
スター数、トークン数、ダウンロード数――どれが本当に優位か?
オープンソースの AI エージェントフレームワークが、GitHub 上で人気が爆発しています。 セルフホスト型 AI システム エコシステムの核心に位置する 2 プロジェクト——OpenClaw と Hermes Agent——は、他のどのプロジェクトよりも大きく差を広げており、残りの競合プロジェクトは遠く離れた 3 位争いを行っています。
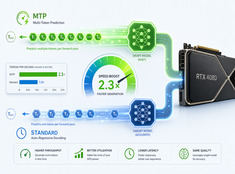
RTX 4080におけるMTPと標準デコーディングの比較 — 実ベンチマーク
RTX 4080(16 GB VRAM)環境で、Qwen 3.6 27Bおよび35Bにおける推論デコーディング(マルチトークン予測、MTP)のパフォーマンスをテストしました。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。