
OpenClawからHermes Agentへの安全な移行方法
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。

「llama-serverがOllamaに勝つとき」
Ollamaとllama.cppは、競合する推論エンジンであるかのように比較されがちです。しかし、実際の選択は、管理されたモデルサービスと、直接操作するツールキットのどちらを選ぶかです。
エンジンごとに最適なAMDバックエンドを選択する
ROCm と Vulkan はどちらも AMD GPU をローカル LLM ホスティングで高速化しますが、互換性はありません。適切な選択は、エンジン、GPU、およびワークロードに依存します。

16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
LLMの次に来るものとは?ポスト・トランスフォーマー時代。
AIのハイプは一定のリズムを刻んでいます。およそ3年ごとに、業界が賭けを集中させているアーキテクチャが、より新しいものへと置き換わっていくのです。次の転換点は、すでに研究機関の中で形を成し始めています。
コマンドラインからOpenCodeを開く、実践編
OpenCodeのコマンドラインインターフェースは、スクリプティング、CIパイプライン、無人エージェント実行のために構築されています。この記事では、日々の業務での使用方法に関する実践的なガイドを提供します。
1コマンドでインストールできる、強制SDDスキル。
Superpowers は、完全な仕様駆動型メソッドをインストール可能な Claude Skills にパッケージ化し、ブレインストーミング、計画立案、サブエージェントによる実装、厳格な TDD(テスト駆動開発)を強制します。これにより、これらの構造をユーザー自身が判断する必要がなくなります。
形を整えることを前提とした小型コーディングエージェント。
Pi Coding Agentは、4つのデフォルトツールを搭載し、ほとんどの動作を拡張機能、スキル、およびユーザー自身のワークフローに委ねる、最小限かつオープンソースのターミナルコーディングハーネスです。
「なぜあなたのAIスタックは月々強固になっていくのか」
すべての API 呼び出しは、単なる取引のように感じられます。しかし、それらが十分に蓄積されると、ファインチューニングデータ、評価ハネス、ツールスキーマがすべて特定のベンダー围绕して形作られ、切り替えが単なるルーティングの変更では済みなくなるのです。
ノイズの多い作業は委譲し、コンテキストをクリーンに保ちましょう。
ほとんどの Claude Code セッションが遅くなり、混乱に陥るのは同じ理由によります。探索的な grep、ログのダンプ、そして「もう1つのファイルを確認してみよう」といった動作が、メインの会話に永遠に残り続けるからです。
OllamaからvLLMへの移行タイミング
Ollamaはローカルでの言語モデル実行において最も手軽な方法の一つですが、その手軽さゆえに、ローカルの実験がスケジューリングや可観測性が必要な共有推論サービスへと移行すべきタイミングを隠してしまいます。
AIエージェントが仕様、テスト、コードから逸脱するのを防ぎましょう。
AIコーディングエージェントは機能を迅速に提供しますが、仕様書、テスト、コードは静かに乖離していきます。このガイドでは、トレーサビリティモデル、仕様からテストおよびコードへのマッピング、そしてマージ前に乖離を検知するCIチェックについて解説します。
コンパイルされた知識の信頼性を確保する
LLMウィキは、古い事実が依然として妥当に見えるようになり、矛盾が磨き上げられ、生成された要約が元々の情報源から逸脱した際に失敗します。
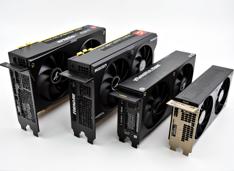
3社によるAI GPUの比較
2026年、AIハードウェアの状況は大きく変化しました。NVIDIA、AMD、Intelの各社が、ローカル環境で大型言語モデル(LLM)やAI推論ワークロードを実行できるGPUを必要とする開発者を獲得するため、激しい競争を繰り広げています。
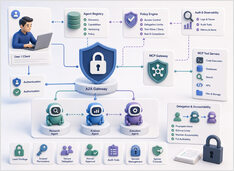
プロトコルセキュリティはモデルではなく、誰が実行できるか(誰が操作を行えるか)を定義するものです。
LLMシステムにおけるセキュリティの関心は、プロンプトインジェクションに最も集中していますが、それは確かに注目を集めるべきものです。しかし、エージェントがツールを呼び出し、他のエージェントに作業を委任し始めると、それは問題の一部に過ぎなくなります。
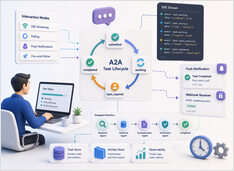
長期実行されるA2Aタスクは、チャットセッションの終了後も継続して実行されます。
ほとんどのAIエージェントのデモは、追加のステップを伴うチャット補完のように振る舞います。プロンプトを送信し、数秒待ってから、1つのレスポンスとして回答を受け取ります。