
Hermes Agentの振り返り:ローカルLLMによるセルフホスト型メモリ
ご自身のハードウェア上で永続的なHermesメモリを実現。
自己ホスティングされたAIエージェントには、単に長いコンテキストウィンドウがあるだけでは不十分です。有用な事実を保持し、以前の決定を参照し、プロジェクトが進化するにつれて自分の認識を更新するための手段が必要です。
ご自身のハードウェア上で永続的なHermesメモリを実現。
自己ホスティングされたAIエージェントには、単に長いコンテキストウィンドウがあるだけでは不十分です。有用な事実を保持し、以前の決定を参照し、プロジェクトが進化するにつれて自分の認識を更新するための手段が必要です。
WordPressのSEOプラグイン「Yoast」からローカルAIへ
WordPressのSEOプラグインは、WordPressのコア機能の上に、メタデータ、サイトマップ、スキーマ、AIレイヤーを付加します。2026年現在、このレイヤーには自分のハードウェア上で推論を実行するプラグインが含まれています。
WordPressプラグインを超えたオープンソースSEO
セルフホスティングされた SEO ツールは、クローラー、Search Console ダッシュボード、ランキングトラッカー、MCP サーバー、ローカル AI をカバーします。本ガイドでは、主要なオープンソースプラットフォームと、有料 SEO API なしで動作する機能を比較します。
検索を超えて調査を行うセルフホスト型エージェント
ディープリサーチ(Deep Research)は、もはや検索ボックスに向かせたモデルというわけではなく、独自のソフトウェアのカテゴリとして確立しつつあります。本記事では、12のセルフホスト型システムとその背後にあるリサーチアーキテクチャを比較します。

「llama-serverがOllamaに勝つとき」
Ollamaとllama.cppは、競合する推論エンジンであるかのように比較されがちです。しかし、実際の選択は、管理されたモデルサービスと、直接操作するツールキットのどちらを選ぶかです。
エンジンごとに最適なAMDバックエンドを選択する
ROCm と Vulkan はどちらも AMD GPU をローカル LLM ホスティングで高速化しますが、互換性はありません。適切な選択は、エンジン、GPU、およびワークロードに依存します。
16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
なぜAIスタックは毎月より強力な依存関係を生み出すのか
すべてのAPI呼び出しは、簡単な取引のように感じられます。しかし、それらが積み重なり、ファインチューニング用のデータ、評価ハーネス、ツールスキーマがすべて1つのベンダーに合わせて形作られると、ベンダーの切り替えは「ルーティングの変更」では済まなくなります。
OllamaからvLLMへの移行タイミング
Ollamaはローカルでの言語モデル実行において最も手軽な方法の一つですが、その手軽さゆえに、ローカルの実験がスケジューリングや可観測性が必要な共有推論サービスへと移行すべきタイミングを隠してしまいます。
ローカルLLMによるセルフホステッドAI検索
Vaneは、「引用付きAI検索」分野でより実用志向の選択肢の一つです。ライブなWeb検索とローカルまたはクラウドのLLMを組み合わせつつ、スタック全体を自分自身の管理下におくセルフホスト型の回答エンジンです。
公開ポートを使用しないリモート Ollama アクセス
Ollama は、ローカルデーモンとして扱われるときに最も快適に動作します。CLI とアプリケーションがループバック HTTP API と通信し、残りのネットワークにはその存在が知られない状態です。
GPUと永続化対応のコンポーズファーストOllamaサーバー。
Ollama はベアメタル上で非常に良好に動作します。サービスとして扱うようになると、さらに興味深いものになります。安定したエンドポイント、ピン留めされたバージョン、永続化ストレージ、そして利用可能かどうかの明確な GPU。
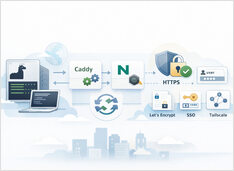
ストリーミング応答を破綻させずに HTTPS で Ollama を利用する。
リバースプロキシの背後で Ollama を実行することは、HTTPS、オプションのアクセス制御、予測可能なストリーミング動作を実現する最も簡単な方法です。
RAG エンベッディング - Python、Ollama、OpenAI API。
検索拡張生成 (RAG) を実装されている方に向けて、このセクションではテキスト埋め込み(text embeddings)について平易な言葉で解説します。埋め込みとは何か、検索や検索(リトリバル)にどのように組み込まれるか、そしてOllamaやllama.cppベースのサーバーが提供するOpenAI 互換の HTTP API を使用して、Pythonから 2 つの一般的なローカル環境を呼び出す方法を説明します。
OpenCode LLM テスト — コーディングおよび精度の統計
Ollama と llama.cpp でローカルホストされている複数の LLM と、比較のために追加した OpenCode Zen の無料モデルとの組み合わせで、OpenCode がどのように動作するかをテストしました。
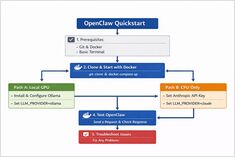
Ollamaを使用してOpenClawをローカルにインストール
OpenClawは、OllamaなどのローカルLLMランタイムや、Claude Sonnetなどのクラウドベースのモデルと併用して実行できる、セルフホスト型のAIアシスタントです。