
Superpowers クイックスタート:インストール、ワークフロー、および試行
1コマンドでインストールできる、強制SDDスキル。
Superpowers は、完全な仕様駆動型メソッドをインストール可能な Claude Skills にパッケージ化し、ブレインストーミング、計画立案、サブエージェントによる実装、厳格な TDD(テスト駆動開発)を強制します。これにより、これらの構造をユーザー自身が判断する必要がなくなります。
1コマンドでインストールできる、強制SDDスキル。
Superpowers は、完全な仕様駆動型メソッドをインストール可能な Claude Skills にパッケージ化し、ブレインストーミング、計画立案、サブエージェントによる実装、厳格な TDD(テスト駆動開発)を強制します。これにより、これらの構造をユーザー自身が判断する必要がなくなります。
形を整えることを前提とした小型コーディングエージェント。
Pi Coding Agentは、4つのデフォルトツールを搭載し、ほとんどの動作を拡張機能、スキル、およびユーザー自身のワークフローに委ねる、最小限かつオープンソースのターミナルコーディングハーネスです。
「なぜあなたのAIスタックは月々強固になっていくのか」
すべての API 呼び出しは、単なる取引のように感じられます。しかし、それらが十分に蓄積されると、ファインチューニングデータ、評価ハネス、ツールスキーマがすべて特定のベンダー围绕して形作られ、切り替えが単なるルーティングの変更では済みなくなるのです。
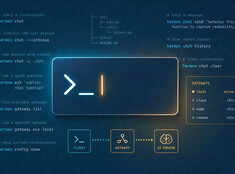
セルフホスト型 Hermes エージェント用のシェルコマンドと TUI コマンド。
Nous Research が提供する Hermes Agent は、ローカル環境またはVPS上で実行可能な、モデル非依存のツール利用型アシスタントです。
メモリは、ツールとパートナーの違いを決定づける。
あなたはご存知の通り、AIエージェントとのチャットを開き、プロジェクトを説明し、好みを共有し、作業を進めて、タブを閉じます。翌週に戻ってみると、まるで他人と話をしているかのようです。すべての文脈が消え、すべての好みが忘れられ、プロジェクトは最初から再説明する必要があります。
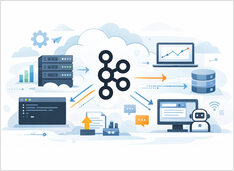
Kafka 4.2をインストールし、数分でストリーミングイベントを開始します。
Apache Kafka 4.2.0 が現在サポートされているリリースラインであり、Kafka 4.x は完全に ZooKeeper を不要とし、デフォルトで KRaft に構築されているため、モダンなクイックスタートには最適な基準となります。
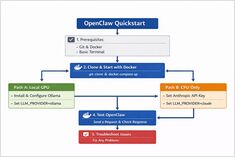
Ollamaを使用してOpenClawをローカルにインストール
OpenClawは、OllamaなどのローカルLLMランタイムや、Claude Sonnetなどのクラウドベースのモデルと併用して実行できる、セルフホスト型のAIアシスタントです。
AWS S3、Garage、またはMinIO - 概要と比較。
AWS S3はオブジェクトストレージの「デフォルト」の基準であり、完全に管理されており、強い一貫性を持ち、非常に高い耐久性と可用性が設計されています。
GarageおよびMinIOは、自己ホスト型のS3互換の代替案: Garageは軽量で、地理的に分散された小規模から中規模のクラスター向けに設計されていますが、MinIOはS3 APIの幅広い機能カバレッジと、大規模な展開での高パフォーマンスを強調しています。
Temporal SDKを使用してGoでワークフローを構築
セレニウム、chromedp、Playwright、ZenRows - Goでの実装。
正しいブラウザーオートメーションスタックとGoでのウェブスクレイピングの選択は、速度、メンテナンス、コードが実行される場所に影響を与えます。
PythonによるブラウザオートメーションとE2Eテストの比較。
Pythonにおけるブラウザーオートメーションスタックの選択は、速度、安定性、メンテナンスに影響を与えます。
この概要では、
Playwright vs Selenium vs Puppeteer vs LambdaTest vs ZenRows vs Gauge
を比較します。Pythonに焦点を当てながら、Node.jsや他の言語がどの場面で役立つかについても記載しています。
「Elmスタイル(Go)と即時モード(Rust)のTUIフレームワークの概観」
現在、ターミナルユーザーインターフェース(TUI)を構築するための強力な2つの選択肢は、BubbleTea (Go) および Ratatui (Rust) です。
1つは、Elmスタイルの枠組みを提供する意見を表明したアプローチであり、もう1つは柔軟な即時モードのライブラリです。
セルフホスト型LLMでデータとモデルを制御
LLM(大規模言語モデル)のセルフホスティングは、データ、モデル、推論をあなたの管理下に保つものであり、チーム、企業、国家にとって AI主権 を実現するための実用的な手段です。
RTX 4080(VRAM 16GB)でのLLMスピードテスト
ローカルで大型言語モデル(LLM)を動作させることで、プライバシー、オフライン対応、そしてAPIコストのゼロ化が実現できます。 このベンチマークでは、RTX 4080上でOllamaを利用した14の人気 LLMs on Ollama on an RTX 4080 の性能を正確に示しています。
2026 年 1 月の注目 Python リポジトリ
今月の Python エコシステムは、Claude Skills と AI エージェントツールによって支配されています。 本記事では、GitHub でトレンド入りしている トップの Python リポジトリ を分析します。
2026年1月の人気Rustリポジトリ
RustエコシステムはAIコーディングツールやターミナルアプリケーションにおいて革新的なプロジェクトが爆発的に増加しています。 この概要では、今月のGitHub上でのトップトレンドのRustリポジトリを分析しています。