
OpenClawからHermes Agentへの安全な移行方法
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。
コマンドラインからOpenCodeを開く、実践編
OpenCodeのコマンドラインインターフェースは、スクリプティング、CIパイプライン、無人エージェント実行のために構築されています。この記事では、日々の業務での使用方法に関する実践的なガイドを提供します。
ノイズの多い作業は委譲し、コンテキストをクリーンに保ちましょう。
ほとんどの Claude Code セッションが遅くなり、混乱に陥るのは同じ理由によります。探索的な grep、ログのダンプ、そして「もう1つのファイルを確認してみよう」といった動作が、メインの会話に永遠に残り続けるからです。
OllamaからvLLMへの移行タイミング
Ollamaはローカルでの言語モデル実行において最も手軽な方法の一つですが、その手軽さゆえに、ローカルの実験がスケジューリングや可観測性が必要な共有推論サービスへと移行すべきタイミングを隠してしまいます。
AIエージェントが仕様、テスト、コードから逸脱するのを防ぎましょう。
AIコーディングエージェントは機能を迅速に提供しますが、仕様書、テスト、コードは静かに乖離していきます。このガイドでは、トレーサビリティモデル、仕様からテストおよびコードへのマッピング、そしてマージ前に乖離を検知するCIチェックについて解説します。
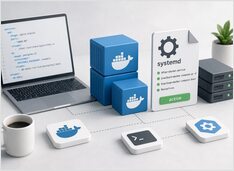
適切なコンテナワークフローを選択してください。
Docker ComposeとPodman Quadletは重複する問題を解決しますが、異なる設計理念から来ています。どちらを選ぶかは、アプリケーションスタックとして考えるか、Linuxサービスとして考えるかに依存します。
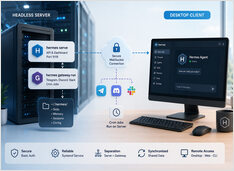
リモートデスクトップアクセスに対応したヘッドレスHermesサーバー
ヘッドレスサーバーで Hermes エージェントを実行し、別のマシンのデスクトップクライアントから接続するには、2つのサーバープロセスと1つのクライアント接続が必要です。
systemd によって管理される起動時の Docker Compose
Linux サーバー上の Docker Compose は、ブート時に起動し、シャットダウン時にクリーンに停止し、手動介入なしで再起動に耐えられるべきです。
Ubuntuで適切なDockerのインストールパスを選択してください。
Ubuntu に Docker をインストールするのは本来シンプルであるはずですが、実際には複数の「Docker 関連」の選択肢が同じコマンド名を巡って競合しており、それぞれ異なるパッケージ構成、アップグレード動作、セキュリティへの影響を持っています。
AIエージェントのための信頼性の高いポーリングパターン
ポーリングエージェントは、AIアシスタントのアーキテクチャの中で最も華やかではない部分の一つですが、同時に最も有用な部分の一つでもあります。
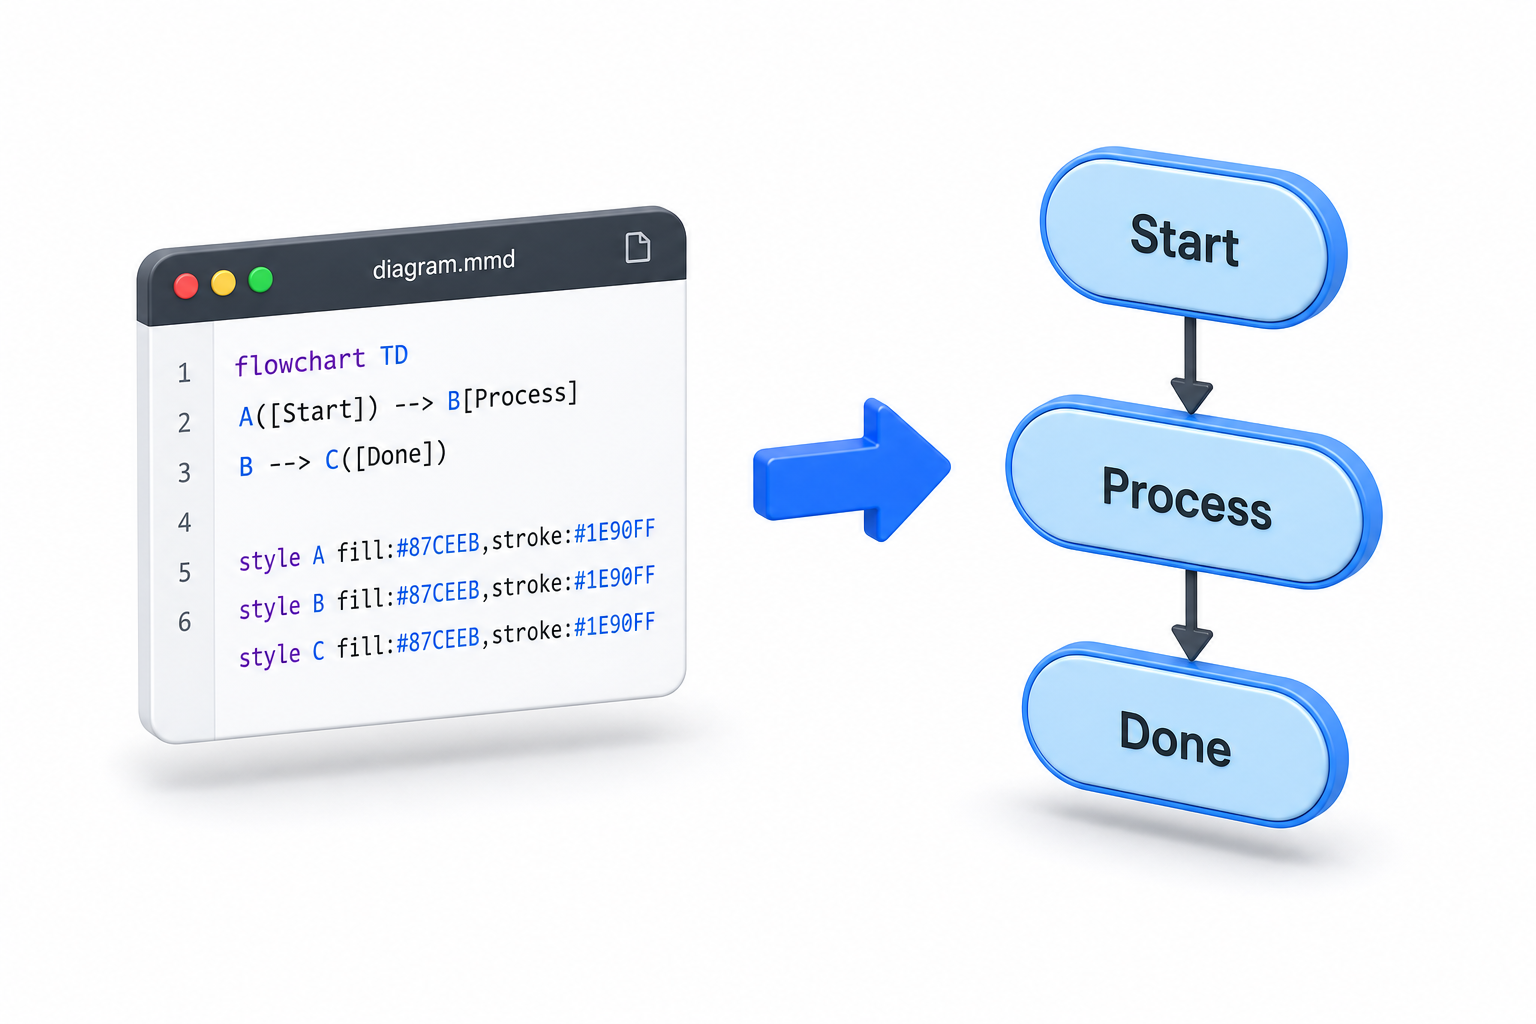
コードによる図解、トラブルなし。
Mermaidは、キャンバス上でボックスをドラッグするよりも、図をテキストとして記述することを好む人々のためのテキストベースの図作成ツールです。Markdownのような構文を使用して、フローチャート、シーケンス図、クラス図、状態機械図、タイムライン、ガントチャート、エンティティ関係図などを記述します。
本格的なアシスタントは実際にどのように構築されているのか
本番環境向けのAIアシスタントは「プロンプト付きのLLM」ではありません。それは意図を受け取り、状態を保持し、いつ取得したり実行したりするかを決定し、障害のデバッグに必要なランタイムの詳細を公開するシステムです。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
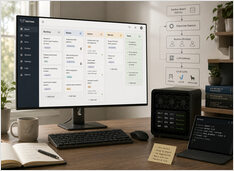
セルフホスト型LLMにおけるHermesカーンボードの負荷を制御する
Hermes AgentにはKanbanスタイルのボードとHermes Gatewayが標準で搭載されていますが、一度に多数のタスクがディスパッチされると、セルフホスト型のLLMが過負荷状態に陥る可能性があります。
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。
まずはプラグイン。スキルの名称を簡潔に。
この記事は、チャネル、モデルプロバイダー、ツール、音声、メモリ、メディア、Web 検索、その他ランタイムの表面機能などを追加するネイティブゲートウェイパッケージであるOpenClaw プラグインについて解説します。