
Hermes Agentの振り返り:ローカルLLMによるセルフホスト型メモリ
ご自身のハードウェア上で永続的なHermesメモリを実現。
自己ホスティングされたAIエージェントには、単に長いコンテキストウィンドウがあるだけでは不十分です。有用な事実を保持し、以前の決定を参照し、プロジェクトが進化するにつれて自分の認識を更新するための手段が必要です。
ご自身のハードウェア上で永続的なHermesメモリを実現。
自己ホスティングされたAIエージェントには、単に長いコンテキストウィンドウがあるだけでは不十分です。有用な事実を保持し、以前の決定を参照し、プロジェクトが進化するにつれて自分の認識を更新するための手段が必要です。
エンジンごとに最適なAMDバックエンドを選択する
ROCm と Vulkan はどちらも AMD GPU をローカル LLM ホスティングで高速化しますが、互換性はありません。適切な選択は、エンジン、GPU、およびワークロードに依存します。
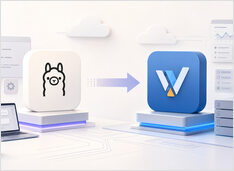
OllamaからvLLMへの移行タイミング
Ollamaはローカルでの言語モデル実行において最も手軽な方法の一つですが、その手軽さゆえに、ローカルの実験がスケジューリングや可観測性が必要な共有推論サービスへと移行すべきタイミングを隠してしまいます。
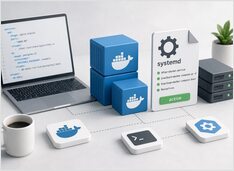
適切なコンテナワークフローを選択してください。
Docker ComposeとPodman Quadletは重複する問題を解決しますが、異なる設計理念から来ています。どちらを選ぶかは、アプリケーションスタックとして考えるか、Linuxサービスとして考えるかに依存します。
systemd によって管理される起動時の Docker Compose
Linux サーバー上の Docker Compose は、ブート時に起動し、シャットダウン時にクリーンに停止し、手動介入なしで再起動に耐えられるべきです。
Ubuntuで適切なDockerのインストールパスを選択してください。
Ubuntu に Docker をインストールするのは本来シンプルであるはずですが、実際には複数の「Docker 関連」の選択肢が同じコマンド名を巡って競合しており、それぞれ異なるパッケージ構成、アップグレード動作、セキュリティへの影響を持っています。
ローカルLLMによるセルフホステッドAI検索
Vaneは、「引用付きAI検索」分野でより実用志向の選択肢の一つです。ライブなWeb検索とローカルまたはクラウドのLLMを組み合わせつつ、スタック全体を自分自身の管理下におくセルフホスト型の回答エンジンです。
Hermes Agentのインストールと開発者向けクイックスタート
Hermes Agentは、セルフホスティングでモデル非依存型のAIアシスタントであり、ローカルマシンや低コストのVPS上で動作します。ターミナルとメッセージングインターフェースを通じて利用可能で、反復されるタスクを再利用可能なスキルに変換することで、時間が経つにつれてパフォーマンスが向上します。
TGI をインストールし、迅速にデプロイ、さらに高速にデバッグ。
Text Generation Inference (TGI) は、非常に特有の雰囲気を持っています。 推論の分野で最も新しい子供ではありませんが、すでに本番環境でのトラブルを学び、その教訓をデフォルト設定に焼き付けているのが TGI です。
GPUと永続化対応のコンポーズファーストOllamaサーバー。
Ollama はベアメタル上で非常に良好に動作します。サービスとして扱うようになると、さらに興味深いものになります。安定したエンドポイント、ピン留めされたバージョン、永続化ストレージ、そして利用可能かどうかの明確な GPU。
グラフ、Cypher、ベクトル、およびオペレーションの強化。
Neo4j は、関係そのものがデータであるときに選択するソリューションです。ドメインが白板に描かれた円と矢印の図のように見える場合、それをテーブルに無理やり押し込むのは苦痛を伴います。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。
Kafka 4.2をインストールし、数分でストリーミングイベントを開始します。
Apache Kafka 4.2.0 が現在サポートされているリリースラインであり、Kafka 4.x は完全に ZooKeeper を不要とし、デフォルトで KRaft に構築されているため、モダンなクイックスタートには最適な基準となります。
クライアントを変更せずにローカルLLMをホットスワップできます。
すぐにvLLM、llama.cpp、そしてその他の多数のスタックを回す必要が出てきます。それぞれのスタックは独自のポートを使います。しかし、下流のすべてのアプリケーションは、/v1 ベースの単一のURLを期待しています。そうでなければ、ポート、プロファイル、使い捨てのスクリプトの入れ替えを繰り返すことになります。llama-swap は、これらのスタックの前段にある /v1 プロキシです。
ソフトウェア開発では、バージョン管理にGit、コンテナ化にDocker、自動化にbash、データベースにPostgreSQL、エディタにVS Codeが不可欠です。生産性を左右する無数のツールが存在します。このページでは、開発スタック全体で効率的に作業するために必要な、不可欠なチートシート、ワークフロー、および比較情報をまとめています。
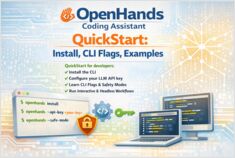
CLIインストール、フラグ、ヘッドレス、ローカルモデル
OpenHands は、サンドボックス内でファイルを編集し、コマンドを実行するオープンソースのコーディングエージェントです。本CLIのクイックスタートは、2026年10月26日にパッケージバージョン 1.16.0 に対して検証済みです。