
AIエージェントにおける自己強化型メモリループ:原因と解決策
「記憶された結論が新たな証拠となる時。」
永続メモリにより、エージェントは毎回説明を繰り返す必要のあるツールから、コンテキストを引き継ぐものへと進化します。しかし、状態のないチャットでは回避される障害モードが新たに開かれます。解釈が記憶として保存され、事実として検索され、それ自身のより強固なバージョンを正当化し始めることがあるのです。
「記憶された結論が新たな証拠となる時。」
永続メモリにより、エージェントは毎回説明を繰り返す必要のあるツールから、コンテキストを引き継ぐものへと進化します。しかし、状態のないチャットでは回避される障害モードが新たに開かれます。解釈が記憶として保存され、事実として検索され、それ自身のより強固なバージョンを正当化し始めることがあるのです。
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。
スキル、MCPサーバー、それとも両方?
エージェントスキルとMCPサーバーは、AIエージェントを拡張する競合する2つの方法として提示されることがあります。この捉え方は誤りです:スキルはエージェントに作業方法を教え、MCPサーバーはライブ機能への管理されたアクセスを提供します。
AIエージェントのための信頼性の高いポーリングパターン
ポーリングエージェントは、AIアシスタントのアーキテクチャの中で最も華やかではない部分の一つですが、同時に最も有用な部分の一つでもあります。
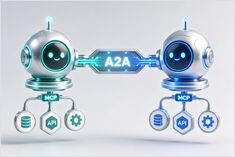
MCPはエージェントにツールを提供します。A2Aはエージェントに同僚を提供します。
AIエージェントのアーキテクチャは、2つのレイヤーに分裂し始めています。
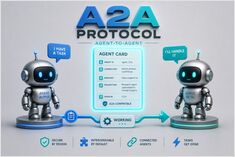
「A2Aはエージェントをネットワークピアに変換します。」
Agent2Agentプロトコルの略称であるA2Aプロトコルは、独立したAIエージェントシステム間の通信のためのオープン標準です。
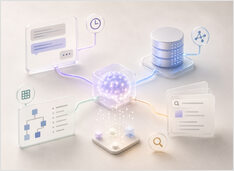
アシスタントのためのワーキングメモリ、構造化メモリ、検索メモリ
メモリはアシスタントを反応型のシステムから持続的なシステムへと変えますが、同時に多くのシステムが静かに腐敗していく場所でもあります。最近の調査では、現代的なエージェントのメモリに対して、短期記憶と長期記憶の二元論はもはや十分ではないと指摘されています。OpenAIやLangGraphのSDKは、よりシンプルなスタックを提唱しています。すなわち、ワーキングメモリ、永続状態、そして検索(リトリーバル)です。
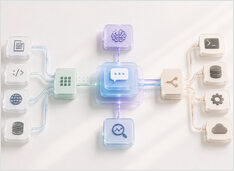
シリアスなアシスタントは実際にはどのように構築されているか。
本番環境で運用されるAIアシスタントは、「プロンプトを与えたLLM」ではありません。ユーザーの意図を受け取り、状態を保持し、検索やアクションを行うタイミングを判断し、障害のデバッグに必要なランタイムの詳細情報を公開するシステムです。
スター数、トークン数、ダウンロード数――どれが本当に優位か?
オープンソースの AI エージェントフレームワークが、GitHub 上で人気が爆発しています。 セルフホスト型 AI システム エコシステムの核心に位置する 2 プロジェクト——OpenClaw と Hermes Agent——は、他のどのプロジェクトよりも大きく差を広げており、残りの競合プロジェクトは遠く離れた 3 位争いを行っています。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
NemoClawでOpenClawを安全に実行
大多数のAIエージェントスタックは、セキュリティをデモ後の修正事項として扱っています。 NemoClawは対極の前提から始まり、隔離、ポリシー、ルーティングを初期設定(Day-Zero defaults)として採用しています。
キャプチャポリシーの重要性は、リコールと同等までに高まっている。
2026年9月更新: MnemosyneとMemoriを追加し、HonchoとHindsightの設定を拡張しました。また、元のインフラストラクチャ表に加えてキャプチャポリシー比較表を追加しました。
タブを閉じるとすべての記憶を失う現代のAIアシスタントに対し、コンテキストウィンドウを超えて永続化する何かが必要になります。エージェントメモリプロバイダーとは、セッション間で事実や要約を保持するサービスやライブラリであり、フレームワークをスリムに保ちつつメモリをスケーリングするために、多くの場合プラグインとして組み込まれます。
本ガイドでは、Hermes Agentの外部メモリプラグインとして提供されるメモリバックエンド(Honcho、OpenViking、Mem0、Hindsight、Holographic、RetainDB、ByteRover、Supermemory、Mnemosyne、Memori)を比較し、それらがより広い**AIシステムのスタックにどのように組み込まれるかを説明します。同じベンダーは、コミュニティまたは公式統合を通じて、OpenClawや他のエージェントツールにも登場します。AIシステム メモリハブ**には、この記事に加えCogneeや関連するガイドがリストされています。
Hermesに固有のバウンデッドコアメモリ(MEMORY.mdとUSER.md)、フリーズ動作、トリガーについては、**Hermes Agent メモリシステム**を参照してください。HermesのネイティブメモリプロバイダーがOpenClawに対する採用優位性の拡大(GitHubスター数、OpenRouterトークンランキング、エコシステム規模の比較など)にどのように貢献しているかという背景については、OpenClaw vs Hermes Agent: Stars, Downloads & Usage 2026を参照してください。
保持すべきスキルと、スキップしてよいスキル
OpenClawには2つの拡張ストーリーがあり、それらは混同されやすいものです。
プラグインはランタイムを拡張します。スキルはエージェントの振る舞いを拡張します。
まずはプラグイン。スキルの名称を簡潔に。
この記事は、チャネル、モデルプロバイダー、ツール、音声、メモリ、メディア、Web 検索、その他ランタイムの表面機能などを追加するネイティブゲートウェイパッケージであるOpenClaw プラグインについて解説します。
実際のOpenClawシステムはどのように構成されているのか
OpenClawのデモではシンプルに見えます。 しかし、本番環境では、それは一つのシステムへと変貌します。
ほとんどのローカルAIセットアップは、モデルとランタイムから始まります。