
要件からコードへ:仕様駆動開発ワークフロー
意図から検証済みコードまでの5つのフェーズ。
仕様駆動開発(Spec-Driven Development)が機能するのは、仕様が単にキックオフ後に棚上げされる文書ではなく、一連のワークフローである場合です。目的は、大規模な製品要件定義書(PRD)を作成することではありません。
目的は、人間もAIエージェントも本番コードを変更する前に、曖昧さを段階的に解消していくレビュー可能な成果物(アーティファクト)の連鎖を推進することです。
SDDの概念をまだお知りでない場合は、まず仕様駆動開発とは何か?から始めてください。ここでは定義、TDDやBDDとの比較、そして仕様を真実の源(Source of Truth)として扱うことの意義について説明しています。アプリケーションアーキテクチャドキュメント群内の本記事は、運用ガイドです。5つのフェーズを順を追って解説し、各フェーズで成果物に含めるべき内容を示し、AIエージェントの位置づけを説明するとともに、今日すぐにリポジトリにコピーして使える再利用可能なテンプレートを提供します。
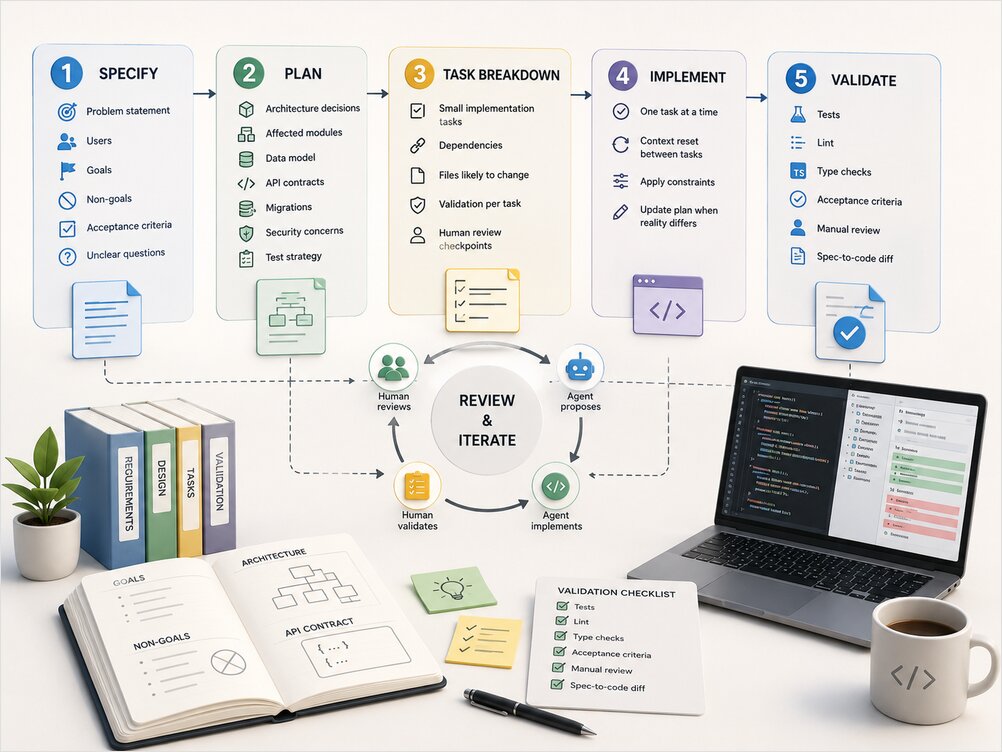
SDDは文書ではなくワークフローである
仕様駆動開発における最も一般的な失敗パターンは、仕様を事務的な書類として扱うことです。チームが長い要件定義書を作成し、ウィキに保存したものの、その後、記憶やチャットスレッド頼みでコーディングしてしまうケースです。仕様は存在していますが、何も駆動していません。これは「ドキュメンテーション・シアター(見せかけのドキュメント化)」であり、仕様がない場合よりも悪化します。なぜなら、誤った安心感を生み出すからです。
機能するSDDワークフローは、各フェーズの開始前にレビューされる成果物の連鎖を生み出します。要件定義はプロダクト側の曖昧さを減らします。設計は技術的な曖昧さを減らします。タスク分解は実行面の曖昧さを減らします。実装は既知の目標に対するコードを生み出します。検証は、その連鎖が維持されていたことを証明します。どのフェーズでもミスが発覚した場合、その時点から成果物を修正して再実行します。メインブランチに3000行もの乖離(ドリフト)が積み重なった後に対応するのではありません。
このワークフローはツール非依存です。Git上のMarkdownファイル、GitHub Spec Kit、Cursorのプラン、Superpowersのような強制スキルパッケージ、あるいはプレーンテキストエディタと規律あるレビュアーでも運用できます。重要なのは、ツールのブランドではなく、シーケンスとレビューゲートです。
フェーズ1 – 要件の定義(Specify)
Specifyフェーズは、何を解決しようとしているか、そして「完成」とは何を指すかを回答するものです。意図的に「どのように作るか」を避けます。要件定義書に「Redisのソートセットを使用する」と書いた瞬間、あなたは要件定義をやめて、間違った文書内で設計を始めてしまったことになります。実装の詳細は要件から除外し、プラン(計画)に書きましょう。
問題文とユーザー
問題を平易な言語で記述した1段落から始めます。影響を受けるユーザーと、その問題を痛感させる状況(ペインポイント)を特定します。良い問題文であれば、計画会議に参加していなかったレビュアーでも、提案されたソリューションが実際にそのペインに対処しているかどうかを判断できます。
APIレート制限機能の例:
フリーティアのAPI利用者は無制限のリクエストを送信可能であり、コストの急増や有料テナントへの悪影響(Noisy-neighbor問題)を引き起こしています。プラットフォーム運営者は、手動介入なしにキーごとの強制可能な上限を設定する必要があります。
ゴール、非ゴール、受入基準
ゴールは、提供しようとする成果物(アウトカム)を記述します。非ゴールは、魅力的な隣接作業のうち、明示的にやらないものを記述します。これらはエージェントの創造性を制限し、AIツールが「親切に」スコープを拡張しようとする場合に不可欠です。
| セクション | 良い例 | 弱い例 |
|---|---|---|
| ゴール | キーごとの上限を超えるリクエストをHTTP 429で拒否する | APIを高速にする |
| 非ゴール | テナントごとの課金ダッシュボード | API全体の性能向上 |
| 受入基準 | 認証されていないリクエストは、レートチェック実行前に401を受信する | エンドポイントは安全である |
受入基準は、それぞれが少なくとも1つのテストに対応付けられるほど正確である必要があります。「エンドポイントは安全である」は受入基準ではありません。「認証されていないリクエストはHTTP 401を受信する」が受入基準です。具体的な基準を書けなければ、その要件はまだ実装できるほど曖昧さを除去できていません。
未解決の質問
まだ決定していないすべての意思決定をリストアップします。不明確な質問があることは、失敗の兆候ではありません。Specifyフェーズがその役目を果たしている証拠です。設計プランを書く前にこれらを解決してください。解決しないと、実装時の手戻りとして曖昧さの代償を払うことになります。
最小限の要件テンプレート:
## Problem
[1段落:誰が困っているのか、なぜか、何がペインを引き起こすのか。]

## Users
- [プライマリユーザーロール]
- [セカンダリユーザーロール]

## Goals
1. [測定可能な成果]
2. [測定可能な成果]

## Non-goals
- [明示的にスコープ外]
- [明示的にスコープ外]

## Acceptance criteria
- [ ] [検証可能な挙動]
- [ ] [検証可能な挙動]

## Open questions
- [ ] [計画をブロックする質問]
フェーズ2 – 設計の計画(Plan)
Planフェーズは、意図(インテント)を技術的な決定に変換します。ここが、Redisのソートセット、モジュール境界、スキーマ変更、API契約、マイグレーション手順、セキュリティ制約、テスト戦略などが属する場所です。プランは、要件定義書とプロジェクトの既存の制約(スタックの選択、意思決定記録、AGENTS.mdやプロジェクト憲章などのファイルに保存された慣習)から導き出されます。
アーキテクチャと影響を受けるモジュール
変更されるモジュール、サービス、またはパッケージを特定し、統合パターンを要約します。機能がサービス境界をまたぐ場合、両側の契約を文書化してください。契約が暗黙のままだと、エージェントはAPIを幻覚(ハルシネーション)します。プランで明示的にすることで、架空のエンドポイントや誤ったレスポンス形式を防げます。
データモデル、API契約、マイグレーション
スキーマ変更、新しいテーブルやフィールド、インデックス要件、後方互換性のルールを文書化します。HTTP APIの場合、メソッド、パス、リクエスト形状、レスポンス形状、エラーコードを記述します。イベントの場合、トピック名、ペイロードスキーマ、配信セマンティクスを記述します。データモデルが変更される場合、マイグレーション手順とロールバック手順を含めます。
セキュリティ、オブザーバビリティ、テスト戦略
セキュリティ制約は、コードレビューでの後付けではなく、プランに属します。認証要件、認可ルール、入力バリデーションの境界、ログに出力してはならないデータを記録します。オブザーバビリティは、本番環境で機能が正常に動作することを確認するために必要なメトリクス、ログ、トレースをカバーすべきです。
テスト戦略は、受入基準と結びつきます。どの基準にユニットテストが必要か、統合テストが必要か、手動検証が必要かを特定します。GoのユニットテストやPythonのユニットテストを使用する場合、追加予定のパッケージとテストファイル名を特定してください。テスト戦略のないプランは、本番環境で初めて発覚するギャップを抱えたままリリースされるプランです。
フェーズ3 – 実装タスクの分解(Tasks)
Tasksフェーズは、プランを独立して実装、レビュー、検証できる程度の小さなスライスに分解します。これにより、エージェント支援開発がレビュー可能になります。巨大な1つの差分(diff)ではなく、それぞれが特定の要件にマッピングされる、焦点の絞られた変更のシーケンスが得られます。
タスクサイズと依存関係
良いタスクは、限定されたファイルセットに触れ、1回のエージェントセッションで完了し、検証ステップで終わります。タスクは依存関係を明示的に宣言すべきです。マイグレーションタスクは、新しいスキーマを読み込むコードより前に実行されます。共有ライブラリの変更は、コンシューマーより前に実行されます。認証ミドルウェアの変更は、新しい挙動に依存するエンドポイントより前に実行されます。
ファイル、検証、レビューチェックポイント
各タスクは、変更される可能性のあるファイル、満たす受入基準、完了の検証方法をリストアップすべきです。検証は、テストコマンド、curlの例、コピー&ペースト可能な手順で記述された手動チェックかもしれません。すべてのタスクは人間のレビューチェックポイントで終わります。レビュアーは、次のタスクを開始する前に、差分がタスク説明と一致していることを確認します。
最小限のタスクエントリ:
### Task 3 -- Add rate-limit middleware

**Depends on:** Task 1 (schema), Task 2 (repository)
**Files:** middleware/ratelimit.go, middleware/ratelimit_test.go, server.go
**Satisfies:** AC-2 (429 over limit), AC-3 (limit headers in response)
**Validate:** `go test ./middleware/...` passes; curl over limit returns 429 with Retry-After
**Review checkpoint:** Confirm middleware runs after auth, before handler
生成されたタスクの爆発に注意してください。AIエージェントは数秒で50個のタスクを含むプランを生成できますが、その大半は冗長か、効率的なレビューのために細かすぎます。中規模な機能のための有用なタスクリストは、50個ではなく、通常5〜15個の項目です。
フェーズ4 – 一度に1つのタスクを実装(Implement)
実装は意図的に狭い範囲に限定されます。1つのタスクを選び、そのタスクに必要なコンテキストのみをエージェントに提供し、検証が通ったら停止します。タスク間のコンテキストリセットはバグではなく機能です。以前の仮定が後の作業を汚染することを防ぎ、差分をレビュー可能な状態に保ちます。
仕様スタックからの制約を適用する
実装エージェントは、要件定義書、設計プラン、現在のタスク説明、プロジェクトレベルの制約を読み取るべきです。制約は、多くのチームがスキップしがちな、最もROI(投資対効果)が高いセクションです。これはエージェントに「何をしないべきか」を伝えます。無関係なモジュールのリファクタリングはしない、この機能の外では公開APIのシグネチャを変更しない、プランを更新せずに新しい依存関係を導入しない、などです。
現実が異なる場合、プランを更新する
実装では予期せぬことが発覚します。ライブラリが想定された挙動をサポートしていない、マイグレーションが予想より時間がかかる、受入基準にエッジケースが欠落している、などです。そのような場合は、続行する前に仕様を更新してください。要件またはプランを修正し、簡単なレビューを経て、修正された成果物に対して実装を再開します。仕様から黙って乖離したコードは、ドリフトが恒久化する原因になります。
フェーズ5 – 仕様に対する検証(Validate)
検証は、SDDがその価値を証明する場所です。検証なしでは、仕様は単なる計画演習にすぎません。検証があれば、仕様はリリースされたコードに対してチェックできる契約になります。
自動チェック
CIでフルテストスイート、リンティング、型チェックを実行します。実用的なスタートポイントが必要な場合は、GitHub Actionsチートシートのパターンを使用して、パイプラインに組み込むことをお勧めします。自動チェックはリグレッション(機能劣化)を検出します。しかし、正しく構築された誤った機能は検出できません。そのため、受入基準のレビューが依然として重要です。
受入基準と手動レビュー
要件定義書の各受入基準を確認します。各基準を「満たしている」「失敗」「延期(理由付き)」としてマークします。手動レビューは、UXの問題、セキュリティのギャップ、欠陥のある仕様に合わせてテストが書かれたため見逃された誤った挙動を検出します。
仕様とコードの差分(Diff)
最終的な検証ステップは、実装を設計プランと比較することです。変更されたファイルは、プランが予測したファイルと一致しましたか?コード内のアーキテクチャ決定は、記録された決定と一致しましたか?差分にある予期しないファイルはシグナルです。プランが不完全か、エージェントが迷走したかのいずれかです。マージ前に、どちらにも注意を払う必要があります。AI開発における仕様、テスト、コードの同期は、この一回限りの差分レビューを、繰り返し可能なトレーステーブルとCIチェックのセットに変換し、ドリフトが誰かに思い出された時だけでなく、すべてのPRで検出されるようにします。
| 検証レイヤー | 検出できること |
|---|---|
| ユニットテストと統合テスト | スコープ内のリグレッションと誤ったロジック |
| リンティングと型チェック | スタイルの問題と型エラー |
| 受入基準のウォークスルー | 仕様に従って構築された誤った挙動 |
| 仕様とコードの差分 | アーキテクチャのドリフトとスコープクリープ |
ワークフローにおけるAIエージェントの位置づけ
AIエージェントは各フェーズのアクセラレーター(加速装置)であり、レビューの代替ではありません。生産的なパターンは、ドラフト作成、レビュー、洗練、そして進めることです。エージェントに問題記述から要件定義書のドラフトを作成させ、ゴール、非ゴール、受入基準が正しいまで意図を編集します。承認された要件から設計プランのドラフトを作成させ、コードが存在する前にアーキテクチャ決定をレビューします。エージェントに1タスクのスライスを順次実装させ、次のタスクを開始する前に各差分を承認します。
エージェントは、最初のドラフトやボイラープレートテストの作成に特に有用です。人間は、誤ったゴール、安全でないアーキテクチャ、微妙なスコープクリープの検出に特に有用です。ワークフローは、どちらかの側がスキップされた場合、つまりエージェントが仕様なしで実装したり、人間がコードに対して検証せずに仕様を書いたりした場合に失敗します。
このワークフロー記事は、意図的にツール非依存を維持しています。ツール固有の実行ガイド(エディタ設定、スラッシュコマンド、エージェント設定)は、AI開発者ツールクラスタの下に属します。プロセスの柱は、ベンダーよりも成果物が重要であるため、ドキュメンテーションプラクティスの下、ここにあります。
仕様駆動開発を殺す一般的なミス
検証前の巨大な仕様。 プロトタイプやスパイク(検証用試作)の前に書かれた30ページの要件定義書は、SDDではなくウォーターフォールの事務作業です。次のフェーズの曖昧さを除去するための最小限の仕様を書き、早期に仮定を検証してください。すべての機能が完全な5フェーズのループを必要とするわけではありません。仕様駆動開発とVibe Codingは、より軽量な構造で十分な場合を説明しています。
曖昧な受入基準。「 高速」、「クリーン」、「ユーザーフレンドリー」といった形容詞は受入基準ではありません。測定可能な挙動に置き換えてください。テストできないものは、確実に実装できません。特にAIエージェントを使用する場合です。
非ゴールの欠如。 非ゴールがなければ、エージェントはデフォルトでスコープを拡張します。キャッシュレイヤーを追加し、隣接モジュールをリファクタリングし、要求していない依存関係を導入します。非ゴールは、事前に「ノー」と言う方法です。
設計フェーズでのテスト計画の欠如。 実装の後にのみ書かれたテストは、意図されたものではなく、構築されたものを確認する傾向があります。プランは、最初の本番ファイルが変更される前に、どの受入基準がどのテストタイプにマッピングされるべきかを特定すべきです。
フェーズ境界でのレビューのスキップ。 プランの前に仕様をレビュー。タスクの前にプランをレビュー。実装の前にタスクをレビュー。各ゲートは安価です。大きなマージ後のドリフト修正は高価です。
生成されたタスクの爆放任。 AI生成の50項目のタスクリストをスケジュールではなく、第一稿として扱ってください。冗長な項目を統合し、大きすぎるものを分割し、要件にマッピングされないタスクを削除してください。
SDDは、各フェーズが曖昧さを減らす場合に機能します。事務作業を生み出す場合に失敗します。
再利用可能なテンプレート
これらをリポジトリにコピーして適応させてください。仕様は機能ブランチの隣に保存し、プルリクエストでレビューし、バージョン管理下に置いて、エージェントと人間が同じソースを読むようにしてください。
要件テンプレート
# Feature -- [name]

## Problem
## Users
## Goals
## Non-goals
## Acceptance criteria
## Open questions
設計テンプレート
# Design -- [feature name]

## Summary
## Affected modules
## Data model changes
## API contracts
## Migrations
## Security
## Observability
## Test strategy
## Risks and mitigations
タスクリストテンプレート
# Tasks -- [feature name]

## Task 1 -- [title]
Depends on:
Files:
Satisfies:
Validate:
Review checkpoint:

## Task 2 -- [title]
...
検証チェックリスト
# Validation -- [feature name]

## Automated
- [ ] All tests pass
- [ ] Lint clean
- [ ] Type check clean

## Acceptance criteria
- [ ] AC-1 --
- [ ] AC-2 --

## Spec-to-code
- [ ] Changed files match plan
- [ ] No undocumented architectural changes
- [ ] Spec updated if implementation differed
結論
仕様駆動開発は、より多くの文書を書くことではありません。Specify、Plan、Task、Implement、Validateを、各ステップにレビューゲートを設けて進めることです。各フェーズは、次のアクター(人間またはエージェント)に、前のフェーズよりも少ない推測を残すべきです。
小さく始めてください。中規模な機能1つに対して完全なワークフローを実行してください。成果物はMarkdownとしてリポジトリに保管します。現実が乖離した場合は仕様を更新します。マージ前に検証します。連鎖が機能すれば、ドリフトが少なくなり、レビュー可能な小さな差分が得られ、セッションリセットやチームの引き継ぎを生き延びる、意図の永続的な記録が得られます。
連鎖が事務作業になった場合、スコープを削減してください。レビューを削減するのではありません。検証された2ページの仕様は、誰も読まない30ページの仕様よりも優れています。
関連リンク
- GitHub Spec Kit documentation – 同様のSpecify-Plan-Tasks-Implementループを実装するオープンソースツールキット
- Superpowers Quickstart: Install, Workflow, and Tryout – 必須のレビューゲート付きで、この5フェーズのループを自動化するインストール可能なスキルパッケージ
- Martin Fowler on Spec-Driven Development tools – Kiro、Spec Kit、Tesslの分析
