
投機的デコーディング:LLM推論を20〜50%高速化
品質を落とさずにLLM推論を高速化する実践ガイド
70Bモデルは1回のフォワードパスで1トークンを生成し、各パスでVRAMから重みを読み込み、コンテキスト全体のAttentionを計算し、メモリを同期します。トークンの間では、GPUはシーケンシャルな依存関係が解決するのを待っている間にアイドル状態になります。
H100上では、70Bモデルは30〜50msごとに1トークンを生成します。GPUには複数のトークンを並列で処理する計算容量が十分にあります。しかし、シーケンシャルな依存関係によりそれが妨げられています。各トークンは前のトークンに依存しているため、パイプラインがストール(停止)してしまうのです。
投機的デコーディング(Speculative Decoding)は、出力分布を変更せずに、通常1トークンを生成するのにかかる時間で複数のトークンを生成できるようにすることで、このボトルネックを打破します。得られるトークンは、標準的な自己回帰的デコーディングから得られるものと統計的に同一です。異なるのは、それらが得られる速さだけです。
本ガイドでは、メカニズム、2026年に利用可能なバリアント、受入率のトレードオフ、そしてllama.cpp、vLLM、SGLang、TensorRT-LLMにおける実用的なセットアップについて説明します。
自己回帰的デコーディングの仕組み(なぜ遅いのか)
投機的デコーディングを理解するには、それが回避している自己回帰制約について理解する必要があります。標準的な自己回帰的生成は、トークンをシーケンシャルに処理します。
- 現在のコンテキストでモデルに対するフォワードパスを実行する。
- 出力分布から次のトークンをサンプリングする。
- トークンをコンテキストに追加する。
- 繰り返す。
各ステップには、完全なフォワードパスが必要です。VRAMからの重み読み込み、コンテキスト全体のAttention計算、そして単一トークンの生成です。70Bパラメータのモデルの場合、H100上では1トークンあたり概ね30〜50msかかります。GPUには余裕のある計算容量がありますが、並列により多くの仕事を処理できるにもかかわらず、シーケンシャルな依存関係によりそれが妨げられています。
計算とVRAMのギャップ
最新のGPUは、単一トークン生成に必要なものより多くのFLOPsを持っています。そのため、本当のボトルネックはメモリ帯域幅です。各フォワードパスにおいて、重みをVRAMから計算ユニットにストリームする必要があるためです。1トークンずつ生成する場合、GPUは有用な計算を行うよりも、メモリ転送を待つ時間に多くの時間を費やしています。
投機的デコーディングは、メモリ転送あたりのGPUへの作業量を増やすことでこれに対応します。1フォワードパスあたり1トークンではなく、Kトークンを生成することで、メモリコストを複数の出力に配分(アモルタイズ)します。
ドラフト・検証メカニズム
投機的デコーディングは、繰り返しのドラフト・検証サイクルで動作します。高速なドラフト機構がK個の候補トークンを提案します。これは小さなドラフトモデル、n-gramルックアップ、またはターゲットモデルに接続された予測ヘッドからのものです。その後、ターゲットモデルが1回のフォワードパスですべてのK個を検証します。ドラフトフェーズは安価で、通常はターゲットモデルのフォワードパス時間の5〜20%です。一方、検証では、各ドラフトトークンがターゲットモデルが生成したはずの内容と比較され、最も長い一致するプレフィックスが受入され、最初の拒絶以降から再サンプリングが行われます。
Kトークンの検証には、自己回帰的に1トークンを生成するのと同じくらいのコストがかかります。したがって、ドラフトが正しければ、1回の検証ステップの代価でKトークンを得られます。
具体的な例
ドラフトモデルが5つのトークンを提案したとしましょう:["I", " like", " cooking", " and", " traveling"]。ターゲットモデルは1回のフォワードパスでそれらを検証します。
| トークン | ドラフト | ターゲットは同意するか? |
|---|---|---|
| 1 | “I” | ✓ |
| 2 | " like" | ✓ |
| 3 | " cooking" | ✗ (ターゲットは " playing" というはず) |
| 4 | " and" | — (評価されない) |
| 5 | " traveling" | — (評価されない) |
ターゲットはトークン1と2を受け入れ、トークン3に対して " playing" を生成します。これにより、1サイクルで3つのトークンが生成され、3回の独立したフォワードパスが必要なくなります。もしドラフトがトークン5まで正しかった場合、1回の検証コストで5つのトークンが得られ、そのサイクルだけで5倍の高速化が実現します。
検証のボトルネック
実際には、検証が実行時間の大半を占めています。方法やモデルサイズによって異なりますが、サイクルの42〜95%です。ターゲットモデルのフォワードパスがボトルネックであり、拒絶されたトークンは無駄な計算を表しています。
これが受入率がこれほど重要である理由です。最初のトークン以降の各拒絶トークンは、無駄な検証作業です。最高の投機的デコーディング手法は、生を受けた受入率だけでなく、サイクルあたりの期待受入トークン数を最大化します。
数学的保証
投機的デコーディングの最も重要な特性の一つは、ターゲットモデルからの標準的な自己回帰サンプリングと完全に同一の分布からのトークンを生成することです。検証ステップはリジェクションサンプリング(拒絶サンプリング)を使用します。ドラフトがトークンxを提案すると、ターゲットモデルは自身の確率 p(x) を計算し、ドラフトは p_draft(x) を計算します。受入確率は以下の通りです。
min(1, p(x) / p_draft(x))
ターゲットが同意する場合(p(x) ≥ p_draft(x))、トークンは常に受入されます。ターゲットが同意しない場合、トークンは比率に比例する確率で受入され、拒絶されたトークンは残差分布から再サンプリングされます。
r(x) = max(0, p(x) - p_draft(x)) / Σ max(0, p(y) - p_draft(y))
この手順により、出力シーケンスがターゲットモデルの分布に正確に従うことが保証されます。これが投機的デコーディングがロスレス(品質損失なし)である理由です。ドラフトモデルは品質ではなく速度に影響を与えます。得られるトークンは、標準的なデコーディングと統計的に区別がつかず、同じペルプリティと分布を持ちます。異なるのはレイテンシだけです。
ドラフトモデル戦略
ドラフト機構は、最も重要な変数です。異なるアプローチには、セットアップの複雑さ、受入率、高速化の効果において異なるトレードオフがあります。
独立したドラフトモデル
最もシンプルなアプローチは、ターゲットモデルと並んでより小さなモデルを読み込むことです。通常、7B〜70Bのターゲットに対して1B〜3Bのモデルがドラフトを行います。
メリット:
- 概念的に簡単
- いかなるターゲットモデルでも動作する
- ドラフトモデルはターゲットの分布に一致するように調整できる
デメリット:
- VRAMに第二个モデルを読み込む必要がある(サイズによって1〜4 GB)
- ドラフトモデルの品質が受入率を直接決める
- クロスファミリーのドラフト(例:QwenがLlamaのドラフトを行う)は通常、パフォーマンスが低い
経験則: 同じファミリーのモデルを使用してください。Gemma 2 2BはGemma 2 27Bのドラフトとしてよく機能します。Llama 3.2 1BはLlama 3.1 70Bのドラフトとしてよく機能します。クロスファミリーのドラフトは、トークン分布が異なるため、受入率が低くなる傾向があります。
互換性のあるドラフトモデルの見つけ方
与えられたターゲットに対して、すべての小さなモデルがドラフトモデルとして機能するわけではありません。重要な要因は分布の整合性です。つまり、ドラフトモデルの出力確率がターゲットのそれとどれだけよく一致しているかです。
| ターゲットモデル | 推奨ドラフト | ファミー一致 |
|---|---|---|
| Llama 3.1 70B | Llama 3.2 1B-3B | 同じ |
| Llama 3.1 8B | Llama 3.2 1B | 同じ |
| Qwen 3 27B | Qwen 3 0.6B-1.8B | 同じ |
| Gemma 2 27B | Gemma 2 2B | 同じ |
| Mixtral 8x7B | Phi-3 4B (Mixtralデータで訓練) | クロス (注意) |
黄金ルール:ドラフトモデルの受入率が50%を下回る場合、投機的デコーディングは実際には遅くなる可能性があります。多くの提案が拒絶される場合、ドラフトモデルの実行オーバーヘッドと検証のオーバーヘッドは、メリットを上回ります。
EAGLEとEAGLE-3:予測ヘッド
EAGLE (Efficient Architecture Guided Language Model Estimation) は、独立したドラフトモデルの必要性を排除します。代わりに、ターゲットモデルの内部レイヤーに軽量な自己回帰的予測ヘッドを接続します。
EAGLEの動作方法
EAGLEは、ターゲットモデルの中間レイヤーからの隠れ状態を受け取り、将来のトークンを予測する予測ヘッドを訓練します。推論時:
- ターゲットモデルがレイヤーをフォワードパスします。
- 各レイヤーで、EAGLEヘッドが隠れ状態を読み取り、将来のポジションのトークンを提案します。
- 複数のヘッドが並列で動作し、それぞれが異なる将来のタイムステップを予測します。
- ターゲットモデルが1回のパスですべての提案を検証します。
利点:EAGLEヘッドは、ターゲットモデルの分布に一致するように特に訓練されています。ターゲットの内部表現を直接見るため、独立したドラフトモデルよりもはるかに良い整合性を持ちます。
EAGLE-3の改良点
EAGLE-3 (2025) は、3つの重要な変更でアプローチを改善しています。
- レイヤー選択: 各レイヤーにヘッドを接続するのではなく、EAGLE-3はベイズ最適化を使用して最適な出口レイヤーを選択し、オーバーヘッドを削減します。
- マルチトークン予測: 各ヘッドが同時に複数のトークンを予測し、計算コストが比例的に増えることなくドラフト深度を増やします。
- 訓練効率: EAGLE-3はターゲットモデル自身の生成データで訓練され、分布内ワークロードでの受入率を向上させます。
受入率: EAGLE-3は、分布内ワークロードで通常60〜80%の受入率を達成します。一方、独立したドラフトモデルでは40〜60%です。高い反復性を持つコード生成ワークロードでは、受入率は85%を超える場合があります。
セットアップ: EAGLE-3には、ターゲットモデル用の事前訓練済みヘッドが必要です。NVIDIAは、TensorRT-LLMおよびHuggingFace上のSpeculative Decoding Modulesコレクションを通じて、いくつかの人気モデル用のEAGLE-3ヘッドを提供しています。vLLMとSGLang向けのサードパーティ実装も存在します。
P-EAGLE:並列ドラフティング (2026年3月)
EAGLE-3の主な制限は自己回帰的なドラフティングです。各ドラフトトークンが前のものに従属するため、K個のドラフトトークンを生成するにはドラフトヘッドを通したK回のシーケンシャルなフォワードパスが必要となり、ドラフトのオーバーヘッドはKに対して線形に増加します。P-EAGLEは、最大10トークンを並列で予測するように訓練された軽量な4層ドラフターを通した1回のフォワードパスですべてのK個のドラフトトークンを生成することで、この上限を除去します。
結果: P-EAGLEは、NVIDIA B200上の実際のワークロードで、バニラEAGLE-3に対して最大1.69倍の高速化を実現します。K値が大きいほど利点は広がります。EAGLE-3のシーケンシャルドラフティングがボトルネックになる場所では、P-EAGLEの並列ドラフティングは追加のコストを発生させません。
vLLMでのセットアップ: HuggingFaceから事前訓練済みのP-EAGLEヘッドをダウンロードし、vLLM設定で "parallel_drafting": true に設定し、同じ --speculative-model フラグを使用してください。vLLMが残りを行います。P-EAGLEは現在EAGLEベースの投機的デコーディングの最先端であり、2026年にEAGLEをデプロイする場合は、P-EAGLEを使用するバリアントです。
n-gram投機的デコーディング
n-gram投機的デコーディングは、ニューラルドラフトをプロンプト履歴とのパターンマッチングに置き換えます。アルゴリズムはコンテキスト内で反復されたn-gramシーケンスを探し、現在のトークンシーケンスが以前に見られたパターンと一致する場合、以前にそのパターンに続いていたトークンを提案します。例えば、モデルがすでに def calculate_total(items): を生成し、再び def calculate_total( に遭遇した場合、以前の出現に基づいて次のトークンはおそらく items): であると分かります。
n-gramマップのバリアント (ngram-map-k, ngram-map-k4v) は、線形スキャンの代わりに高速なルックアップのためにハッシュテーブルを使用します。ハッシュキーはサイズNの現在のn-gram、値はそれに続いたトークンシーケンスです。
メリット:
- VRAMオーバーヘッドゼロ — 追加のモデルを読み込む必要がない(ハッシュテーブルで約16 MB)
- 反復的ワークロード(コード編集、リファクタリング、テンプレート生成)に対して極めて高速
- 高い自己類似性を有するワークロードでは、受入率が90%以上に達する可能性がある
デメリット:
- 新規生成には無効 — パターンが以前に出現したことがない場合、n-gramに提案できるものがない
- クリエイティブなワークロードや多様なワークロードでは、受入率がほぼゼロに低下する
- 限られたドラフト深度(通常、一致ごとに2〜4トークン)
最適な用途: コードリファクタリング、テンプレート入力、反復的なドキュメント生成、そしてモデルが類似パターンを再訪するあらゆるワークロード。最も不向きな用途:クリエイティブライティング、オープンエンドなチャット、推論タスク。
パラメータチューニング
n-gramのパラメータは、予想以上に重要です。デフォルトはコードには機能しますが、テキストワークロードでは調整が必要です。
| パラメータ | デフォルト | コード | テキスト | 注釈 |
|---|---|---|---|---|
size-n (ルックアップ長) |
12 | 12-16 | 8-10 | 長いn-gramは偽陽性を減らすものの、短いパターンを取りこぼす |
size-m (ドラフト長) |
48 | 48 | 32 | 長いドラフトは一致ごとのトークン数が増えるが、拒絶も増える |
min-hits |
1 | 1 | 2 | min-hitsを高くすると偽陽性が減るが、一致数が減る |
テキストワークロードでは、size-n を8〜10に減らし、min-hits を2に増加させてください。これは、1回あたりの受入率の上昇を代償に、一致の頻度をトレードオフします。
セルフ投機的デコーディング
セルフ投機的デコーディング(LayerSkipまたはself-speculationとも呼ばれる)は、モデル自身の部分的な計算をドラフトとして使用するため、個別のモデルは必要ありません。
動作方法
各トークンに対して完全なモデルを実行する代わりに、セルフ投機的デコーディングは、一部のトランスフォーマーレイヤーをスキップした切り詰め版を実行して安価にドラフトトークンを生成し、その後、完全なモデルが提案を検証します。
例えば、32レイヤーのモデルは、ドラフトのためにレイヤー16のみを実行し、その後、レイヤー32すべてで検証する場合があります。切り詰められたフォワードパスは、より少ないレイヤーを処理するためにより高速であり、ドラフトトークンはターゲットと同じ初期レイヤーを見ることで利益を得ます。
メリット:
- 追加のモデル重みを読み込む必要がない
- ターゲット分布に自然に整合(同じアーキテクチャ、部分的なレイヤー)
- 深いレイヤーに大きな冗長性があるモデルに効果的
デメリット:
- 部分フォワードパスをサポートするために推論エンジンを修正する必要がある
- KVキャッシュの複雑さ — ドラフトは部分KVキャッシュを使用し、完全なモデルのキャッシュと調整する必要がある
- 受入率は通常、EAGLEやよくチューニングされたドラフトモデルより低い
llama.cpp実装: PR #18471 は、コンテキスト履歴をドラフトとして使用するセルフ投機的デコーディングを導入しました。モデルは自身の生成履歴からのトークンを再利用して継続を提案します。これは、コンテキストウィンドウ内でパターンが反復されるコーディングワークロードに特に効果的です。
MTP (マルチトークン予測)
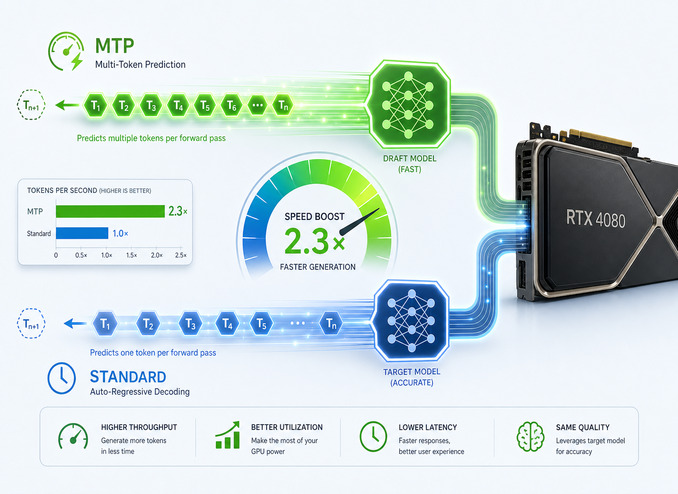
MTPは、特定のモデルチェックポイントに直接組み込まれた投機的デコーディングの専門的な形態です。Qwen 3.6は、標準版とMTP対応版の両方のGGUFバリアントをリリースしています。
違い: MTPヘッドは、訓練時にモデルアーキテクチャに焼き込まれます。モデルは複数の将来のトークンを1回のフォワードパスで提案する追加の予測ヘッドを持っています。個別のドラフトモデルはありません — MTPヘッドはターゲットモデル自体の一部です。
トレードオフ:
- 管理すべきドラフトモデルがない —
--spec-type draft-mtp --spec-draft-n-max NでMTPが有効になります - MTPヘッドは約1〜2 GBのVRAMオーバーヘッドを追加する
- スパースルーティングがMTPヘッドを安価に保つMoEアーキテクチャ(Qwen 3.6 35B-A3Bなど)で最もよく機能する
Qwen 3.6 27Bと35BにおけるMTPと標準デコーディングの比較に関する詳細なベンチマークについては、Qwen 3.6 MTP vs Standard on 16GB GPU を参照してください。
受入率:実際の意味するもの
受入率(α)は、投機的デコーディングのパフォーマンスにおいて最も重要な単一指標です。これが高速化を得ているのか、オーバーヘッドを支払っているのかを決定します。
高速化の公式
検証パスあたりの期待受入トークン数:
E[accepted] = α × K
ここで、Kはサイクルごとに提案されるドラフトトークン数です。α = 0.7、K = 5の場合、パスあたり3.5トークンを受け入れます。これは標準デコーディング(パスあたり1トークン生成)に対する3.5倍の高速化です。
手法別受入率
| 手法 | 一般的なα範囲 | 最適なワークロード |
|---|---|---|
| ドラフトモデル (同一ファミリー) | 40-60% | 一般チャット、推論 |
| ドラフトモデル (クロスファミリー) | 20-40% | ほぼ推奨されない |
| EAGLE-3 | 60-80% | 一般ワークロード、コード |
| P-EAGLE | 65-85% | 一般ワークロード、深い投機的デコーディング |
| n-gram | 10-90%+ | ワークロード依存 (反復的なものでは高い、新規のものはほぼゼロ) |
| MTP | 50-70% | 特にQwen 3.6モデル |
| セルフ投機的 | 30-50% | コーディング、反復パターン |
受入率が低下する時
受入率は生成全体を通じて一定ではありません。以下によって変化します。
- トークン位置: 初期のトークンは受入率が高くなる傾向があります(より多くのコンテキスト、より少ない不確実性)。後期のトークンは、モデルにより多様な継続を探索するため、低下します。
- ワークロードタイプ: 反復パターンのコード編集では α > 80% が見られます。オープンエンドなクリエイティブライティングでは α < 40% が見られます。
- 温度: 温度が高いほど、ドラフトとターゲット間の分岐が増え、受入率が低下します。投機的デコーディングは低温度 (0.0-0.7) で最もよく機能します。
重要な閾値: 効果的な受入率(α × K)が1.0を下回ると、投機的デコーディングは標準デコーディングより遅くなります。ドラフトのオーバーヘッドと検証時間は、単一の自己回帰ステップのコストを上回ります。
本番環境での投機的デコーディング:実際何が起きるか
研究論文は2〜4倍の高速化を報告していますが、本番環境のベンチマークはよりニュアンスのある物語を語っています。高速化はバッチサイズとともに縮小し、検証がサイクル時間の大半を占め、すべてのワークロードで勝ち抜く単一の手法は存在しません。
SpecDecode-Bench の調査結果 (2026)
vLLM上で4つのモデルと6つのワークロードに対し、5つのSDバリアント(n-gram、EAGLE、EAGLE-3、Draft-Model、MTP)の体系的な評価により、以下が明らかになりました。
-
SDは動作するが、高速化はバッチサイズとともに縮小する。 バッチサイズ1では、Llama-3-70B上でEAGLEは最大1.96倍を達成します。しかし、バッチサイズ128では、これ1.21倍に低下します。高い並行性ではシステムが計算律速になり、投機的デコーディングに余剰するGPUのアイドル容量が少なくなるためです。
-
検証が実行時間の大半(42-95%)を占める。 ターゲットモデルのフォワードパスがボトルネックです。拒絶トークンにおける無駄な検証を減らすことは、改良のための最も有望な道筋です。
-
すべての場所で勝ち抜く単一の手法は存在しない。 EAGLE-3は最もバランスの取れた選択肢です。ターゲットモデルが大きい場合(70B以上)にドラフトモデル手法が優れます。n-gramはコード編集や高重複タスクに最適です。
-
オラクル分析はギャップを明らかにする。 統合されたn-gram + EAGLE戦略の理論的上限は、コード編集ワークロードで約4.9倍に達しますが、現在の実装は2〜3倍しか達成していません。最適化の余地があります。
実用的な高速化の期待値
| シナリオ | 期待される高速化 |
|---|---|
| 70Bモデル、単一リクエスト、EAGLE-3 | 1.5-2.0x |
| 70Bモデル、バッチ32、EAGLE-3 | 1.2-1.5x |
| 8Bモデル、単一リクエスト、ドラフトモデル | 1.3-1.8x |
| コード編集、n-gram | 2.0-4.0x (ワークロード依存) |
| クリエイティブライティング、すべての手法 | 1.0-1.3x (しばしば見合わない) |
| Qwen 3.6 27BでのMTP、16GB GPU | 1.5-1.7x |
| B200でのP-EAGLE、単一リクエスト | 2.0-3.0x |
バッチサイズの影響は重要です。小さなバッチでは、投機的デコーディングに余剰するGPUのアイドル計算容量があります。大きなバッチでは、システムがすでに飽和しており、投機的デコーディングは比例した利益なしにオーバーヘッドを追加します。
本番環境でのモニタリング
本番環境で受入率を追跡すべきです。受入率の低下は、ワークロードが変更されたか、またはドラフトモデルの再訓練が必要であるかを示しています。つまり、ドラフトモデルがターゲットから乖離しているシグナルです。
監視すべき主要な指標:
- リクエストあたりの受入率(ベースライン付近で安定しているべき)
- 投機的デコーディングあり/なしでの毎秒のトークン数(実際の高速化)
- サイクル時間に対する検証時間の割合(42-95%であるべき)
- ドラフトモデルのフォワードパス時間(ターゲットモデル時間の20%未満であるべき)
受入率が40%を下回った場合、そのリクエストに対して投機的デコーディングを無効にしてください。オーバーヘッドが見合いません。
実用的なセットアップ
エンジンの選択は、ドラフト戦略と同じくらい重要です。各ランタイムがバッチング、API互換性、スループットをどのように処理するか、投機的デコーディングのパスを選ぶ前に確認してください。 Ollama vs vLLM vs LM Studio and other local runtimes
llama.cpp
一般的なサーバーセットアップとGGUFの読み込みについては、まず llama.cpp quickstart から始め、以下のフラグがその上に投機的デコーディングを追加します。
llama.cppは --spec-type フラグを通じて、複数の投機的デコーディング手法をサポートしています。
# ドラフトモデル (独立)
llama-server \
  --model target-model.gguf \
  --draft-model draft-model.gguf \
  --spec-draft-n-max 4 \
  --parallel 1  # 必須: 投機的デコーディングでは --parallel 1

# n-gram
llama-server \
  --model target-model.gguf \
  --spec-type ngram-simple \
  --spec-ngram-simple-size-n 12 \
  --spec-ngram-simple-size-m 48

# n-gram (テキストワークロード調整)
llama-server \
  --model target-model.gguf \
  --spec-type ngram-simple \
  --spec-ngram-simple-size-n 8 \
  --spec-ngram-simple-size-m 32 \
  --spec-ngram-simple-min-hits 2

# MTP (Qwen 3.6)
llama-server \
  --model Qwen3.6-27B-MTP.gguf \
  --spec-type draft-mtp \
  --spec-draft-n-max 2

# セルフ投機的 (コーディングワークロード)
llama-server \
  --model target-model.gguf \
  --spec-type draft-self
重要なフラグ:
--parallel 1— llama.cppでの投機的デコーディングは単一バッチモードが必要です。これは現在の制限事項です。--spec-draft-n-max— サイクルあたりのドラフトトークン数。3〜5から開始してください。高い値はVRAMへの圧力を増大させます。--spec-ngram-simple-size-n— ルックアップn-gramの長さ。デフォルトの12はコードによく機能します。テキストの場合は8に減らします。
一般的な落とし穴:
--parallel 1を忘れる — サーバーは投機的デコーディングをサイレントに無視します。- クロスファミリーのドラフトモデルを使用する — 受入率が崩壊し、いかなる高速化も無に帰します。
--spec-draft-n-maxを高すぎる値に設定する — 各追加のドラフトトークンは、ドラフトバッファのためにVRAMを消費します。5〜8あたりで効果の逓減が始まります。
vLLM
vLLM quickstart はベースのデプロイをカバーします。以下のフラグは、既存のvLLMサーバー上で投機的デコーディングを有効にします。
vLLMは --speculative-model と --speculative-num-steps フラグを通じて投機的デコーディングをサポートしています。
# ドラフトモデル
vllm serve target-model \
  --speculative-model draft-model \
  --speculative-num-steps 5 \
  --speculative-accept-length 5

# EAGLE-3
vllm serve target-model \
  --speculative-model EAGLE-target-model/ \
  --speculative-num-steps 7 \
  --speculative-draft-tensor-parallel-size 1

# P-EAGLE (並列ドラフティング)
vllm serve target-model \
  --speculative-model P-EAGLE-target-model/ \
  --speculative-num-steps 7 \
  --speculative-parallel-drafting true

# n-gram
vllm serve target-model \
  --speculative-method ngram \
  --speculative-num-steps 5 \
  --ngram-context-size 12
vLLMの投機的デコーディングは連続バッチングと統合されているため、並列ワークロード下でも動作します。スケジューラーは単一のフォワードパス内の複数のトークンスロットを処理し、メモリマネージャーはドラフトモデルとターゲットモデルの両方のKVキャッシュを処理します。
SGLang
SGLangは --speculative-algorithm フラグを通じて投機的デコーディングをサポートしています。
python -m sglang.launch_server \
  --model-path target-model \
  --speculative-algorithm ngram \
  --ngram-context-size 12 \
  --ngram-max-candidate-tokens 6
SGLangのRadixAttentionアーキテクチャは、プレフィックスキャッシュが検証コストを削減するため、投機的デコーディングと相性が良いです。ターゲットモデルは共有プレフィックスに対してキャッシュされたAttentionを再利用し、各検証パスをコールドフォワードパスよりも安価にします。
TensorRT-LLM
TensorRT-LLMは、Triton Inference Serverと組み合わせた本番環境向けグレードの投機的デコーディングを提供します。セットアップは複雑ですが、NVIDIAハードウェア上で最高のパフォーマンスを提供します。
- ターゲットモデルとドラフトモデルの両方に対してTensorRTエンジンを構築します。
- 投機的デコーディング設定を指定する
model.yamlでモデルリポジトリを設定します。 - LLM API / PyTorchバックエンドでTritonを起動します。
TensorRT-LLMは、ドラフトモデルとEAGLE-3の両方のバリアントをサポートします。コード生成ワークロードにおいて、TensorRT-LLMのn-gram投機的デコーディングは、本番環境デプロイで2〜3倍のレイテンシ削減を実証しています。
投機的デコーディングを使用すべき時
使用すべき時
- 大きなターゲットモデル (7B+): ドラフト機構のオーバーヘッドは、ターゲットの計算にわたってアモルタイズされます。ターゲットモデルが遅いほど、投機的デコーディングは輝きます。ターゲットが大きいほど、高速化は価値が高くなります。
- 低温度ワークロード: 投機的デコーディングは、ターゲットモデルの分布が集中し、ドラフトが一致する可能性が高まる温度 0.0-0.7 で最もよく機能します。
- インタラクティブなアプリケーション: レイテンシに敏感なワークロード(チャット、コード補完、エージェントツールコール)が最も恩恵を受けます。GPUがすでに飽和しているバッチ処理は、恩恵が少ないです。
- コード生成と編集: コードパターンにおける高い反復性は、n-gramおよびセルフ投機的デコーディングを特に効果的にします。
スキップすべき時
- 小さなターゲットモデル (< 3B): ドラフトモデルのオーバーヘッドが、ターゲットのフォワードパス時間に近接します。高速化はわずか、またはマイナスです。
- 高温度サンプリング: 温度 > 0.7 では、ターゲットモデルの分布が広すぎて、ドラフトが一貫して一致することはできません。
- クリエイティブライティングとオープンエンドな生成: 新規コンテンツでの低い受入率により、オーバーヘッドが見合わなくなります。
- 大きなバッチサイズ (> 32): システムが計算律速になり、投機的デコーディングは比例した利益なしにオーバーヘッドを追加します。SpecDecode-Benchは、バッチサイズが1から128に増加するにつれ、高速化が1.96倍から1.21倍に低下することを示しています。
手法の組み合わせ
高度なセットアップでは、複数の投機的デコーディング戦略を組み合せます。SpecDecode-Benchのオラクル分析は、n-gramとEAGLEを適応的に組み合わせることで、コード編集ワークロードで高速化を4.9倍まで押し上げられることを示しました。
アイデアは、受入率が高くオーバーヘッドがほぼゼロである以前に出現したパターンにn-gramを使用し、新規トークンに対してはEAGLEにフォールバックすることです。実際には、これにはマルチメソッド投機的デコーディングへのエンジンサポートが必要です。vLLMとTensorRT-LLMには実験的なサポートがありますが、本番環境グレードの実装はまだ成熟の過程にあります。
現時点では、最も実用的な組み合わせはllama.cppでのMTP + n-gramです。MTPがニューラルな投機的デコーディングを処理し、n-gramがMTPが取りこぼす反復パターンを捕捉します。Qwen 3 27Bでは、この組み合わせは標準の67 tokens/secに対して120 tokens/secを達成し、1.8倍の高速化となります。
コストに関する考慮事項
投機的デコーディングは、計算とレイテンシをトレードオフします。トークンあたりの総計算量はほぼ同じです — ただ、シーケンシャルではなく並列により多くの仕事をしているだけです。
GPUコストへの影響:
- 単一リクエストのレイテンシが20〜50%改善され、これはインタラクティブなアプリケーションにとって重要です。
- スループット(多数のリクエスト間のtokens/sec)はあまり改善されません — 大きなバッチサイズではGPUがすでに飽和しているためです。
- VRAM使用量は、ドラフトモデルのフットプリント分増加します(独立したドラフトでは1〜4 GB、n-gram/EAGLEでは最小限)。
クラウド推論: H100あたり$2-4/時間において、投機的デコーディングはトークンあたりのコストを増やすことなく、リクエストあたりのレイテンシを削減します。GPUがすでに飽和しているバッチ処理では、コストメリットは最小限です — いずれにせよ同じGPU時間を支払っているためです。
投機的デコーディングが費用を節約する時: リクエストごとに課金し、タイムトゥファーストトークン(初回トークンまでの時間)を削減したいインタラクティブなアプリケーション。2倍の高速化は、ユーザーの待機時間が半分になり、同じハードウェアでより多くのリクエストを毎秒処理できることを意味します。
節約にならない時: GPU利用率をすでに最大化しているバッチ処理。投機的デコーディングからの追加の計算はスループットを増やしません — ただレイテンシプロファイルを変えるだけです。
今後の展望
投機的デコーディングは、研究上の新奇性から本番環境の標準へ成熟しています。フロンティアは、現在の制限を超えて押し出しています。
-
モデルレベルの並列生成: 投機的デコーディングは、出力分布に触れることなく、推論 レイヤーでフォワードパスあたり複数のトークンを押します。拡散言語モデルは、構造的に異なる賭けを行い、モデルアーキテクチャ 自体の一部としてフォワードパスあたり複数のトークンを生成します。それらが上記のドラフト・検証アプローチ、およびトランスフォーマー後の風景の片端にある状態空間モデルやJEPAワールドモデルと比較してどのように異なるかについては、what comes after LLMs を参照してください。
-
Speculative Speculative Decoding (SSD): ドラフティングと検証のステージを別々のハードウェア間で並列化します。ドラフトモデルは非同期で動作し、複数の可能性のある検証結果に対して事前投機します。初期の結果は、最適化された投機的デコーディングに対して最大2倍、自己回帰デコーディングに対して5倍の高速化を示しています。まだ本番環境対応ではありませんが、方向性は明確です。
-
SpecSA (Sparse Speculative Verification): 投機的デコーディングと動的スパースAttentionを組み合わせます。スパースAttentionを検証指向のワークロードに変換し、自己回帰スパースデコーディングに対して最大3.49倍のエンドツーエンドのスループットを達成します。スパースAttentionがすでに使用中である長いコンテキストモデルに関連します。
-
適応的投機的デコーディング: ワークロード特性に基づいて、n-gram、EAGLE、ドラフトモデルの手法の間で自動的に切り替えます。オラクル分析は、重要な未開拓のポテンシャルを示しています — 現在の実装は2〜3倍しか達成していませんが、理論的限界は4.9倍です。
-
マルチモーダル投機的デコーディング: ドラフト・検証をビジョン言語モデルや動画生成に拡張します。初期の調査は、同じ原則が適用されることを示していますが、非テキストモダリティに対しては検証戦略の適応が必要です。
意思決定フレームワーク
| 質問 | 回答 | 推奨 |
|---|---|---|
| ターゲットモデルのサイズ? | < 3B | 投機的デコーディングをスキップ |
| ターゲットモデルのサイズ? | 7-13B | n-gramまたはセルフ投機的を使用 (低いオーバーヘッド) |
| ターゲットモデルのサイズ? | 30B+ | ドラフトモデルまたはEAGLE-3を使用 (大きなターゲット = より多くの利益) |
| ワークロードタイプ? | コード編集/リファクタリング | n-gram + EAGLEの組み合わせ |
| ワークロードタイプ? | 一般チャット | EAGLE-3またはP-EAGLE |
| ワークロードタイプ? | クリエイティブライティング | 投機的デコーディングをスキップ |
| バッチサイズ? | 1-4 (インタラクティブ) | 投機的デコーディングが最も役立つ |
| バッチサイズ? | 32+ (スループット) | 投機的デコーディングの恩恵は小さい |
| 温度? | 0.0-0.7 | 投機的デコーディングに適している |
| 温度? | > 0.7 | 投機的デコーディングをスキップ |
| ハードウェア? | 16GB GPU | n-gramまたはMTPを使用 (低いVRAMオーバーヘッド) |
| ハードウェア? | 24GB+ GPU | ドラフトモデルまたはEAGLE-3が実行可能 |
| エンジン? | vLLM | EAGLE-3またはP-EAGLE (最良の統合) |
| エンジン? | llama.cpp | n-gramまたはMTP (最もシンプルなセットアップ) |
| エンジン? | TensorRT-LLM | EAGLE-3またはドラフトモデル (本番環境グレード) |
