Kostenoptimierung für LLM-Systeme: Wo das Geld tatsächlich fließt

Kostenoptimierung für LLM-Systeme: Wo das Geld tatsächlich fließt

Verwende Tokens dort, wo es wirklich zählt.

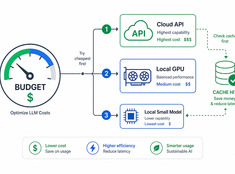
Die Kosten für LLMs steigen linear mit der Nutzung. Ein System, das täglich 10.000 Anfragen mit $0,01 pro Anfrage verarbeitet, kostet täglich $100 — also $365 pro Jahr. Im Unternehmensmaßstab belaufen sich die Kosten auf über $10.000.
Speichersysteme in KI-Assistenten

Speichersysteme in KI-Assistenten

Arbeits-, Struktur- und Abrufgedächtnis für Assistenten.

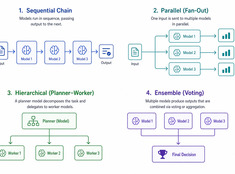
Speicher verwandelt Assistenten von reaktiv in persistent, ist aber auch der Ort, an dem viele Systeme stillschweigend veralten. Umfragen argumentieren, dass die Trennung zwischen kurzfristigem und langfristigem Speicher für moderne Agenten-Speicher nicht mehr ausreicht; OpenAI- und LangGraph-SDKs weisen auf einen einfacheren Stack hin – Arbeitsgedächtnis, dauerhafter Zustand und Abruf.

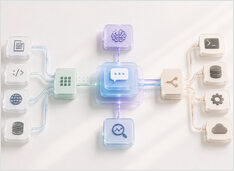
Architektur von KI-Assistenten: LLM, Speicher, Werkzeuge, Routing, Observability

Architektur von KI-Assistenten: LLM, Speicher, Werkzeuge, Routing, Observability

Wie seriöse Assistenten tatsächlich entwickelt werden.

Ein produktionsreifes KI-Assistentensystem ist nicht einfach „ein LLM mit einem Prompt“. Es handelt sich um ein System, das Absichten entgegennimmt, den Zustand verwaltet, entscheidet, wann Daten abgerufen oder Aktionen ausgeführt werden sollen, und genügend Laufzeitdetails bereitstellt, um Fehler zu debuggen.

Retrieval vs. Repräsentation in Wissenssystemen

Retrieval vs. Repräsentation in Wissenssystemen

Die Suche ist keine Wissensstruktur

Die meisten modernen Wissenssysteme optimieren die Abrufprozesse (Retrieval), und das ist verständlich. Die Suche ist sichtbar, leicht zu demonstrieren und wirkt fast magisch, wenn sie funktioniert. Frage eingeben, Antwort erhalten.

PKM vs. RAG vs. Wiki vs. Memory-Systeme klar erklärt

PKM vs. RAG vs. Wiki vs. Memory-Systeme klar erklärt

Eine Landkarte moderner Wissenssysteme

PKM, RAG, Wikis, KI-Speichersysteme und nun auch praktische, KI-gestützte Workflows werden oft so diskutiert, als lösten sie dasselbe Problem. Tun sie nicht. Sie alle befassen sich mit Wissen, arbeiten aber auf unterschiedlichen Ebenen:

Second Brain erklärt – für Ingenieure und Wissensarbeiter

Second Brain erklärt – für Ingenieure und Wissensarbeiter

Notizen sind Speicher. Ein zweites Gehirn ist Berechnung.

Informationsüberflutung hat weniger mit der schieren Menge zu tun als vielmehr mit ungelösten Eingaben. Moderne Wissensarbeit hinterlässt eine Spur aus Tabs, Chat-Verläufen, Dokumenten, Hervorhebungen, Code-Fragmenten, Transkripten, Screenshots und halbfertigen Notizen.

Strukturierte Ausgabevalidierung von LLMs in Python, die standhält

Strukturierte Ausgabevalidierung von LLMs in Python, die standhält

Hören Sie auf, auf Vibes zu vertrauen. Validieren Sie Verträge.

Die meisten Tutorials zu „strukturierten Ausgaben“ von LLMs sind wenig ernst gemeint. Sie lehren Sie, höflich um JSON zu bitten und darauf zu hoffen, dass das Modell sich entsprechend verhält. Das ist keine Validierung. Das ist Optimismus mit geschweiften Klammern.

Idempotenz in verteilten Systemen, die tatsächlich funktioniert

Idempotenz in verteilten Systemen, die tatsächlich funktioniert

Duplizierte Seiteneffekte vermeiden

Idempotenz in verteilten Systemen ist die Eigenschaft, die Sie rettet, wenn das Netzwerk lügt, die Warteschlange Wiederholungen versucht, der Client in Panik verfällt und der Operator den Replay-Button betätigt. In Produktionssystemen sind doppelte Zustellungen normal. Doppelte Nebeneffekte sind der Fehler.

Abonnieren

Neue Beiträge zu Systemen, Infrastruktur und KI-Engineering.