
OpenClaw-Produktionskonfigurationen mit Plugins und Skills
Wie reale OpenClaw-Systeme tatsächlich strukturiert sind
OpenClaw wirkt in Demos einfach. In der Produktion wird es zu einem System.
Wie reale OpenClaw-Systeme tatsächlich strukturiert sind
OpenClaw wirkt in Demos einfach. In der Produktion wird es zu einem System.
Claude-Abos versorgen Agenten nicht länger
Die ruhige Lücke, die eine Welle an Experimenten mit Agenten antrieb, ist nun geschlossen.
Selbst gehostete KI-Suche mit lokalen LLMs
Vane ist einer der pragmatischeren Einträge im Bereich „KI-Suche mit Quellenangaben": eine selbst gehostete Antwortmaschine, die live abrufbare Websuche mit lokalen oder Cloud-LLMs kombiniert, während der gesamte Stack unter Ihrer Kontrolle bleibt.
Agentic Coding, jetzt mit lokalen Modell-Backends.
Claude Code ist nicht einfach nur Autovervollständigung mit besserem Marketing. Es ist ein agentenbasiertes Coding-Tool: Es liest Ihre Codebasis, editiert Dateien, führt Befehle aus und integriert sich in Ihre Entwicklungstools.
Hermes Agent: Installation und Quickstart für Entwickler
Hermes Agent ist ein selbst gehosteter, modellunabhängiger KI-Assistent, der auf einem lokalen Rechner oder einem kostengünstigen VPS läuft, über Terminal- und Messaging-Schnittstellen arbeitet und sich im Laufe der Zeit verbessert, indem er wiederkehrende Aufgaben in wiederverwendbare Fähigkeiten umwandelt.
Installiere TGI, schieß schnell ab, debugge noch schneller.
Text Generation Inference (TGI) hat eine sehr spezifische Energie. Es ist nicht das neueste Kind auf der Inferenz-Straße, aber es ist dasjenige, das bereits gelernt hat, wie Produktion funktioniert –
Token-Geschwindigkeit von llama.cpp bei 16 GB VRAM (Tabellen).
Hier vergleiche ich die Geschwindigkeit verschiedener LLMs, die auf einer GPU mit 16 GB VRAM laufen, und wähle den besten für den Eigenbetrieb aus.
Compose-first Ollama-Server mit GPU und Persistenz.
Ollama funktioniert hervorragend auf Bare Metal. Es wird noch interessanter, wenn man es wie einen Service behandelt: ein stabiler Endpunkt, fixierte Versionen, persistente Speicherung und eine GPU, die entweder verfügbar ist oder eben nicht.
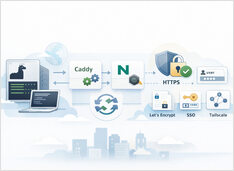
HTTPS mit Ollama, ohne die Streaming-Antworten zu beeinträchtigen.
Das Betreiben von Ollama hinter einem Reverse-Proxy ist der einfachste Weg, HTTPS, optionale Zugriffskontrolle und ein vorhersagbares Streaming-Verhalten zu erhalten.
Dienen Sie Open-Modelle schnell mit SGLang.
SGLang ist ein leistungsfähiges Bereitstellungsframework für große Sprachmodelle und multimodale Modelle, das entwickelt wurde, um Inferenz mit geringer Latenz und hohem Durchsatz von einzelnen GPUs bis hin zu verteilten Clustern zu ermöglichen.
Lokale LLMs ohne Änderung der Clients austauschen.
Bald jonglieren Sie mit vLLM, llama.cpp und mehr – jeder Stack auf einem eigenen Port. Alles nachgeschaltete System erwartet dennoch eine einzige /v1-Basis-URL; andernfalls sortieren Sie ständig Ports, Profile und Einmal-Skripte neu. llama-swap ist der /v1-Proxy vor diesen Stacks.
Die meisten lokalen KI-Setups beginnen mit einem Modell und einer Laufzeitumgebung.
Was genau passiert, wenn Sie Ultrawork ausführen?
Oh My Opencode verspricht ein „virtuelles KI-Entwicklerteam" — Sisyphus dirigiert Spezialisten, Aufgaben werden parallel ausgeführt und das magische Schlüsselwort ultrawork aktiviert alles.
Lernen Sie Sisyphus und sein Team spezialisierten Agenten kennen.
Der größte Sprung in den Fähigkeiten von OpenCode stammt von spezialisierten Agenten: einer bewussten Trennung von Orchestrierung, Planung, Ausführung und Recherche.
Installieren Sie Oh My Opencode und liefern Sie schneller aus.
Oh My Opencode verwandelt OpenCode in einen Multi-Agent-Coding-Rahmen: Ein Orchestrator delegiert Aufgaben an spezialisierte Agenten, die parallel arbeiten.
OpenCode LLM-Test — Statistiken zu Codierung und Genauigkeit
Ich habe getestet, wie sich OpenCode mit mehreren lokal auf Ollama und llama.cpp gehosteten LLMs verhält, und habe zum Vergleich einige kostenlose Modelle von OpenCode Zen hinzugefügt.