AI

Kostenoptimierung für LLM-Systeme: Wo das Geld tatsächlich hingeht

Kostenoptimierung für LLM-Systeme: Wo das Geld tatsächlich hingeht

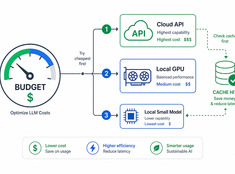
Setze Token gezielt dort ein, wo es wirklich zählt.

LLM-Kosten skalieren linear mit der Nutzung. Ein System, das 10.000 Anfragen pro Tag zu 0,01 USD pro Anfrage verarbeitet, kostet 100 USD täglich – 365 USD pro Jahr. Im Unternehmensumfeld belaufen sich diese Kosten auf über 10.000 USD.
LLM-Guardrails in der Praxis: Was wirklich funktioniert

LLM-Guardrails in der Praxis: Was wirklich funktioniert

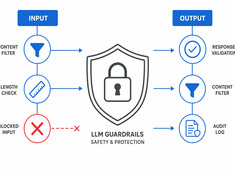
Kontrollieren Sie das Risiko, nicht nur das Modell.

LLMs sind unvorhersehbar. Sie halluzinieren, lecken Daten, generieren schädliche Inhalte oder lehnen legitime Anfragen ab. Guardrails (Schutzmechanismen) begrenzen das Modellverhalten, ohne die Fähigkeiten einzuschränken.

Modelle Routing: Hör auf, ein einzelnes Modell für alles zu verwenden

Modelle Routing: Hör auf, ein einzelnes Modell für alles zu verwenden

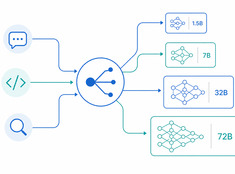
Das richtige Modell für die richtige Aufgabe.

Ein Modell mit 70 Milliarden Parametern für die Zusammenfassung einer 200-Wörter-E-Mail einzusetzen, ist verschwenderisch. Ein 3-Milliarden-Modell zur Überprüfung von Produktionscode einzusetzen, ist fahrlässig. Die meisten Systeme bewegen sich irgendwo dazwischen – und genau hier setzt Modell-Routing an.

Systemdesign mehrerer Modelle: Wenn ein Modell nicht ausreicht

Systemdesign mehrerer Modelle: Wenn ein Modell nicht ausreicht

Wählen Sie das einfachste Muster, das funktioniert.

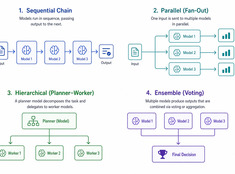
Einzelsystemen mit einem einzigen Modell sind einfach. Mehrfachmodell-Systeme sind leistungsstark. Die Herausforderung besteht nicht darin, Modelle auszuwählen, sondern darin, die Architektur zu gestalten, die sie orchestriert.

Speichersysteme in KI-Assistenten

Speichersysteme in KI-Assistenten

Arbeits-, strukturiertes und Abrufgedächtnis für Assistenten.

Speicher wandelt Assistenten von reaktiv in persistent um, aber genau dort verrotten auch viele Systeme still vor sich hin. Umfragen zeigen, dass die Trennung in Kurzzeit- und Langzeitgedächtnis für modernes Agenten-Gedächtnis nicht mehr ausreicht; OpenAI und LangGraph-SDKs deuten auf einen simpleren Stack hin — Arbeitsgedächtnis, dauerhafter Zustand und Abruf (Retrieval).

Architektur von KI-Assistenten: LLM, Memory, Tools, Routing, Observability

Architektur von KI-Assistenten: LLM, Memory, Tools, Routing, Observability

Wie ernsthafte Assistenten tatsächlich aufgebaut sind.

Ein produktionsreifes KI-Assistenzsystem ist nicht „ein LLM mit einem Prompt“. Es ist ein System, das Absicht akzeptiert, Zustand behält, entscheidet, wann es Informationen abrufen oder Aktionen ausführen soll, und genügend Laufzeitdetails offenlegt, um Fehlfunktionen zu debuggen.

PKM vs. RAG vs. Wiki vs. Memory-Systeme klar erklärt

PKM vs. RAG vs. Wiki vs. Memory-Systeme klar erklärt

Eine Landkarte moderner Wissenssysteme

PKM, RAG, Wikis, KI-Speichersysteme und nun auch praktische, KI-gestützte Workflows werden oft so diskutiert, als lösten sie dasselbe Problem. Tun sie nicht. Sie alle befassen sich mit Wissen, arbeiten aber auf unterschiedlichen Ebenen:

Strukturierte Ausgabevalidierung von LLMs in Python, die standhält

Strukturierte Ausgabevalidierung von LLMs in Python, die standhält

Hören Sie auf, auf Vibes zu vertrauen. Validieren Sie Verträge.

Die meisten Tutorials zu „strukturierten Ausgaben“ von LLMs sind wenig ernst gemeint. Sie lehren Sie, höflich um JSON zu bitten und darauf zu hoffen, dass das Modell sich entsprechend verhält. Das ist keine Validierung. Das ist Optimismus mit geschweiften Klammern.

Kanban in Hermes Agent für selbst gehostete LLM-Workflows

Kanban in Hermes Agent für selbst gehostete LLM-Workflows

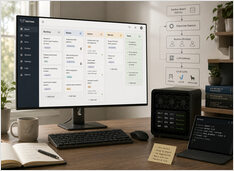
Steuerung der Hermes-Kanban-Last auf Ihrem selbst gehosteten LLM.

Hermes Agent wird mit einem Kanban-stilisierten Board und dem Hermes Gateway ausgeliefert, das Ihren selbst gehosteten LLM sättigen kann, wenn zu viele Aufgaben gleichzeitig zugewiesen werden.