
LLMシステムのコスト最適化: コストが実際にどこに使われているか
トークンを本当に重要な箇所に使いましょう。
LLMのコストは使用量に比例して線形に増加します。1日に10,000件のリクエストを処理し、1件あたり$0.01のシステムの場合、日次コストは$100、年間コストは$365になります。エンタープライズ規模になると、コストは$10,000を超えます。
コスト最適化とは、切り捨てたりケチったりすることではありません。重要となる部分にトークンを割り当てるということです。
無駄にする各トークンは、より良い回答に使用できたはずのトークンです。
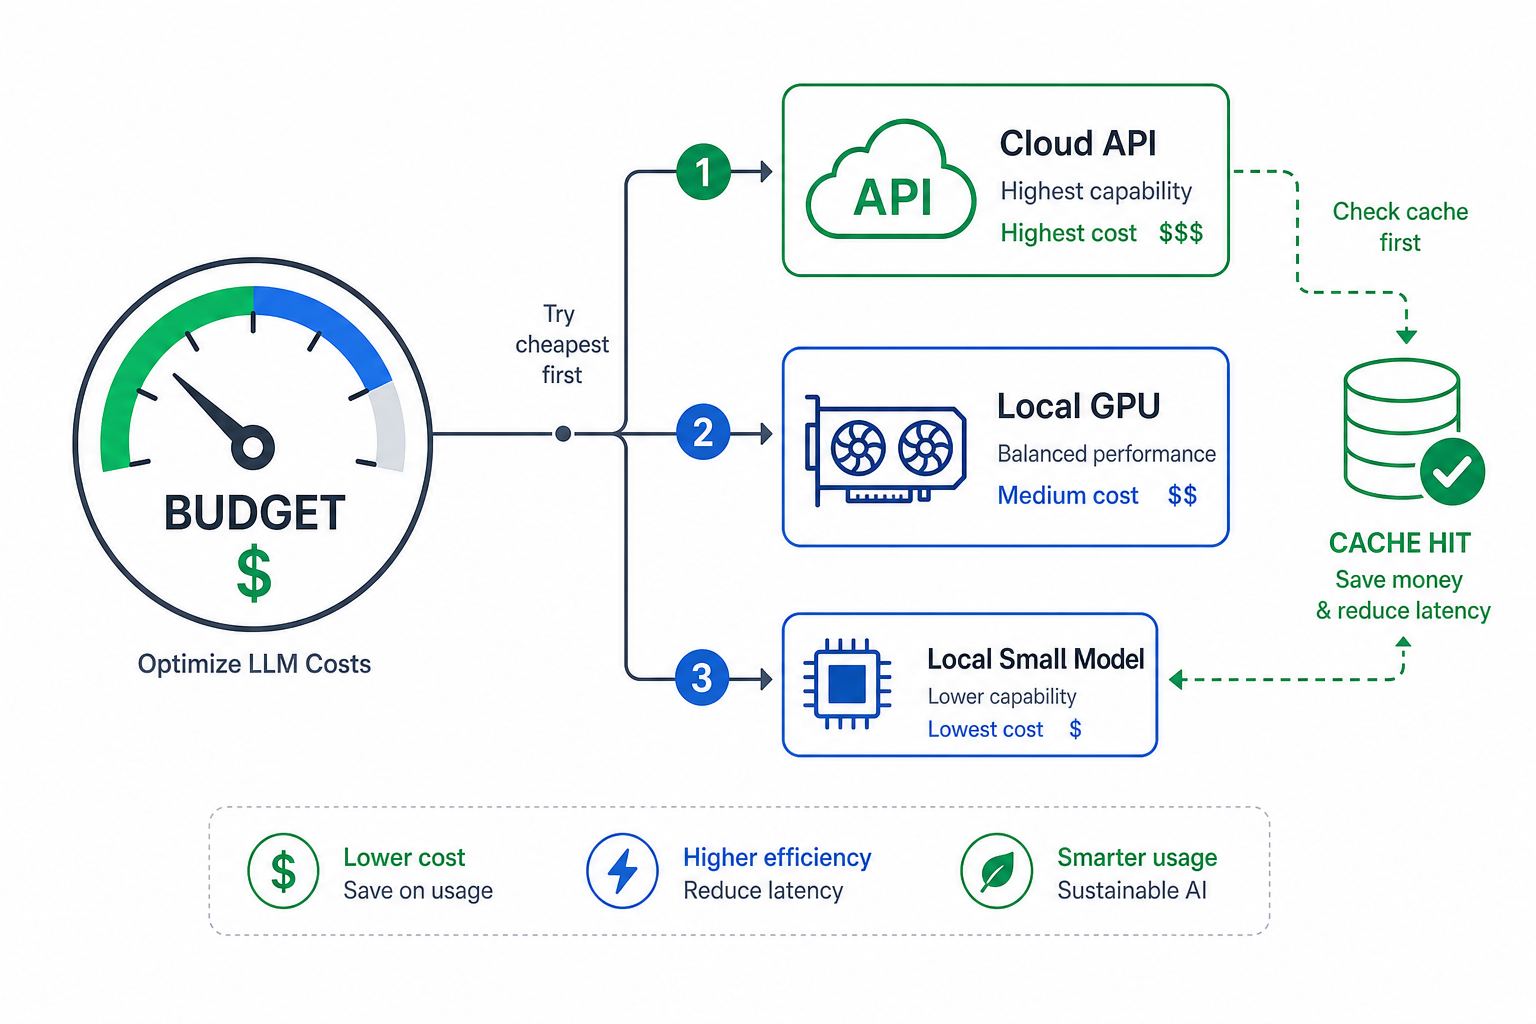
トークン予算管理
コストを制御する最もシンプルな方法は、制限を設定することです。セッションごと、タスクごと、あるいは日次で設定できます。
戦略1:セッションごとの予算
セッションごとの予算は straightforward(直截的)です:
class SessionBudget:
    def __init__(self, budget_tokens: int = 10000):
        self.budget = budget_tokens
        self.used = 0

    def allocate(self, tokens: int) -> bool:
        if self.used + tokens <= self.budget:
            self.used += tokens
            return True
        return False

    def remaining(self) -> int:
        return self.budget - self.used
戦略2:タスクごとの予算
タスクごとの予算の方がより実用的です。異なるタスクには異なる量のコンテキストが必要です:
task_budgets:
  classify:
    max_tokens: 100
    model: qwen3-1.7b
  summarize:
    max_tokens: 500
    model: qwen3-8b
  code_review:
    max_tokens: 2000
    model: qwen2.5-coder-7b
  reason:
    max_tokens: 4000
    model: qwen3-32b
戦略3:適応型予算
適応型予算は、実際に何が起きたかに基づいて調整します。分類タスクが常に80トークンを使用するなら、100を割り当てるのをやめましょう:
class AdaptiveBudget:
    def __init__(self):
        self.task_history = {}

    def allocate(self, task_type: str) -> int:
        if task_type in self.task_history:
            return int(self.task_history[task_type] * 1.5)
        return 1000

    def record(self, task_type: str, tokens_used: int):
        if task_type not in self.task_history:
            self.task_history[task_type] = tokens_used
        else:
            self.task_history[task_type] = (
                0.9 * self.task_history[task_type] + 0.1 * tokens_used
            )
指数移動平均(重み0.9)により、直近の使用量の方が履歴よりも重要視されます。ワークロードの変動性に基づいて重みを調整してください。
API推論とローカル推論
スケールにおいて、ローカル推論の方が安価です。損益分岐点は、あなたのハードウェアとAPI料金に依存します。
| モデル | API($ / 100万トークン) | ローカルコスト/時間 | 損益分岐点 |
|---|---|---|---|
| GPT-4o | $2.50 / $10.00 | — | N/A |
| Claude Sonnet 4 | $3.00 / $15.00 | — | N/A |
| Qwen2.5-72B | $0.50 / $2.00 | 約$0.50 | 約4時間/日 |
| qwen3-32b | $0.30 / $1.20 | 約$0.20 | 約2時間/日 |
| qwen3-8b | $0.10 / $0.40 | 約$0.05 | 約1時間/日 |
ハードウェアの計算:
| ハードウェア | 初期投資 | 月額電気代 | APIとの損益分岐点 |
|---|---|---|---|
| RTX 3090(中古) | $600 | $15 | 約4ヶ月 |
| RTX 4090 | $1,500 | $20 | 約6ヶ月 |
| RTX 5080 | $1,000 | $18 | 約5ヶ月 |
| DGX Spark | $2,000 | $30 | 約8ヶ月 |
中程度の使用量(1日1時間以上)の場合、ローカル推論で投資を回収できます。高使用量の場合、節約効果は劇的です。ただし、初期資本が障壁となります。RTX 5080は$1,000です。一時停止できるAPI請求書とは異なり、ハードウェアは一時停止できません。
この損益分岐点の計算は、自由に切り替えることが可能であると仮定しています。しかし、ハードウェアコストよりも大きな不確実性として、それが現実にはより大きな問題になることが多いです。ファインチューニングデータ、評価ハーネス、ツールスキーマが既に1つのプロバイダーのAPIを中心に構築されている場合、実際の移行コストはそれを解体するエンジニアリング時間であり、GPUの価格ではありません。データグラビティ:APIファーストAIの真のコスト は、このロックインの仕組みと、これらの数値を算出する前に、既にどの程度ロックインされているかを評価するチェックリストをカバーしています。
フォールバック戦略
優先モデルが高すぎたり遅すぎたりする場合、より安価な何かへのフォールバックを行います。重要なのは、品質が「十分良い」と判断する时机を知ることです。
戦略1:品質ベースのフォールバック
品質ベースのフォールバックは、出力が閾値を満たすまでモデルを試します:
class QualityFallback:
    def __init__(self, quality_threshold: float = 0.8):
        self.threshold = quality_threshold
        self.models = [
            {"model": "claude-sonnet-4", "cost": 0.015},
            {"model": "qwen2.5-72b", "cost": 0.002},
            {"model": "qwen3-32b", "cost": 0.001},
            {"model": "qwen3-8b", "cost": 0.0004},
        ]

    def route(self, prompt: str) -> str:
        for model_config in self.models:
            result = self.call_model(model_config["model"], prompt)
            if self.evaluate_quality(result) >= self.threshold:
                return result
        return self.call_model(self.models[0]["model"], prompt)
問題は評価自体です。もう一つのモデルを呼び出さずに品質をどのように測定しますか?一部のシステムは小さな分類器を使用します。その他には、長さ、構造、キーワードの存在などのヒューリスティックなチェックを使用します。これらはどれも完璧ではありません。
戦略2:レイテンシーベースのフォールバック
レイテンシーベースのフォールバックはよりシンプルです。時間予算を満たす最も速いモデルにルーティングします:
class LatencyFallback:
    def __init__(self, max_latency: float = 5.0):
        self.max_latency = max_latency
        self.models = [
            {"model": "qwen3-1.7b", "latency": 0.5},
            {"model": "qwen3-8b", "latency": 2.0},
            {"model": "qwen3-32b", "latency": 10.0},
            {"model": "claude-sonnet-4", "latency": 5.0},
        ]

    def route(self, prompt: str) -> str:
        for model_config in sorted(self.models, key=lambda x: x["latency"]):
            if model_config["latency"] <= self.max_latency:
                return self.call_model(model_config["model"], prompt)
        return self.call_model(self.models[0]["model"], prompt)
キャッシュ
キャッシュは最も過小評価されているコスト最適化です。同じプロンプトが思っているより頻繁に発生します——分類リクエスト、FAQ風のクエリ、繰り返されるツール呼び出しなどです。
戦略1:プロンプトキャッシュ
完全一致プロンプトキャッシュはシンプルです:
import hashlib

class PromptCache:
    def __init__(self, max_size: int = 1000):
        self.cache = {}
        self.max_size = max_size

    def get(self, prompt: str) -> str | None:
        key = hashlib.sha256(prompt.encode()).hexdigest()
        return self.cache.get(key)

    def set(self, prompt: str, response: str):
        key = hashlib.sha256(prompt.encode()).hexdigest()
        if len(self.cache) >= self.max_size:
            self.cache.pop(next(iter(self.cache)))
        self.cache[key] = response
戦略2:セマンティックキャッシュ
セマンティックキャッシュはより実用的です。異なるが同じ意味を持つプロンプトをキャッチします:
from sentence_transformers import SentenceTransformer

class SemanticCache:
    def __init__(self, similarity_threshold: float = 0.95):
        self.model = SentenceTransformer('all-MiniLM-L6-v2')
        self.cache = {}
        self.threshold = similarity_threshold

    def get(self, prompt: str) -> str | None:
        prompt_embedding = self.model.encode([prompt])[0]
        for cached_prompt, cached_response in self.cache.items():
            cached_embedding = self.model.encode([cached_prompt])[0]
            similarity = self.cosine_similarity(
                prompt_embedding, cached_embedding
            )
            if similarity >= self.threshold:
                return cached_response
        return None

    def set(self, prompt: str, response: str):
        self.cache[prompt] = response
閾値は重要です。0.95は積極的——非常に似たプロンプトのみが一致します。0.85はより寛容ですが、誤った回答を返すリスクがあります。ミス率を測定して調整してください。
一般的なクエリに対するレスポンスキャッシュも価値があります。ユーザーが「天気は?」「今何時?」などを繰り返す場合、正確なプロンプトだけでなくパターンをキャッシュしましょう:
class ResponseCache:
    def __init__(self):
        self.common_queries = {
            "what is the weather": "Check weather API",
            "what is the time": "Check system time",
            "who is the president": "Check current president",
        }

    def get(self, query: str) -> str | None:
        query_lower = query.lower()
        for common_query, response in self.common_queries.items():
            if common_query in query_lower:
                return response
        return None
洗練されたものではないですが、機能します。一般的なクエリが共通しているのには理由があります。
最適化が役立つ場面
高容量の処理、混合ワークロードの実行、または積み重なるAPIコストを支払っている場合、最適化は重要です。
プロトタイピング段階、単一モデルの使用、または低容量の処理の場合、重要ではありません。1日に100リクエストしかしないシステムにとって、予算管理、フォールバック、キャッシュの複雑さは費用に見合いません。
まず基本のフローを動作させましょう。請求書が届いたときに最適化を追加してください。
トレードオフ
| 戦略 | コスト | 品質 | 複雑さ |
|---|---|---|---|
| 最適化なし | 最高 | 一貫性あり | 最低 |
| トークン予算管理 | 中程度 | 変動あり | 中程度 |
| フォールバックモデル | 低〜中程度 | 変動あり | 中程度 |
| キャッシュ | 最低 | 高(キャッシュヒット時) | 中程度 |
| ハイブリッド | 最適化済み | 最適化済み | 最高 |
本番システムでは通常、ハイブリッドが実行されます。セッションごとに予算を設定し、品質またはレイテンシーに基づいてフォールバックし、キャッシュできるものはキャッシュします。複雑さは実在しますが、節約も実在します。
関連リンク
- データグラビティ:APIファーストAIの真のコスト — 上記の損益分岐点の計算がセルフホスティングの決断の一部に過ぎない理由
- 2026年のオープンモデルの効率的フロンティア — 損益分岐点の背後にあるモデルサイズの経済性:レンタル4090 1台上の27Bモデルと現在のSonnetトークン価格の比較
- モデルルーティング戦略 — 能力ベース、コスト認識型、レイテンシー認識型のルーティング
- 実践におけるLLMガードレール — 入力バリデーション、出力フィルタリング、安全性
- マルチモデルシステムデザイン — 複数モデルのためのアーキテクチャ
- LLMアーキテクチャ — システムデザインの柱:ルーティング、コスト、ガードレール、オーケストレーション
