
マルチモデルシステム設計:一つのモデルでは足りないとき
機能する最もシンプルなパターンを選択してください。
単一モデルのシステムはシンプルです。マルチモデルのシステムは強力です。課題はモデルの選択ではなく、それらをオーケストレートするアーキテクチャの設計にあります。
マルチモデルのシステムとは、より多くのモデルを持つのではなく、適切なタイミングで適切なタスクに対して適切なモデルを使うことです。
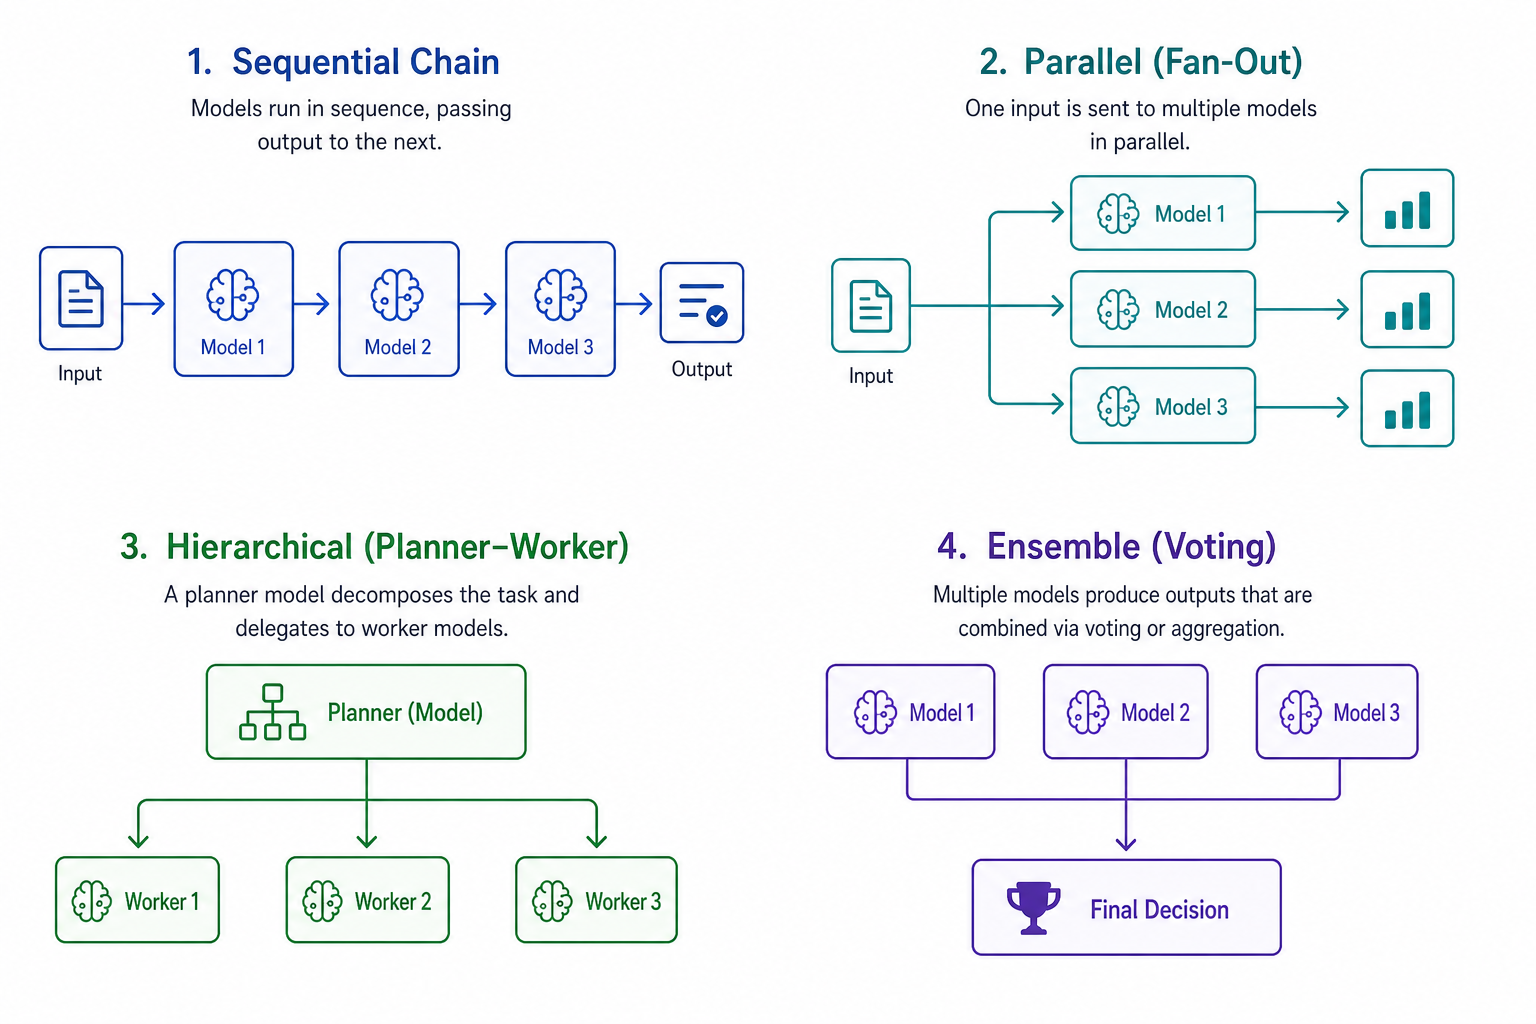
アーキテクチャパターン
5つのパターンがほとんどのユースケースをカバーします:
| パターン | 複雑度 | 使用場面 | トレードオフ |
|---|---|---|---|
| 単一モデル | 最小 | プロトタイピング、簡単なタスク | 能力に制限がある |
| 直列 | 低 | マルチステップのワークフロー | レイテンシが高くなる |
| 並列 | 中 | 独立したタスク | コストが高くなる |
| 階層型 | 高 | 複雑な推論 | オーケストレーションが複雑になる |
| アンサンブル | 最大 | 重要な判断 | コストが最大 |
機能する最もシンプルなものを検討してください。複雑さは実在し、複利のように増大します。
直列アーキテクチャ
タスクをモデルのチェーンを通して処理し、それぞれが特定のステップに特化します。
パターン 1: パイプライン
パイプラインパターン — 各モデルの出力が次のモデルの入力になります:
class ModelPipeline:
    def __init__(self):
        self.models = [
            {"model": "qwen3-1.7b", "task": "classify"},
            {"model": "qwen3-8b", "task": "extract"},
            {"model": "qwen3-32b", "task": "reason"},
        ]

    def process(self, input: str) -> str:
        current = input
        for model_config in self.models:
            current = self.call_model(
                model_config["model"],
                self.create_prompt(model_config["task"], current)
            )
        return current
レイテンシは累積します。3つのモデルを直列に接続するということは、レイテンシが3倍になることを意味します。各ステップが実際に異なるモデルを必要とする場合のみ、このパターンを使用してください。
パターン 2: ルーター
ルーターパターン — タスクを分類し、専門家モデルにルーティングします:
class ModelRouter:
    def __init__(self):
        self.classifier = "qwen3-1.7b"
        self.specialists = {
            "code": "qwen2.5-coder-7b",
            "math": "qwen3-32b",
            "creative": "claude-sonnet-4",
            "general": "qwen3-8b",
        }

    def route(self, prompt: str) -> str:
        task_type = self.classify(prompt)
        model = self.specialists.get(task_type, self.specialists["general"])
        return self.call_model(model, prompt)
クラシックファイア(分類器)は弱点になり得ます。誤分類が行われると、誤ったモデルにルーティングされ、品質を失います。十分な性能を持つ分類器を使用してください — カテゴリが明確であれば、小さなモデルでも機能します。
並列アーキテクチャ
独立したタスクを同時に処理します。
パターン 1: ファンアウト
ファンアウト — 同一のプロンプトを複数のモデルに通します:
import asyncio

class ModelFanOut:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    async def process(self, prompt: str) -> list[str]:
        tasks = [self.call_model(model, prompt) for model in self.models]
        return await asyncio.gather(*tasks)
比較や A/B テスト、または最良の出力を選択したい場合に有用です。コストは高くなりますが、重要な判断では品質向上がコストに見合う価値があります。
パターン 2: ボーティング
ボーティング — コンセンサス(合意形成)によって出力を統合します:
class ModelVoting:
    def __init__(self):
        self.models = [
            "qwen3-8b",
            "qwen3-32b",
            "claude-sonnet-4",
        ]

    def vote(self, prompt: str) -> str:
        responses = [self.call_model(model, prompt) for model in self.models]
        from collections import Counter
        votes = Counter(responses)
        return votes.most_common(1)[0][0]
多数決は分類タスクには有効です。生成タスクでは難しいです — 完全一致ではなく、意味的類似性が必要です。
階層アーキテクチャ
異なる抽象レベルのモデルを使用します。
パターン 1: プランナー-エクゼキューター
プランナー-エクゼキューター — 強力なモデルが計画し、より小さなモデルが実行します:
class PlannerExecutor:
    def __init__(self):
        self.planner = "qwen3-32b"
        self.executors = {
            "code": "qwen2.5-coder-7b",
            "search": "qwen3-8b",
            "math": "qwen3-8b",
        }

    def process(self, task: str) -> str:
        plan = self.call_model(self.planner, f"Plan: {task}")
        results = []
        for step in self.parse_plan(plan):
            executor = self.executors.get(step["type"], "qwen3-8b")
            result = self.call_model(executor, step["prompt"])
            results.append(result)
        return self.call_model(self.planner, f"Synthesize: {results}")
プランナーが主要な作業を行います。エクゼキューターが特定のタスクを処理します。このパターンは、計画ステップが高コストだが実行ステップが低コストの場合によく機能します。
パターン 2: サパーバイザー-ワーカー
サパーバイザー-ワーカー — サパーバイザーがタスクを割り当て、レビューします:
class SupervisorWorker:
    def __init__(self):
        self.supervisor = "qwen3-32b"
        self.workers = ["qwen3-8b", "qwen2.5-coder-7b"]

    def process(self, task: str) -> str:
        assignments = self.call_model(self.supervisor, f"Assign: {task}")
        results = []
        for assignment in self.parse_assignments(assignments):
            result = self.call_model(
                assignment["worker"], assignment["task"]
            )
            results.append(result)
        return self.call_model(self.supervisor, f"Review: {results}")
サパーバイザーがボトルネックになります。計画、割り当て、レビューのすべてを行います。十分に高速であることを確認してください。さもなければ、システム全体が低速になります。
アンサンブルアーキテクチャ
重要な判断のために複数のモデルを組み合わせます。
パターン 1: 重み付きアンサンブル
重み付きアンサンブル — 各モデルの出力にスコアを付け、最上位を選択します:
class WeightedEnsemble:
    def __init__(self):
        self.models = {
            "qwen3-32b": 0.5,
            "claude-sonnet-4": 0.3,
            "qwen3-8b": 0.2,
        }

    def decide(self, prompt: str) -> str:
        responses = {
            model: self.call_model(model, prompt)
            for model in self.models
        }
        scores = {}
        for model, response in responses.items():
            score = self.evaluate(response) * self.models[model]
            scores[response] = scores.get(response, 0) + score
        return max(scores, key=scores.get)
重みは各モデルへの信頼度を示します。ベンチマークではなく、実際の性能に基づいて調整してください。
パターン 2: コンセンサスアンサンブル
コンセンサスアンサンブル — 一致を必要とし、一致しない場合はエスカレーションします:
class ConsensusEnsemble:
    def __init__(self, threshold: float = 0.7):
        self.threshold = threshold
        self.models = [
            "qwen3-32b",
            "claude-sonnet-4",
            "qwen3-8b",
        ]

    def decide(self, prompt: str) -> str:
        responses = [
            self.call_model(model, prompt)
            for model in self.models
        ]
        from collections import Counter
        votes = Counter(responses)
        max_votes = max(votes.values())

        if max_votes / len(self.models) >= self.threshold:
            return votes.most_common(1)[0][0]

        return self.call_model("qwen3-32b", prompt)
しきい値はコンセンサスの厳しさを制御します。0.7 は 2/3 の一致を意味します。より迅速な判断には下げて、より高い確信度は求めて上げることで調整してください。
マルチモデルシステムが意味を持つ場面
マルチモデルシステムは、混合したワークロードがある場合、重要な判断に高品質が必要の場合、またはコストやレイテンシを最適化したい場合に意味を持ちます。
すべてのタスクが類似した複雑度であり、プロトタイピング中である場合、または最適化よりもシンプルさが重要である場合は、意味を持ちません。
経験則としては:1つのモデルから始めてください。コスト、レイテンシ、または品質という実際の制約に直面したときに、より多くのモデルを追加してください。必要とされる前に複雑なアーキテクチャを設計しないでください。
トレードオフ
| パターン | コスト | レイテンシ | 品質 | 複雑度 |
|---|---|---|---|---|
| 単一モデル | 最小 | 最小 | 変動あり | 最小 |
| 直列 | 中 | 高 | 高 | 中 |
| 並列 | 高 | 低 | 高 | 中 |
| 階層型 | 高 | 高 | 最高 | 高 |
| アンサンブル | 最大 | 中 | 最高 | 最高 |
すべてのパターンは何かをトレードオフにしています。あなたの制約条件に合致するものを選択してください。
関連する記事
- モデルルーティング戦略 — 能力ベース、コスト認知、レイテンシ認知のルーティング
- LLM システムのコスト最適化 — トークン予算管理、フォールバックモデル、キャッシュ
- 実践における LLM ガードレール — 入力検証、出力フィルタリング、安全性
- 意思決定 LLM:モデルが決定すべきとき — そしてすべきでないとき — オルケストレーション内でモデルが埋めることができる決定の種類、およびそれらを検証する方法
- LLM アーキテクチャ — システムデザインの柱:ルーティング、コスト、ガードレール、およびオーケストレーション
- マルチエージェントオーケストレーションパターン — マルチモデルルーティングとは異なります:これは複数の自律エージェントがどのように調整するか、タスクがモデル間でどのようにルーティングされるかではありません
