
モデルルーティング:すべてに1つのモデルを使うことをやめよう
「正しいタスクに、正しいモデルを。」
700億パラメータのモデルで200語のメール要約を行うのは無駄です。30億パラメータのモデルで本番コードのレビューを行うのは無謀です。大多数のシステムは、これら2つの極端の間に位置しています。まさにそこが、モデルルーティングの出番です。
タスクの複雑さに応じて、モデルの能力にマッチングさせます。トレードオフは確かに存在しますが、コスト削減の効果もまた現実的なものです。
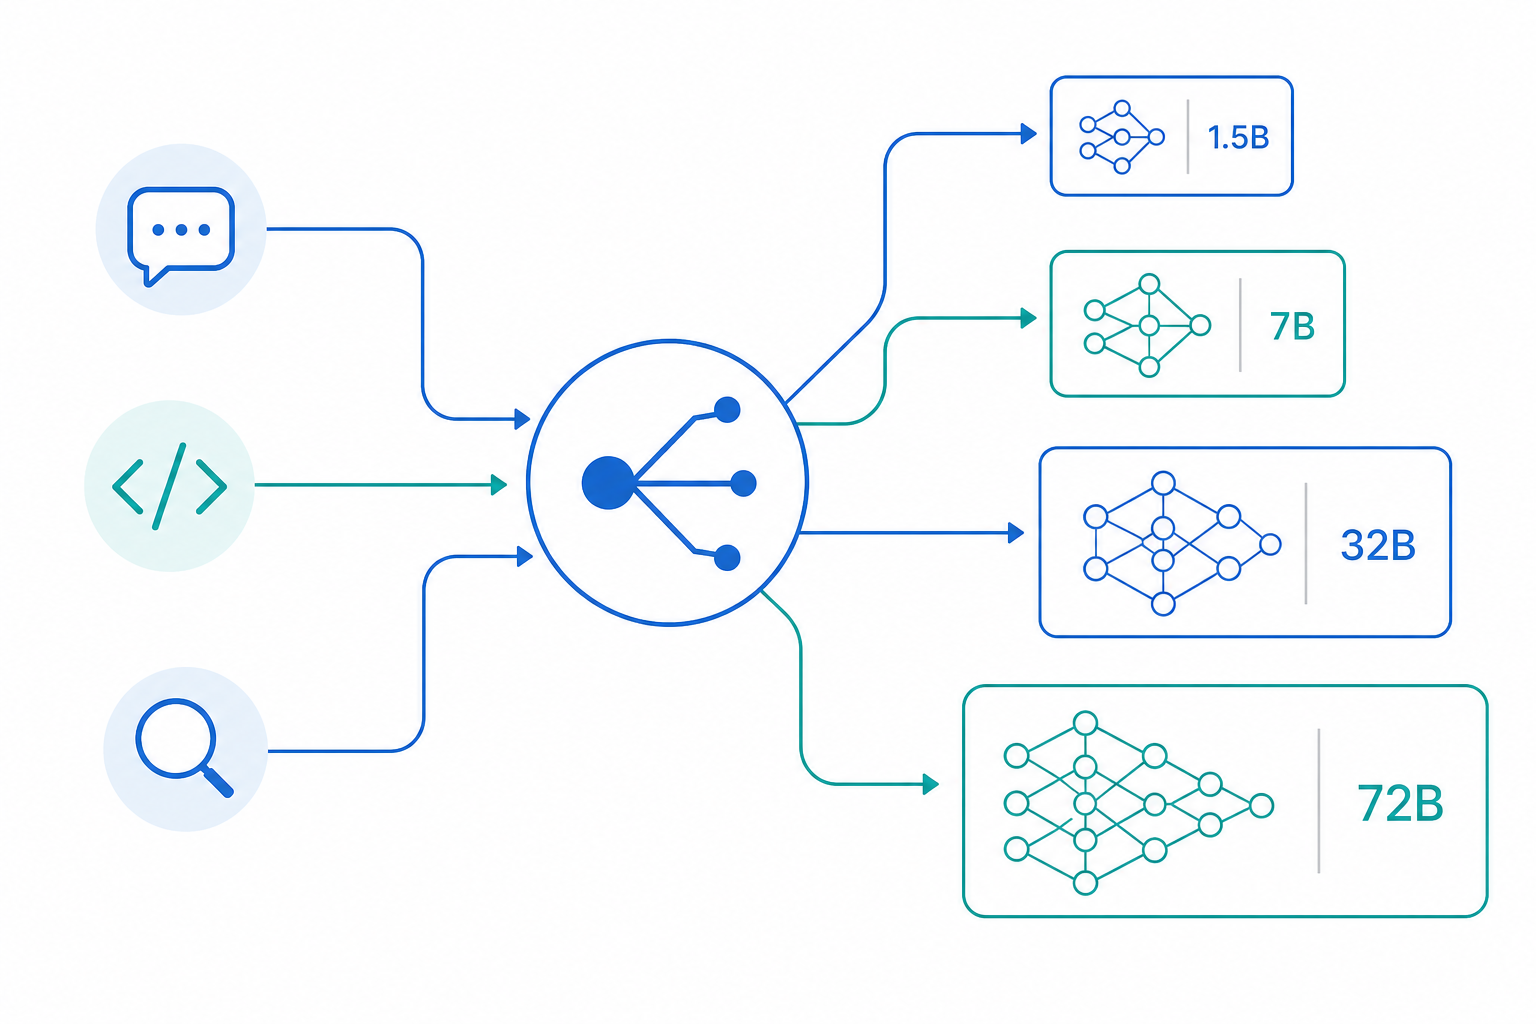
ルーティングの問題
多くの人は通常、1つのモデルを初期化してから使い続けます。それは、コストやレイテンシ、あるいはその両方に気づくまでの間は機能しています。代替案としては、どのリクエストをどのモデルが処理するかを決定する「ルーター」の構築です。
実務で機能する戦略は4つあります。
- 能力ベース — モデルが実行できるタスクに基づいてルーティングする
- コスト考慮型 — 許容できる支出額に基づいてルーティングする
- レイテンシ考慮型 — 必要な応答速度に基づいてルーティングする
- ハイブリッド — これらを組み合わせる
各戦略は異なる点を最適化します。どれか1つを選択することは、通常、「最も痛手となる点」に対する決断です。
能力ベースルーティング
最も単純なアプローチです。タスクを分類し、それに対応できるモデルに送ります。
| タスク | モデルサイズ | 例 |
|---|---|---|
| 分類、タグ付け | 1-3B | Qwen3-1.7B, Gemma-2-2B |
| 要約、抽出 | 3-7B | Qwen3-8B, Llama-3.1-8B |
| コード生成 | 7-14B | Qwen2.5-Coder-7B, DeepSeek-Coder-V2 |
| 複雑な推論 | 14-32B | Qwen3-32B, Llama-3.1-70B |
| クリエイティブライティング、分析 | 32B以上 | Qwen2.5-72B, Claude, GPT-4 |
タスクが大きなモデルを必要としない場合は、使わないでください。1.5Bモデルでも感情分析は十分に処理できます。しかし、一貫性のある論文を書くことはできません。
実装は直截了明です:
ROUTING_RULES = {
    "classify": {"model": "qwen3-1.7B", "max_tokens": 100},
    "summarize": {"model": "qwen3-8B", "max_tokens": 500},
    "code_review": {"model": "qwen2.5-coder-7b", "max_tokens": 2000},
    "reason": {"model": "qwen3-32b", "max_tokens": 4000},
    "creative": {"model": "claude-sonnet-4", "max_tokens": 8000},
}

def route_request(task_type: str) -> dict:
    return ROUTING_RULES.get(task_type, ROUTING_RULES["reason"])
注意点として、分類自体が問題になります。タスクタイプを誤って分類すると、誤ったモデルにルーティングされてしまいます。コードレビューを「要約」として分類し、品質が静かに低下しているシステムを見たことがあります。
コスト考慮型ルーティング
ローカル推論はここで力を発揮します。ハードウェアの償却が終われば、ローカルモデルは実質的に無料になります。適度なAPI使用量であれば、RTX 5080は約6ヶ月で元を取れます。
| モデル | 入力($/$M tokens) | 出力($/$M tokens) | ローカルコスト/時間 |
|---|---|---|---|
| GPT-4o | $2.50 | $10.00 | — |
| Claude Sonnet 4 | $3.00 | $15.00 | — |
| Qwen2.5-72B (API) | $0.50 | $2.00 | — |
| Qwen3-32B (ローカル) | $0.00 | $0.00 | ~$0.10 |
| Qwen3-8B (ローカル) | $0.00 | $0.00 | ~$0.05 |
1セッションで数千件のリクエストを処理する場合、$15/M tokensよりも、電気代がわずか$0.05である方が有利です。
予算ベースのルーティングは、支出に応じてフォールバックします:
class CostAwareRouter:
    def __init__(self, budget_per_session: float = 0.10):
        self.budget = budget_per_session
        self.spent = 0.0
        self.models = {
            "cheap": {"model": "qwen3-8B", "cost": 0.0},
            "medium": {"model": "qwen3-32b", "cost": 0.0},
            "expensive": {"model": "claude-sonnet-4", "cost": 0.000015},
        }

    def route(self, task: str) -> str:
        ratio = self.spent / self.budget
        if ratio < 0.5:
            return self.models["expensive"]["model"]
        elif ratio < 0.8:
            return self.models["medium"]["model"]
        return self.models["cheap"]["model"]
フォールバックするにつれて、品質は低下します。最初にClaudeを使用し、Qwen3-32B、さらにQwen3-8Bへと切り替わります。長時間のセッションの終わり頃には、出力は明らかに悪くなります。それが重要かどうかは、何を構築しているかによって異なります。
ルーチンなトラフィックをローカルモデルにルーティングし、APIはエッジケースのために確保するアプローチには、コスト以外の利点もあります。それは、すべてのファインチューニングや評価ハーネスが1つのプロバイダーのAPIの周りに形作られてしまうデータグラビティへの漂流を防ぐことです。
レイテンシ考慮型ルーティング
インタラクティブなツールは、最初のトークン生成が速い必要があります。バッチジョブは待っても構いません。モデルサイズの差は通常、5倍程度です。
| 使用場面 | 最初のトークン | 完了 | 最大モデルサイズ |
|---|---|---|---|
| リアルタイムチャット | < 200ms | < 2s | < 7B |
| インタラクティブツール | < 500ms | < 5s | < 14B |
| バッチ処理 | < 1s | < 30s | 任意 |
| 研究/分析 | < 2s | < 60s | 任意 |
ユーザーにトークンをストリーミングする場合、ユーザーが感じるのは最初のトークンまでのレイテンシです。0.5秒かけて始まる32Bモデルよりも、瞬時に反応する1.5Bモデルの方が、ずっと軽快に感じます。
class LatencyAwareRouter:
    def __init__(self):
        self.model_latencies = {
            "qwen3-1.7b": {"first_token": 0.05, "complete": 0.5},
            "qwen3-8B": {"first_token": 0.15, "complete": 2.0},
            "qwen3-32b": {"first_token": 0.5, "complete": 10.0},
            "claude-sonnet-4": {"first_token": 0.3, "complete": 5.0},
        }

    def route(self, target_latency: float) -> str:
        for model, latencies in sorted(
            self.model_latencies.items(),
            key=lambda x: x[1]["complete"]
        ):
            if latencies["complete"] <= target_latency:
                return model
        return "qwen3-1.7b"
レイテンシの数値は概算です。ハードウェア、量子化、バッチサイズに依存します。ご自身のセットアップで計測してください。
フォールバック戦略
モデルは失敗します。APIはレート制限を掛けます。タイムアウトが発生します。機能するパターンは、最良のものから最も信頼できるものへ順に並べられたフォールバックチェーンです:
class FallbackRouter:
    def __init__(self):
        self.fallback_chain = [
            {"model": "claude-sonnet-4", "timeout": 30},
            {"model": "qwen2.5-72b", "timeout": 60},
            {"model": "qwen3-32b", "timeout": 120},
            {"model": "qwen3-8b", "timeout": 300},
        ]

    def route_with_fallback(self, prompt: str) -> str:
        for config in self.fallback_chain:
            try:
                return self.call_model(
                    config["model"], prompt,
                    timeout=config["timeout"]
                )
            except (TimeoutError, APIError) as e:
                log.warning(f"Model {config['model']} failed: {e}")
                continue
        raise RuntimeError("All fallback models failed")
チェーンの最後のモデルはローカルにするべきです。遅くなりますが、ネットワークの問題やAPIキーの問題による失敗はしません。
ルーティングが有効な場合
ルーティングは、ワークロードが混合している場合に意味があります。同じシステム内で分類、要約、推論を行っている場合、ルーターはコストとレイテンシを節約します。
実行するすべてのタスクが同じ複雑度であれば、ルーティングは意味がありません。そのタスクに秀でたモデルをそのまま使えばよいだけです。ルーターは、必要のない複雑さを追加してしまいます。
初期のプロトタイピングも、ルーティングをスキップする理由になります。まず1つのモデルでタスクが動作することを確認し、コストやレイテンシが実際に問題になった時点でルーティングを追加してください。
トレードオフ
すべてのルーティング戦略は、何かを最適化すると同時に、別の何かを犠牲にしています。
- 単一モデル — 最もシンプル、最もコスト高、品質が一定
- 能力ベース — コスト効率が良い、タスクあたりの品質が高い、複雑さはやや高い
- コスト考慮型 — 最も安価、品質が変動、複雑さはやや高い
- レイテンシ考慮型 — 最も高速、品質を犠牲にする可能性あり、複雑さはやや高い
- ハイブリッド — すべてが最善だが、実装が最も複雑
本番システムは通常、ハイブリッドに収束します。能力ベースのルーティングから始め、請求書が来た際にコスト考慮型を追加し、ユーザーが速度に不満を述べた際にレイテンシ考慮型を追加します。
関連記事
- LLMシステムのコスト最適化 — トークン予算管理、キャッシュ、フォールバックモデル
- 実践におけるLLMガードレール — 入力検証、出力フィルタリング、安全性
- マルチモデルシステム設計 — 複数モデルのアーキテクチャ
- デシジョンLLM: モデルが判断すべき時と、すべきでない時 — 階層選択の背後にある判断役割の分類学、信頼度ベースのエスカレーションを含む
- LLMアーキテクチャ — システム設計の柱: ルーティング、コスト、ガードレール、およびオーケストレーション
