
llama.cppルータモデルをすべてアンロードする
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
セルフホスト型LLMのHermesカンバンの負荷を制御する。
Hermes Agentには、Kanbanスタイルのボードと、一度に多くのタスクがディスパッチされるとセルフホスト型LLMを飽和状態にしてしまう可能性のあるHermes Gatewayが同梱されています。
MinIO CEは2026年に事実上EOL(寿命終了)となります。
MinIO Community Edition は、新規の本番環境システムにとって安全なデフォルトではもはやありません。
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。
まずはプラグイン。スキルの名称を簡潔に。
この記事は、チャネル、モデルプロバイダー、ツール、音声、メモリ、メディア、Web 検索、その他ランタイムの表面機能などを追加するネイティブゲートウェイパッケージであるOpenClaw プラグインについて解説します。
Hermes Agentのインストールと開発者向けクイックスタート
Hermes Agentは、セルフホスティングでモデル非依存型のAIアシスタントであり、ローカルマシンや低コストのVPS上で動作します。ターミナルとメッセージングインターフェースを通じて利用可能で、反復されるタスクを再利用可能なスキルに変換することで、時間が経つにつれてパフォーマンスが向上します。
公開ポートを使用しないリモート Ollama アクセス
Ollama は、ローカルデーモンとして扱われるときに最も快適に動作します。CLI とアプリケーションがループバック HTTP API と通信し、残りのネットワークにはその存在が知られない状態です。
GPUと永続化対応のコンポーズファーストOllamaサーバー。
Ollama はベアメタル上で非常に良好に動作します。サービスとして扱うようになると、さらに興味深いものになります。安定したエンドポイント、ピン留めされたバージョン、永続化ストレージ、そして利用可能かどうかの明確な GPU。
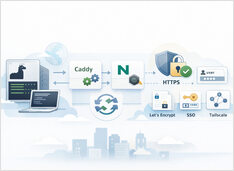
ストリーミング応答を破綻させずに HTTPS で Ollama を利用する。
リバースプロキシの背後で Ollama を実行することは、HTTPS、オプションのアクセス制御、予測可能なストリーミング動作を実現する最も簡単な方法です。
ステートフルストリーミング、チェックポイント、K8s、PyFlink、Go。
Apache Flink は、有界および無界のデータストリームに対して状態付きの計算を行うためのフレームワークです。
グラフ、Cypher、ベクトル、およびオペレーションの強化。
Neo4j は、関係そのものがデータであるときに選択するソリューションです。ドメインが白板に描かれた円と矢印の図のように見える場合、それをテーブルに無理やり押し込むのは苦痛を伴います。
デプロイ後に検索エンジンに対して Push URL を更新します。
静的サイトやブログは、デプロイされるたびに内容が変化します。IndexNow をサポートする 検索エンジン なら、次の盲目的なクロール(blind crawl)を待たずに、その変更を即座に認識できます。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。
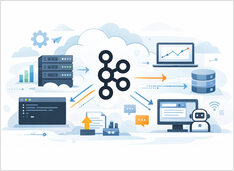
Kafka 4.2をインストールし、数分でストリーミングイベントを開始します。
Apache Kafka 4.2.0 が現在サポートされているリリースラインであり、Kafka 4.x は完全に ZooKeeper を不要とし、デフォルトで KRaft に構築されているため、モダンなクイックスタートには最適な基準となります。
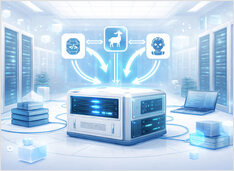
クライアントを変更せずにローカルLLMをホットスワップできます。
すぐにvLLM、llama.cpp、そしてその他の多数のスタックを回す必要が出てきます。それぞれのスタックは独自のポートを使います。しかし、下流のすべてのアプリケーションは、/v1 ベースの単一のURLを期待しています。そうでなければ、ポート、プロファイル、使い捨てのスクリプトの入れ替えを繰り返すことになります。llama-swap は、これらのスタックの前段にある /v1 プロキシです。
ソフトウェア開発では、バージョン管理にGit、コンテナ化にDocker、自動化にbash、データベースにPostgreSQL、エディタにVS Codeが不可欠です。生産性を左右する無数のツールが存在します。このページでは、開発スタック全体で効率的に作業するために必要な、不可欠なチートシート、ワークフロー、および比較情報をまとめています。