
決定LLM:モデルが判断すべきとき、すべきでないとき
モデルが提案し、システムが決定する。
エージェントのシステムで何が壊れるのかと実践者に聞けば、答えはほとんど時に能力ではありません。より静かな失敗です:モデルが判断し、誰も妥当なものと流暢なものの区別がつかない、ということです。
モデルが提案し、システムが決定する。
エージェントのシステムで何が壊れるのかと実践者に聞けば、答えはほとんど時に能力ではありません。より静かな失敗です:モデルが判断し、誰も妥当なものと流暢なものの区別がつかない、ということです。
ご自身のハードウェア上で永続的なHermesメモリを実現。
自己ホスティングされたAIエージェントには、単に長いコンテキストウィンドウがあるだけでは不十分です。有用な事実を保持し、以前の決定を参照し、プロジェクトが進化するにつれて自分の認識を更新するための手段が必要です。
検索を超えて調査を行うセルフホスト型エージェント
ディープリサーチ(Deep Research)は、もはや検索ボックスに向かせたモデルというわけではなく、独自のソフトウェアのカテゴリとして確立しつつあります。本記事では、12のセルフホスト型システムとその背後にあるリサーチアーキテクチャを比較します。
「記憶された結論が新たな証拠となる時。」
永続メモリにより、エージェントは毎回説明を繰り返す必要のあるツールから、コンテキストを引き継ぐものへと進化します。しかし、状態のないチャットでは回避される障害モードが新たに開かれます。解釈が記憶として保存され、事実として検索され、それ自身のより強固なバージョンを正当化し始めることがあるのです。
書き込みを制御されたローカル Hermes メモリ。
Mnemosyne は Hermes Agent 向けのローカルファーストなメモリプロバイダーであり、ワーキングメモリ、構造化された事実、時間的データ、エピソード記憶をローカルの SQLite に保存します。ホスティングサービスは不要で、ネットワーク呼び出しも必須ではなく、非常に細粒度な書き込み制御が特徴です。
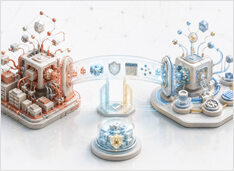
1行のインポートを超えた安全なカットオーバー
AIアシスタントの移行は、アプリケーション設定のコピーとは異なり、アイデンティティ、メモリ、ツール動作、スケジュールされたタスク、メッセージングへのアクセスを維持することが核心です。また、2つのゲートウェイが同じボットとして動作している状態を回避することも重要です。
スキル、MCPサーバー、それとも両方?
エージェントスキルとMCPサーバーは、AIエージェントを拡張する競合する2つの方法として提示されることがあります。この捉え方は誤りです:スキルはエージェントに作業方法を教え、MCPサーバーはライブ機能への管理されたアクセスを提供します。
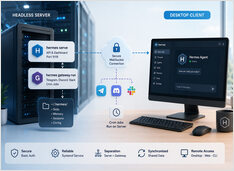
リモートデスクトップアクセスに対応したヘッドレスHermesサーバー
ヘッドレスサーバーで Hermes エージェントを実行し、別のマシンのデスクトップクライアントから接続するには、2つのサーバープロセスと1つのクライアント接続が必要です。
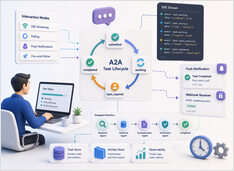
長期実行されるA2Aタスクは、チャットセッションの終了後も継続して実行されます。
ほとんどのAIエージェントのデモは、追加のステップを伴うチャット補完のように振る舞います。プロンプトを送信し、数秒待ってから、1つのレスポンスとして回答を受け取ります。
マルチエージェントパイロットの40%は失敗に終わります。適切なオーケストレーションパターンを選択し、破綻するパターンを回避する方法をご紹介します。
単一のAIエージェントによるシステムは2025年にピークを迎えました。1つのLLMにプロンプト、いくつかのツール、そして目標を与えれば、範囲が限定されたタスクにおいてそこそこ良好な結果を出せるようになり、これが現在の主流でした。
A2Aは死んでいません。単に普遍的ではないだけです。
GoogleのAgent2Agentプロトコル、一般的にA2Aと略されるこの規格は、最初の1年間で奇妙な展開をみせました。
AIエージェントのための信頼性の高いポーリングパターン
ポーリングエージェントは、AIアシスタントのアーキテクチャの中で最も華やかではない部分の一つですが、同時に最も有用な部分の一つでもあります。
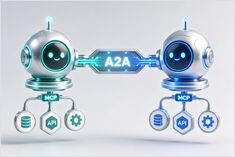
MCPはエージェントにツールを提供します。A2Aはエージェントに同僚を提供します。
AIエージェントのアーキテクチャは、2つのレイヤーに分裂し始めています。
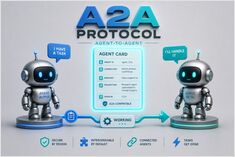
「A2Aはエージェントをネットワークピアに変換します。」
Agent2Agentプロトコルの略称であるA2Aプロトコルは、独立したAIエージェントシステム間の通信のためのオープン標準です。
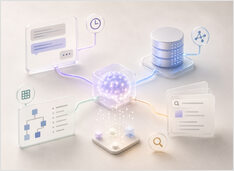
アシスタントのためのワーキングメモリ、構造化メモリ、検索メモリ
メモリはアシスタントを反応型のシステムから持続的なシステムへと変えますが、同時に多くのシステムが静かに腐敗していく場所でもあります。最近の調査では、現代的なエージェントのメモリに対して、短期記憶と長期記憶の二元論はもはや十分ではないと指摘されています。OpenAIやLangGraphのSDKは、よりシンプルなスタックを提唱しています。すなわち、ワーキングメモリ、永続状態、そして検索(リトリーバル)です。
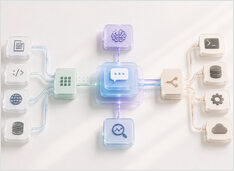
シリアスなアシスタントは実際にはどのように構築されているか。
本番環境で運用されるAIアシスタントは、「プロンプトを与えたLLM」ではありません。ユーザーの意図を受け取り、状態を保持し、検索やアクションを行うタイミングを判断し、障害のデバッグに必要なランタイムの詳細情報を公開するシステムです。