
2026年1月のGitHubで人気のあるGoプロジェクトトップ19
2026年1月の人気Goリポジトリ
Goエコシステムは、AIツール、セルフホストアプリケーション、開発者インフラにわたる革新的なプロジェクトとともに、ますます活気づいています。この概要では、今月のGitHub上位トレンドGoリポジトリについて分析します。
2026年1月の人気Goリポジトリ
Goエコシステムは、AIツール、セルフホストアプリケーション、開発者インフラにわたる革新的なプロジェクトとともに、ますます活気づいています。この概要では、今月のGitHub上位トレンドGoリポジトリについて分析します。
ローカルLLM用のセルフホスト型ChatGPT代替ソフトウェア
Open WebUI は、大規模言語モデルと対話するための強力で拡張性があり、機能豊富な自己ホスト型ウェブインターフェースです。
オーストラリアの小売業者から、リアルなオーストラリアドルでの価格を今すぐ。
NVIDIA DGX Spark (GB10 Grace Blackwell) は、主要な PC 小売店に国内在庫があり、オーストラリアで入手可能 となっています。 世界的な DGX Spark の価格と入手性 を追いかけていただいている方なら、オーストラリアでの価格帯はストレージ構成や小売店によって 6,249 オーストラリアドルから 7,999 オーストラリアドル であることが、ご関心をお持ちいただけるでしょう。
ローカルLLMを使用してCogneeをテストする - 実際の結果
CogneeはPythonフレームワークで、LLMを使用してドキュメントから知識グラフを構築します。 しかし、これはセルフホストされたモデルと互換性がありますか?
BAMLとInstructorによる型安全なLLM出力
プロダクション環境で大規模言語モデル(LLM)を扱う際、構造化され、型安全性のある出力を得ることが極めて重要です。 この問題の解決策として、2つの人気フレームワーク—BAMLとInstructor—がそれぞれ異なるアプローチを採用しています。
LLMを自社でホストするCogneeについての考察
Best LLM for Cognee を選ぶ際には、グラフ構築の質、幻覚率、ハードウェアの制約のバランスが求められます。
Cognee は、Ollama を介して 32B 以上の低幻覚モデルで優れた性能を発揮しますが、軽量な設定では中規模のオプションも使用可能です。
PythonとOllamaを使ってAI検索エージェントを構築する
OllamaのPythonライブラリは、今やOLlama web searchのネイティブな機能を含んでいます。わずか数行のコードで、ローカルのLLMをインターネット上のリアルタイム情報を補完し、幻覚を減らし、正確性を向上させることができます。
GoとOllamaを使ってAI検索エージェントを構築する
OllamaのWeb検索APIは、ローカルLLMにリアルタイムのウェブ情報を補完する機能を提供します。このガイドでは、GoでのWeb検索の実装について、単純なAPI呼び出しからフル機能の検索エージェントまでの実装方法を示します。
2026年の優れたローカルLLMホスティングツールを比較します。APIの成熟度、ハードウェアサポート、ツールコール機能、そして実用例です。
ローカルでLLM(大規模言語モデル)を動かすことは、現在、開発者、スタートアップ、さらにはエンタープライズのチームにとって現実的な選択肢となっています。 しかし、適切なツールの選択——Ollama、vLLM、LM Studio、LocalAI、あるいはそれ以外のツール——は、あなたの目標によって異なります。
オープンモデルを活用して、予算内のハードウェアでエンタープライズAIをデプロイする
AI の民主化はここにやってきました。 Llama、Mistral、Qwen などのオープンソース大規模言語モデル(LLM)が現在、プロプライエタリなモデルと競合するレベルに達しており、チームは 消費级ハードウェアを使用した AI インフラストラクチャ を構築することで、コストを削減しながらもデータプライバシーとデプロイの完全な制御を維持することが可能になりました。
GPT-OSS 120bの3つのAIプラットフォームにおけるベンチマーク
私は、Ollama上でGPT-OSS 120bのパフォーマンステストを3つの異なるプラットフォームで確認しました:NVIDIA DGX Spark, Mac Studio, and RTX 4080。OllamaライブラリのGPT-OSS 120bモデルは65GBあり、これはRTX 4080(または新しいRTX 5080の16GB VRAMには収まらないことを意味します。
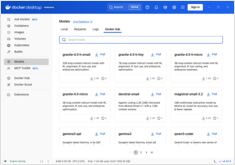
Docker Model RunnerとOllamaを比較してみる:ローカルLLM向け
ローカルで大規模言語モデル(LLM)を実行する は、プライバシー、コスト管理、オフライン機能のためにますます人気になってきています。 2025年4月にDockerが**Docker Model Runner (DMR)**を導入し、AIモデルの展開用の公式ソリューションとして登場したことで、状況は大きく変わりました。
OllamaをGoで統合する: SDKガイド、例、およびプロダクションでのベストプラクティス
このガイドでは、利用可能な Go SDK for Ollama の包括的な概要を提供し、それらの機能セットを比較します。
これらの2つのモデルの速度、パラメータ数、およびパフォーマンスを比較する
以下は、Qwen3:30b と GPT-OSS:20b の比較です。 指示の遵循度(Instruction Following)とパフォーマンスパラメータ、仕様、速度に焦点を当てています。
+ 思考型LLMを使用した具体的な例
この投稿では、PythonアプリケーションをOllamaに接続する2つの方法について紹介します。1つ目はHTTP REST APIを使用する方法、2つ目は公式のOllama Pythonライブラリを使用する方法です。
あまり良くない。
OllamaのGPT-OSSモデルは、LangChainやOpenAI SDK、vllmなどのフレームワークと使用する際に、構造化された出力を処理する際に繰り返し問題が発生しています。