
Vane(Perplexica 2.0)Ollama と llama.cpp を使用したクイックスタート
ローカル LLM を活用したセルフホスティング AI 検索
Vane は、「出典付き AI 検索」領域において、より実用的な選択肢の一つです。これは、リアルタイムのウェブ取得とローカルまたはクラウド上の LLM(大規模言語モデル)を組み合わせた、セルフホスティング可能な回答エンジンであり、スタック全体をユーザーの管理下に置くことができます。
ローカル LLM を活用したセルフホスティング AI 検索
Vane は、「出典付き AI 検索」領域において、より実用的な選択肢の一つです。これは、リアルタイムのウェブ取得とローカルまたはクラウド上の LLM(大規模言語モデル)を組み合わせた、セルフホスティング可能な回答エンジンであり、スタック全体をユーザーの管理下に置くことができます。
開発者向け Hermes Agent インストールとクイックスタート
Hermes Agentは、ローカルマシンや低コストのVPS上で動作し、ターミナルやメッセージングインターフェースを通じて機能し、反復されるタスクを再利用可能なスキルに変換することで継続的に改善される、セルフホスト型かつモデル非依存のAIアシスタントです。
TGI をインストールし、迅速にデプロイ、さらに高速にデバッグ。
Text Generation Inference (TGI) は、非常に特有の雰囲気を持っています。 推論の分野で最も新しい子供ではありませんが、すでに本番環境でのトラブルを学び、その教訓をデフォルト設定に焼き付けているのが TGI です。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。
クライアントを変更せずにホットスワップ可能なローカル LLM。
まもなく vLLM や llama.cpp など、それぞれのスタックが独自のポートで稼働している状態に陥ります。下流のシステムはすべて**/v1というベース URL を求めるため、ポート、プロファイル、ワンオフスクリプトを頻繁に変更することになります。llama-swapは、これらのスタックの前に配置される/v1**プロキシです。
ほとんどのローカルAI設定は、モデルとランタイムから始まります。
OpenCode のインストール、設定、および使用方法
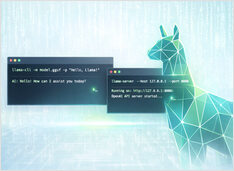
ローカル推論にllama.cppに何度も戻っています。Ollamaなどが抽象化している制御を直接手に入れられる上、動作も安定しています。GGUFモデルをllama-cliで対話的に実行したり、llama-serverでOpenAI互換のHTTP APIを公開したりするのが簡単です。
OpenClaw AI アシスタント ガイド
ほとんどのローカルAI環境の構築は、同じところから始まります。モデル、ランタイム、そしてチャットインターフェースです。

ヘッドレスCMSの比較 - 機能、パフォーマンスおよびユースケース
正しい ヘッドレス CMS の選択は、コンテンツ管理戦略を成功させるか、失敗させるかを左右します。 開発者がコンテンツ駆動型アプリケーションを構築する方法に影響を与える3つのオープンソースソリューションを比較してみましょう。
セルフホスト型のNextcloudクラウドストレージでデータを管理
Nextcloud は、オープンソースのセルフホスト型クラウドストレージおよびコラボレーションプラットフォームのリーダーであり、データを完全にあなた自身の管理下に置きます。
Cursor AI vs GitHub Copilot vs Cline AI vs…
ここでは、AI支援コーディングツールやAIコーディングアシスタントとその優れた点についていくつか紹介します。

よく使用するDockerコマンドのオプション
Dockerチートシート は、インストールからコンテナの実行、そしてクリーンアップまで、最も重要なコマンド と概念をカバーしています:

選択肢は多くないが、それでもなお....
LLMの実験を始めた当初は、それらのUIが活発な開発段階にありました。現在では、いくつかのUIが非常に良いものになっています。