
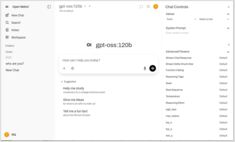
オープンウェブUI: 自己ホスト型LLMインターフェース
ローカルLLM用のセルフホスト型ChatGPT代替ソフトウェア
Open WebUI は、大規模言語モデルと対話するための強力で拡張性があり、機能豊富な自己ホスト型ウェブインターフェースです。
ローカルLLM用のセルフホスト型ChatGPT代替ソフトウェア
Open WebUI は、大規模言語モデルと対話するための強力で拡張性があり、機能豊富な自己ホスト型ウェブインターフェースです。
OpenAI APIによる高速LLM推論
vLLM は、UC Berkeley の Sky Computing Lab が開発した、大規模言語モデル(LLM)のための高スループットかつメモリ効率に優れた推論およびサービングエンジンです。
LLMを自社でホストするCogneeについての考察
Best LLM for Cognee を選ぶ際には、グラフ構築の質、幻覚率、ハードウェアの制約のバランスが求められます。
Cognee は、Ollama を介して 32B 以上の低幻覚モデルで優れた性能を発揮しますが、軽量な設定では中規模のオプションも使用可能です。
2026年の優れたローカルLLMホスティングツールを比較します。APIの成熟度、ハードウェアサポート、ツールコール機能、そして実用例です。
ローカルでLLM(大規模言語モデル)を動かすことは、現在、開発者、スタートアップ、さらにはエンタープライズのチームにとって現実的な選択肢となっています。 しかし、適切なツールの選択——Ollama、vLLM、LM Studio、LocalAI、あるいはそれ以外のツール——は、あなたの目標によって異なります。
Docker Model Runnerでコンテキストサイズを設定する際の回避策
Docker Model Runnerにおけるコンテキストサイズの設定は、本来よりも複雑です。
NVIDIA CUDAをサポートしたDocker Model RunnerでGPU加速を有効にする
Docker Model Runner は、Dockerが公式に提供するローカルでAIモデルを実行するためのツールですが、
Docker Model RunnerにおけるNVidia GPUの加速の有効化 には特定の設定が必要です。
Docker Model Runner コマンドのクイックリファレンス
Docker Model Runner (DMR) は、2025年4月に導入された Docker の公式ソリューションで、AIモデルをローカルで実行するためのものです。このチートシートでは、すべての必須コマンド、構成、およびベストプラクティスのクイックリファレンスを提供しています。
Docker Model RunnerとOllamaを比較してみる:ローカルLLM向け
ローカルで大規模言語モデル(LLM)を実行する は、プライバシー、コスト管理、オフライン機能のためにますます人気になってきています。 2025年4月にDockerが**Docker Model Runner (DMR)**を導入し、AIモデルの展開用の公式ソリューションとして登場したことで、状況は大きく変わりました。
OllamaをGoで統合する: SDKガイド、例、およびプロダクションでのベストプラクティス
このガイドでは、利用可能な Go SDK for Ollama の包括的な概要を提供し、それらの機能セットを比較します。
+ 思考型LLMを使用した具体的な例
この投稿では、PythonアプリケーションをOllamaに接続する2つの方法について紹介します。1つ目はHTTP REST APIを使用する方法、2つ目は公式のOllama Pythonライブラリを使用する方法です。
Ollama開発の現状についての私の見解
Ollamaは、LLM(大規模言語モデル)をローカルで実行するための最も人気のあるツールの一つに急速に成長しました。 そのシンプルなCLIと、洗練されたモデル管理は、クラウド外でAIモデルを扱いたい開発者にとって、定番の選択肢となっています。
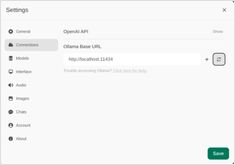
2025年のOllamaで最も注目されているUIの概要
ローカルにホストされた Ollama は、あなたのマシン上で大規模言語モデルを実行できるが、コマンドライン経由での使用はユーザーにとって使いにくい。
以下に、ローカルの Ollama に接続するための、いくつかのオープンソースプロジェクトが提供する ChatGPTスタイルのインターフェース がある。
Qwen3 8B、14Bおよび30B、Devstral 24B、Mistral Small 24B
このテストでは、Ollama上でホストされているさまざまなLLMがHugoページを英語からドイツ語に翻訳する方法を比較しています。英語からドイツ語への翻訳。
LLMプロバイダーの短いリスト
LLMを使用することは非常に高価ではありません。新しい高性能なGPUを購入する必要がないかもしれません。LLMプロバイダーの一覧は、クラウド上のLLMプロバイダー で確認できます。それぞれが提供しているLLMについても記載されています。
2つのdeepseek-r1モデルを2つのベースモデルと比較する
DeepSeekの 1世代目の推論モデルで、OpenAI-o1と同等の性能を備えています。 これは、LlamaおよびQwenに基づいてDeepSeek-R1から蒸留された6つの密結合モデルです。

Ollama コマンドリストの更新 - ls、ps、run、serve など
このOllama CLI チートシートでは、日常的に使用するコマンド(ollama ls、ollama serve、ollama run、ollama ps、モデル管理、一般的なワークフロー)に焦点を当てており、コピー&ペーストできる例を多数記載しています。