
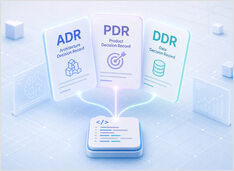
AI駆動型ソフトウェア開発のための意思決定記録
意図をコードに近づけよう。
意思決定記録は、AI支援ソフトウェア開発における欠けている記憶レイヤーです。何を構築したかだけでなく、なぜそうしたかを取締ります — この区別は、AIツールがコードを書いている場合に極めて重要になります。
意図をコードに近づけよう。
意思決定記録は、AI支援ソフトウェア開発における欠けている記憶レイヤーです。何を構築したかだけでなく、なぜそうしたかを取締ります — この区別は、AIツールがコードを書いている場合に極めて重要になります。
A2Aは死んでいません。単に普遍的ではないだけです。
GoogleのAgent2Agentプロトコル、一般的にA2Aと略されるこの規格は、最初の1年間で奇妙な展開をみせました。
AIエージェントのための信頼性の高いポーリングパターン
ポーリングエージェントは、AIアシスタントのアーキテクチャの中で最も華やかではない部分の一つですが、同時に最も有用な部分の一つでもあります。
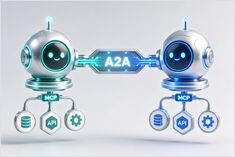
MCPはエージェントにツールを提供します。A2Aはエージェントに同僚を提供します。
AIエージェントのアーキテクチャは、2つのレイヤーに分裂し始めています。
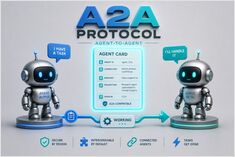
「A2Aはエージェントをネットワークピアに変換します。」
Agent2Agentプロトコルの略称であるA2Aプロトコルは、独立したAIエージェントシステム間の通信のためのオープン標準です。
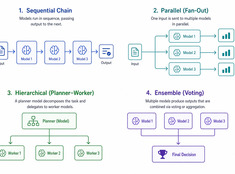
機能する最もシンプルなパターンを選択してください。
単一モデルのシステムはシンプルです。マルチモデルのシステムは強力です。課題はモデルの選択ではなく、それらをオーケストレートするアーキテクチャの設計にあります。
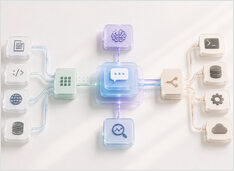
シリアスなアシスタントは実際にはどのように構築されているか。
本番環境で運用されるAIアシスタントは、「プロンプトを与えたLLM」ではありません。ユーザーの意図を受け取り、状態を保持し、検索やアクションを行うタイミングを判断し、障害のデバッグに必要なランタイムの詳細情報を公開するシステムです。
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
本番環境で耐えるClaude Skillsの構築
ほとんどのチームは、Claude Skillsの使い方を2つのいずれかの誤った方法で運用しています。SKILL.mdを単なるゴミ箱のように使っているか、巨大なプロンプトの切り貼りから抜け出せずにいるかのどちらかです。
ローカルモデルバックエンドに対応したエージェンティックコーディング
Claude Codeは、マーケティングが上手な自動補完ツールではありません。これはエージェント型コーディングツールです。コードベースを読み取り、ファイルを編集し、コマンドを実行し、開発ツールと統合します。
SGLang を使ってオープンモデルを高速に提供。
SGLang は、大規模言語モデルおよびマルチモーダルモデル向けの高パフォーマンスなサービングフレームワークであり、単一の GPU から分散クラスターに至るまで、低レイテンシかつ高スループットの推論を提供するために設計されています。
クライアントを変更せずにローカルLLMをホットスワップできます。
すぐにvLLM、llama.cpp、そしてその他の多数のスタックを回す必要が出てきます。それぞれのスタックは独自のポートを使います。しかし、下流のすべてのアプリケーションは、/v1 ベースの単一のURLを期待しています。そうでなければ、ポート、プロファイル、使い捨てのスクリプトの入れ替えを繰り返すことになります。llama-swap は、これらのスタックの前段にある /v1 プロキシです。
Ultrawork を実行した際に実際には何が起こるのでしょうか。
Oh My Opencode は「仮想 AI 開発チーム」を約束しています。Sisyphus が専門家を指揮し、タスクが並列で実行され、ultrawork という魔法のようなキーワードがそのすべてを活性化させます。
Oh My Opencode をインストールして、より高速にリリースしましょう。
Oh My Opencode は、OpenCode をマルチエージェントコーディングハネスへと変えます。オーケストレーターは、並行して実行される専門エージェントに作業を委任します。
OpenCode LLM テスト — コーディングおよび精度の統計
Ollama と llama.cpp でローカルホストされている複数の LLM と、比較のために追加した OpenCode Zen の無料モデルとの組み合わせで、OpenCode がどのように動作するかをテストしました。