
消費者向けハードウェア上の AI インフラ
オープンモデルを活用して、予算内のハードウェアでエンタープライズAIをデプロイする
AI の民主化はここにやってきました。 Llama、Mistral、Qwen などのオープンソース大規模言語モデル(LLM)が現在、プロプライエタリなモデルと競合するレベルに達しており、チームは 消費级ハードウェアを使用した AI インフラストラクチャ を構築することで、コストを削減しながらもデータプライバシーとデプロイの完全な制御を維持することが可能になりました。
オープンモデルを活用して、予算内のハードウェアでエンタープライズAIをデプロイする
AI の民主化はここにやってきました。 Llama、Mistral、Qwen などのオープンソース大規模言語モデル(LLM)が現在、プロプライエタリなモデルと競合するレベルに達しており、チームは 消費级ハードウェアを使用した AI インフラストラクチャ を構築することで、コストを削減しながらもデータプライバシーとデプロイの完全な制御を維持することが可能になりました。
LongRAG、Self-RAG、GraphRAG - 次世代の技術
検索拡張生成(RAG) は、単純なベクター類似度検索を大きく超えた進化を遂げています。 LongRAG、Self-RAG、GraphRAGは、これらの機能の最先端を代表しています。

GGUF量子化でFLUX.1-devを高速化
FLUX.1-dev は、驚くほど美しい画像を生成できる強力なテキストから画像生成モデルですが、24GB以上のメモリが必要なため、多くのシステムでは実行が難しいです。 GGUF量化されたFLUX.1-dev は、メモリ使用量を約50%削減しながらも、優れた画像品質を維持するという解決策を提供します。
Docker Model Runnerでコンテキストサイズを設定する際の回避策
Docker Model Runnerにおけるコンテキストサイズの設定は、本来よりも複雑です。

テキスト指示を使って画像を拡張するためのAIモデル
ブラックフォレスト・ラボズは、FLUX.1-Kontext-devという高度な画像から画像へのAIモデルをリリースしました。このモデルは、テキストの指示を使って既存の画像を補強します。
NVIDIA CUDAをサポートしたDocker Model RunnerでGPU加速を有効にする
Docker Model Runner は、Dockerが公式に提供するローカルでAIモデルを実行するためのツールですが、
Docker Model RunnerにおけるNVidia GPUの加速の有効化 には特定の設定が必要です。
インテリジェントなトークン最適化でLLMコストを80%削減
トークン最適化は、コスト効率の高いLLMアプリケーションと、予算を浪費するだけの実験を分ける重要なスキルです。

ご自身でホストするAIを活用したバックアップに使用される写真
Immich は、あなたの思い出を完全にコントロールできる、革新的なオープンソースでセルフホスト型の写真および動画管理ソリューションです。Google Photos と競合する機能を備えており、AI による顔認識、スマート検索、自動モバイルバックアップを含みながら、あなたのデータをプライバシーとセキュリティを保ったまま、あなたのサーバー上に保管します。
GPT-OSS 120bの3つのAIプラットフォームにおけるベンチマーク
私は、Ollama上でGPT-OSS 120bのパフォーマンステストを3つの異なるプラットフォームで確認しました:NVIDIA DGX Spark, Mac Studio, and RTX 4080。OllamaライブラリのGPT-OSS 120bモデルは65GBあり、これはRTX 4080(または新しいRTX 5080の16GB VRAMには収まらないことを意味します。
Pythonの例を使ってAIアシスタント用のMCPサーバーを構築する
モデルコンテキストプロトコル(MCP)は、AIアシスタントが外部データソースやツールとどのように相互作用するかを革命的に変えてきました。本ガイドでは、ウェブ検索およびスクレイピング機能に焦点を当てた例を用いて、MCPサーバーをPythonで構築する方法について説明します。
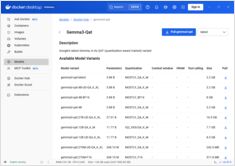
Docker Model Runner コマンドのクイックリファレンス
Docker Model Runner (DMR) は、2025年4月に導入された Docker の公式ソリューションで、AIモデルをローカルで実行するためのものです。このチートシートでは、すべての必須コマンド、構成、およびベストプラクティスのクイックリファレンスを提供しています。
Docker Model RunnerとOllamaを比較してみる:ローカルLLM向け
ローカルで大規模言語モデル(LLM)を実行する は、プライバシー、コスト管理、オフライン機能のためにますます人気になってきています。 2025年4月にDockerが**Docker Model Runner (DMR)**を導入し、AIモデルの展開用の公式ソリューションとして登場したことで、状況は大きく変わりました。
ASICおよびカスタムシリコンにより、LLM推論の速度と効率を追求する
6カ国の実売価格、供給状況、およびMac Studioとの比較
NVIDIA DGX Spark は実在しており、2025年10月15日に発売開始予定です。CUDA環境でのローカルLLM作業を必要とする開発者向けに、統合されたNVIDIA AIスタックを搭載しています。アメリカのMSRPは3,999ドルですが、英国/ドイツ/日本の小売価格はVAT(付加価値税)や流通経費により高くなります。豪ドル/韓ウォンでの公定価格はまだ広く公開されていません。
OllamaとGoの統合:SDKガイド、例、および本番環境でのベストプラクティス
このガイドでは、利用可能な Ollama 用の Go SDK の概要を網羅的に示し、その機能セットを比較します。
これらの2つのモデルの速度、パラメータ、性能を比較する
以下は、Qwen3:30b と GPT-OSS:20bの比較です。 指示への追従(Instruction Following)および性能パラメータ、仕様、速度に焦点を当てています。