
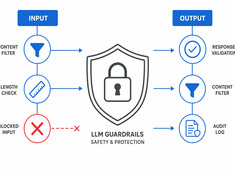
実践におけるLLMのガードレール:実際に有効な手法
管理すべきはモデルではなく、リスクです。
LLM(大規模言語モデル)は予測不可能です。幻覚(ハルシネーション)を起こし、データを漏洩させ、有害なコンテンツを生成したり、正当なリクエストを拒否したりします。ガードレール(防護策)は、機能を損なわずにモデルの動作を制限します。
管理すべきはモデルではなく、リスクです。
LLM(大規模言語モデル)は予測不可能です。幻覚(ハルシネーション)を起こし、データを漏洩させ、有害なコンテンツを生成したり、正当なリクエストを拒否したりします。ガードレール(防護策)は、機能を損なわずにモデルの動作を制限します。
アシスタントのためのワーキングメモリ、構造化メモリ、検索メモリ
メモリはアシスタントを反応型のシステムから持続的なシステムへと変えますが、同時に多くのシステムが静かに腐敗していく場所でもあります。最近の調査では、現代的なエージェントのメモリに対して、短期記憶と長期記憶の二元論はもはや十分ではないと指摘されています。OpenAIやLangGraphのSDKは、よりシンプルなスタックを提唱しています。すなわち、ワーキングメモリ、永続状態、そして検索(リトリーバル)です。
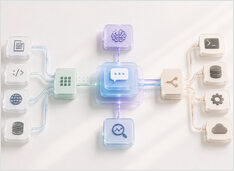
シリアスなアシスタントは実際にはどのように構築されているか。
本番環境で運用されるAIアシスタントは、「プロンプトを与えたLLM」ではありません。ユーザーの意図を受け取り、状態を保持し、検索やアクションを行うタイミングを判断し、障害のデバッグに必要なランタイムの詳細情報を公開するシステムです。
検索は知識構造ではない
最新の知識システムのほとんどは検索(Retrieval)を最適化しています。それは理解できることです。検索は目に見えやすく、デモンストレーションも容易で、機能すると魔法のように感じられます。質問を入力すれば、答えが返ってきます。
AIシステム向けの構造化された知識
前提はシンプルです。コンパイルされた知識は、取得された断片的な情報よりも再利用性が高いというものです。 RAG(検索強化生成)は、LLM(大規模言語モデル)に外部知識へのアクセスをどのように与えるかという直接的な問いに対するデフォルトの答えとなりました。
現代の知識システムの地図
PKM、RAG、ウィキ、AIメモリシステム、そして今実用化が進むAI支援ワークフローは、しばしば同じ問題を解決するかのように論じられます。 しかし、実際にはそうではありません。 これらはすべて知識を扱いますが、動作するレイヤーは異なります。
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
キャプチャポリシーの重要性は、リコールと同等までに高まっている。
2026年9月更新: MnemosyneとMemoriを追加し、HonchoとHindsightの設定を拡張しました。また、元のインフラストラクチャ表に加えてキャプチャポリシー比較表を追加しました。
タブを閉じるとすべての記憶を失う現代のAIアシスタントに対し、コンテキストウィンドウを超えて永続化する何かが必要になります。エージェントメモリプロバイダーとは、セッション間で事実や要約を保持するサービスやライブラリであり、フレームワークをスリムに保ちつつメモリをスケーリングするために、多くの場合プラグインとして組み込まれます。
本ガイドでは、Hermes Agentの外部メモリプラグインとして提供されるメモリバックエンド(Honcho、OpenViking、Mem0、Hindsight、Holographic、RetainDB、ByteRover、Supermemory、Mnemosyne、Memori)を比較し、それらがより広い**AIシステムのスタックにどのように組み込まれるかを説明します。同じベンダーは、コミュニティまたは公式統合を通じて、OpenClawや他のエージェントツールにも登場します。AIシステム メモリハブ**には、この記事に加えCogneeや関連するガイドがリストされています。
Hermesに固有のバウンデッドコアメモリ(MEMORY.mdとUSER.md)、フリーズ動作、トリガーについては、**Hermes Agent メモリシステム**を参照してください。HermesのネイティブメモリプロバイダーがOpenClawに対する採用優位性の拡大(GitHubスター数、OpenRouterトークンランキング、エコシステム規模の比較など)にどのように貢献しているかという背景については、OpenClaw vs Hermes Agent: Stars, Downloads & Usage 2026を参照してください。
メモリこそが、ツールとパートナーとの違いを創り出す。
AI エージェントとのチャットを開始し、プロジェクトの概要を説明し、好みを共有し、いくつかの作業を行い、タブを閉じる。その翌週にもう一度戻ってくると、まるで見知らぬ人と話しているかのようですね。すべてのコンテキストが失われ、すべての好みは忘れられ、プロジェクトはゼロから再説明しなければなりません。
実際のOpenClawシステムはどのように構成されているのか
OpenClawのデモではシンプルに見えます。 しかし、本番環境では、それは一つのシステムへと変貌します。
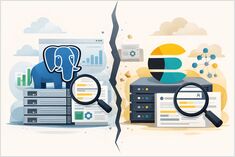
1 つのデータベースか、本物の検索スタックか
本当の議論の焦点は、PostgreSQL がテキスト検索できるかどうか、あるいは Elasticsearch がドキュメントを保存できるかどうかではありません。両者とも可能です。興味深いのは、検索の複雑性がどこに存在すべきかという点です。
アラート通知はノイズを流すための仕組みではなく、対応のためのシステムである
アラートは、監視機能として語られることが多すぎます。 その枠組みは便利ですが、真の問題を隠してしまいます。
Slack はワークフロー UI およびアラート配信レイヤーです。
Slack の統合は、1 つの HTTP コールでメッセージを送信できるため、欺瞞的に簡単に見えるかもしれません。 しかし、Slack を対話的で信頼性の高いものにする必要が出てきた時が、本物の面白い部分です。
Discord を安全でインタラクティブなアラートバスに変えましょう。
Discord をシステムとして扱う場合、イベントを公開する場所、人間が意思決定を行い、自動化がワークフローを継続させる場として扱うことで、本格的な統合の土台となります。
システム制御プレーンとしてのチャットプラットフォーム
チャットプラットフォームは、単なるメッセージングツールを超えて大きく進化しました。 現代のシステムでは、これらは自動化プロセスと人間の意思決定の間をつなぐインターフェースとして機能しています。
統合、コード構造、データアクセスのパターン。
多くのアプリケーションアーキテクチャに関する助言は、適用するには抽象的すぎたり、スケーリングするには狭すぎたりします。 ここでは、統合、コード構造、データアクセスにおける本番システムのための実用的なトレードオフについて説明します。