
16 GB GPU上のKVキャッシュ:長文脈を実際に収容する
16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
16GBでは128Kコンテキストが死ににくい理由
モデルが128Kのコンテキストウィンドウを宣伝していても、16 GBのGPUでは40Kトークンで失敗する可能性があります。アーキテクチャ上の上限は、重み、KVキャッシュ、計算バッファ、そしてデスクトップコンポジターが同時にあなたのGPUに収まることを約束したことはありませんでした。
LLMの次は何なのか?ポストTransformer時代。
AIの熱狂には一定のリズムがあります。およそ3年ごとに、皆が期待を寄せていたアーキテクチャが、それより新しい技術に置き換えられていきます。次の転換点はすでに研究ラボの中で形成されています。
コマンドラインからOpenCodeを実際に使う
OpenCodeのコマンドラインインターフェース(CLI)は、スクリプティング、CIパイプライン、および無人のエージェント実行のために設計されています。本記事では、日常業務での実用的な使い方を指南します。
1つのコマンドでインストール可能な、強制SDDスキル。
Superpowers は、仕様駆動開発の完全な方法をインストール可能な Claude Skills にパッケージ化しており、ブレインストーミング、計画立案、サブエージェントによる実装、厳格なTDD(テスト駆動開発)を強制します。これらの構造をユーザー自身に委ねることはありません。
形を整えることを前提とした小型コーディングエージェント。
Pi Coding Agentは、4つのデフォルトツールを搭載し、ほとんどの動作を拡張機能、スキル、およびユーザー自身のワークフローに委ねる、最小限かつオープンソースのターミナルコーディングハーネスです。
なぜAIスタックは毎月より強力な依存関係を生み出すのか
すべてのAPI呼び出しは、簡単な取引のように感じられます。しかし、それらが積み重なり、ファインチューニング用のデータ、評価ハーネス、ツールスキーマがすべて1つのベンダーに合わせて形作られると、ベンダーの切り替えは「ルーティングの変更」では済まなくなります。
ノイズの多い作業は委譲し、コンテキストをクリーンに保ちましょう。
ほとんどの Claude Code セッションが遅くなり、混乱に陥るのは同じ理由によります。探索的な grep、ログのダンプ、そして「もう1つのファイルを確認してみよう」といった動作が、メインの会話に永遠に残り続けるからです。
OllamaからvLLMへの移行タイミング
Ollamaはローカルでの言語モデル実行において最も手軽な方法の一つですが、その手軽さゆえに、ローカルの実験がスケジューリングや可観測性が必要な共有推論サービスへと移行すべきタイミングを隠してしまいます。
AIエージェントが仕様、テスト、コードから逸脱するのを防ぎましょう。
AIコーディングエージェントは機能を迅速に提供しますが、仕様書、テスト、コードは静かに乖離していきます。このガイドでは、トレーサビリティモデル、仕様からテストおよびコードへのマッピング、そしてマージ前に乖離を検知するCIチェックについて解説します。
コンパイルされた知識の信頼性を確保する
LLMウィキは、古い事実が依然として妥当に見えるようになり、矛盾が磨き上げられ、生成された要約が元々の情報源から逸脱した際に失敗します。
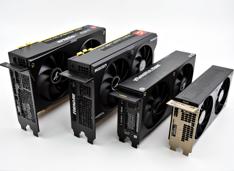
3社によるAI GPUの比較
2026年、AIハードウェアの状況は大きく変化しました。NVIDIA、AMD、Intelの各社が、ローカル環境で大型言語モデル(LLM)やAI推論ワークロードを実行できるGPUを必要とする開発者を獲得するため、激しい競争を繰り広げています。
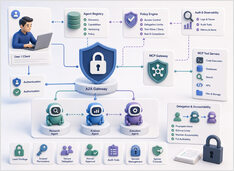
プロトコルセキュリティはモデルではなく、誰が実行できるか(誰が操作を行えるか)を定義するものです。
LLMシステムにおけるセキュリティの関心は、プロンプトインジェクションに最も集中していますが、それは確かに注目を集めるべきものです。しかし、エージェントがツールを呼び出し、他のエージェントに作業を委任し始めると、それは問題の一部に過ぎなくなります。
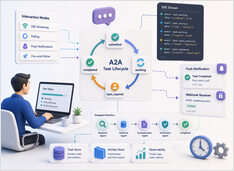
長期実行されるA2Aタスクは、チャットセッションの終了後も継続して実行されます。
ほとんどのAIエージェントのデモは、追加のステップを伴うチャット補完のように振る舞います。プロンプトを送信し、数秒待ってから、1つのレスポンスとして回答を受け取ります。
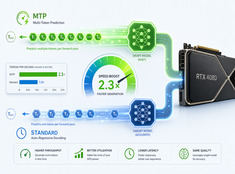
品質を落とさずにLLM推論を高速化する実践ガイド
70Bモデルは1回のフォワードパスで1トークンを生成し、各パスでVRAMから重みを読み込み、コンテキスト全体のAttentionを計算し、メモリを同期します。トークンの間では、GPUはシーケンシャルな依存関係が解決するのを待っている間にアイドル状態になります。
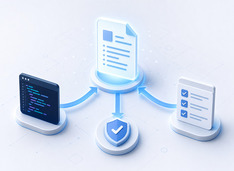
仕様を唯一の信頼できる情報源とし、付属文書としない。
仕様駆動開発(Spec-Driven Development)は、ソフトウェアエンジニアが以前から模索してきたものの、その労力に見合う成果が得られなくなった際に棚上げされてきたアイデアの一つです。
正の源としての仕様、それとも遅い儀式か?
スペック駆動開発(Spec-Driven Development)は、2026年において、ビブコーディング(Vibe Coding)による方向性のブレに対する、真面目な開発者としての回答として登場しました。