
2026年のGoogle A2Aプロトコル:採用状況、過熱と現実
A2Aは死んでいません。単に普遍的ではないだけです。
GoogleのAgent2Agentプロトコル、一般的にA2Aと略されるこの規格は、最初の1年間で奇妙な展開をみせました。
A2Aは死んでいません。単に普遍的ではないだけです。
GoogleのAgent2Agentプロトコル、一般的にA2Aと略されるこの規格は、最初の1年間で奇妙な展開をみせました。
AIエージェントのための信頼性の高いポーリングパターン
ポーリングエージェントは、AIアシスタントのアーキテクチャの中で最も華やかではない部分の一つですが、同時に最も有用な部分の一つでもあります。
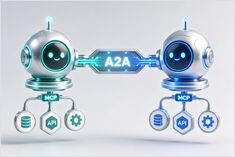
MCPはエージェントにツールを提供します。A2Aはエージェントに同僚を提供します。
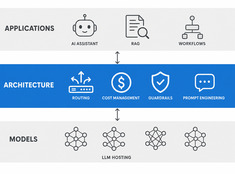
AIエージェントのアーキテクチャは、2つのレイヤーに分裂し始めています。
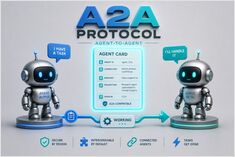
「A2Aはエージェントをネットワークピアに変換します。」
Agent2Agentプロトコルの略称であるA2Aプロトコルは、独立したAIエージェントシステム間の通信のためのオープン標準です。
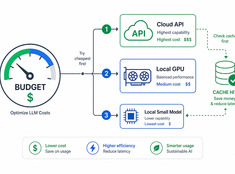
トークンを本当に重要な箇所に使いましょう。
LLMのコストは使用量に比例して線形に増加します。1日に10,000件のリクエストを処理し、1件あたり$0.01のシステムの場合、日次コストは$100、年間コストは$365になります。エンタープライズ規模になると、コストは$10,000を超えます。
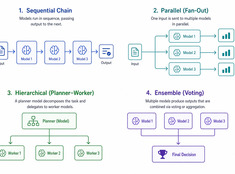
機能する最もシンプルなパターンを選択してください。
単一モデルのシステムはシンプルです。マルチモデルのシステムは強力です。課題はモデルの選択ではなく、それらをオーケストレートするアーキテクチャの設計にあります。
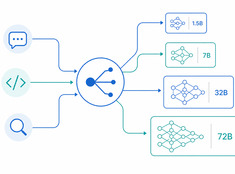
「正しいタスクに、正しいモデルを。」
700億パラメータのモデルで200語のメール要約を行うのは無駄です。30億パラメータのモデルで本番コードのレビューを行うのは無謀です。大多数のシステムは、これら2つの極端の間に位置しています。まさにそこが、モデルルーティングの出番です。
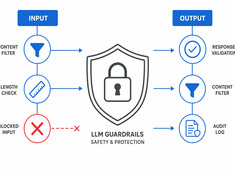
管理すべきはモデルではなく、リスクです。
LLM(大規模言語モデル)は予測不可能です。幻覚(ハルシネーション)を起こし、データを漏洩させ、有害なコンテンツを生成したり、正当なリクエストを拒否したりします。ガードレール(防護策)は、機能を損なわずにモデルの動作を制限します。
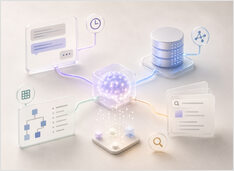
アシスタントのためのワーキングメモリ、構造化メモリ、検索メモリ
メモリはアシスタントを反応型のシステムから持続的なシステムへと変えますが、同時に多くのシステムが静かに腐敗していく場所でもあります。最近の調査では、現代的なエージェントのメモリに対して、短期記憶と長期記憶の二元論はもはや十分ではないと指摘されています。OpenAIやLangGraphのSDKは、よりシンプルなスタックを提唱しています。すなわち、ワーキングメモリ、永続状態、そして検索(リトリーバル)です。
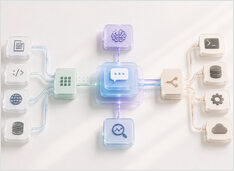
シリアスなアシスタントは実際にはどのように構築されているか。
本番環境で運用されるAIアシスタントは、「プロンプトを与えたLLM」ではありません。ユーザーの意図を受け取り、状態を保持し、検索やアクションを行うタイミングを判断し、障害のデバッグに必要なランタイムの詳細情報を公開するシステムです。
AIは知識管理の目的を変えず、手法を変革する。
AIは知識管理を置き換えるものではありません。むしろ、個人およびチームにとって知識管理の形そのものを変革しています。
スター数、トークン数、ダウンロード数――どれが本当に優位か?
オープンソースの AI エージェントフレームワークが、GitHub 上で人気が爆発しています。 セルフホスト型 AI システム エコシステムの核心に位置する 2 プロジェクト——OpenClaw と Hermes Agent——は、他のどのプロジェクトよりも大きく差を広げており、残りの競合プロジェクトは遠く離れた 3 位争いを行っています。
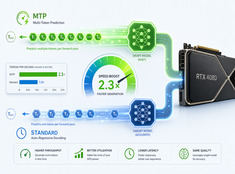
RTX 4080におけるMTPと標準デコーディングの実ベンチマーク比較
Qwen 3.6 27B と 35B において、RTX 4080(16 GB VRAM)上で投機的デコーディング(マルチトークン予測、MTP)のパフォーマンスをテストしました。
llama-serverを停止せずにVRAMを解放する方法
llama.cpp ラーターモード は、llama-server における数年間で最も有用な変更の一つです。これにより、ローカルLLM運用者は、Ollamaで期待されるようなモデル管理体験に近いものをようやく手に入れることができました。同時に、llama-server を使い続ける価値がある生のパフォーマンスと低レベルの制御も維持されています。
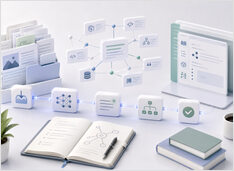
AIシステム向けの構造化された知識
前提はシンプルです。コンパイルされた知識は、取得された断片的な情報よりも再利用性が高いというものです。 RAG(検索強化生成)は、LLM(大規模言語モデル)に外部知識へのアクセスをどのように与えるかという直接的な問いに対するデフォルトの答えとなりました。