
RAGにおけるチャンキング戦略の比較:代替案、トレードオフ、および例
RAGにおけるチャンキング戦略の比較
Chunking は、Retrieval ‑ Augmented Generation (RAG) において 最も過小評価されている ハイパラメータです。
静かに、LLM が「何を見ているか」を決定し、インジェストのコストをどのくらい高めるか、そしてLLMのコンテキストウィンドウがどのくらい使われるかを決めています。
RAGにおけるチャンキング戦略の比較
Chunking は、Retrieval ‑ Augmented Generation (RAG) において 最も過小評価されている ハイパラメータです。
静かに、LLM が「何を見ているか」を決定し、インジェストのコストをどのくらい高めるか、そしてLLMのコンテキストウィンドウがどのくらい使われるかを決めています。
基本的なRAGから本番環境へ:チャンキング、ベクトル検索、リランキング、および評価を1つのガイドで網羅。
セルフホスト型LLMでデータとモデルを制御
LLM(大規模言語モデル)のセルフホスティングは、データ、モデル、推論をあなたの管理下に保つものであり、チーム、企業、国家にとって AI主権 を実現するための実用的な手段です。
2026年10月に話題のPythonリポジトリ
今月の Python エコシステムは、Claude Skills と AI エージェントのツールが主導しています。 本記事では、 GitHub 上で急上昇している Python リポジトリについて分析します。
2026年10月にトレンドにのっているGoリポジトリ
Goのエコシステムは引き続き拡大を続けており、今月の注目リストにはAIエージェントのインフラストラクチャ関連プロジェクトが多数ランクインしています。本記事では、今月のGitHubにおける注目Goリポジトリの状況を分析しています。
ローカルLLMを使用してCogneeをテストする - 実際の結果
CogneeはPythonフレームワークで、LLMを使用してドキュメントから知識グラフを構築します。 しかし、これはセルフホストされたモデルと互換性がありますか?
LLMを自社でホストするCogneeについての考察
Best LLM for Cognee を選ぶ際には、グラフ構築の質、幻覚率、ハードウェアの制約のバランスが求められます。
Cognee は、Ollama を介して 32B 以上の低幻覚モデルで優れた性能を発揮しますが、軽量な設定では中規模のオプションも使用可能です。
PythonとOllamaでAI検索エージェントを構築する
OllamaのPythonライブラリには、今やネイティブのOllama ウェブ検索機能が搭載されました。わずか数行のコードで、ウェブからのリアルタイム情報をローカルのLLMに追加することで、ハルシネーション(幻覚)を減らし、精度を向上させることができます。
RAG スタックに適したベクター DB を選択しましょう
適切な ベクトルストア を選択することは、RAG アプリケーションのパフォーマンス、コスト、スケーラビビリティを決定づけます。この包括的な比較では、2024-2025 年における最も人気のあるオプションを取り上げています。
GoとOllamaでAI検索エージェントを構築する
OllamaのWeb検索APIにより、ローカルLLMにリアルタイムのWeb情報を付加できます。このガイドでは、シンプルなAPI呼び出しからフル機能の検索エージェントまで、GoでのWeb検索機能の実装方法を示します。
2026年の優れたローカルLLMホスティングツールを比較します。APIの成熟度、ハードウェアサポート、ツールコール機能、そして実用例です。
ローカルでLLM(大規模言語モデル)を動かすことは、現在、開発者、スタートアップ、さらにはエンタープライズのチームにとって現実的な選択肢となっています。 しかし、適切なツールの選択——Ollama、vLLM、LM Studio、LocalAI、あるいはそれ以外のツール——は、あなたの目標によって異なります。
オープンモデルを活用して、予算内のハードウェアでエンタープライズAIをデプロイする
AI の民主化はここにやってきました。 Llama、Mistral、Qwen などのオープンソース大規模言語モデル(LLM)が現在、プロプライエタリなモデルと競合するレベルに達しており、チームは 消費级ハードウェアを使用した AI インフラストラクチャ を構築することで、コストを削減しながらもデータプライバシーとデプロイの完全な制御を維持することが可能になりました。
LongRAG、Self-RAG、GraphRAG - 次世代の技術
検索拡張生成(RAG) は、単純なベクター類似度検索を大きく超えた進化を遂げています。 LongRAG、Self-RAG、GraphRAGは、これらの機能の最先端を代表しています。
インテリジェントなトークン最適化でLLMコストを80%削減
トークン最適化は、コスト効率の高いLLMアプリケーションと、予算を浪費するだけの実験を分ける重要なスキルです。
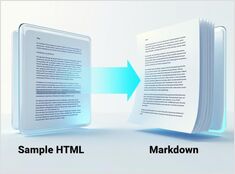
HTMLをクリーンでLLM対応のMarkdownに変換するためのPython
HTMLをMarkdownに変換は、LLM(大規模言語モデル)やドキュメンテーションシステム、Hugoなどの静的サイトジェネレーター向けのウェブコンテンツ準備において、現代の開発ワークフローにおいて基本的なタスクです。このガイドは、2026年のドキュメンテーションツール: Markdown、LaTeX、PDFおよび印刷ワークフロー ハブの一部です。
OllamaとGoの統合:SDKガイド、例、および本番環境でのベストプラクティス
このガイドでは、利用可能な Ollama 用の Go SDK の概要を網羅的に示し、その機能セットを比較します。