
PythonでOllama Web Search APIを使用する
PythonとOllamaを使ってAI検索エージェントを構築する
OllamaのPythonライブラリは、今やOLlama web searchのネイティブな機能を含んでいます。わずか数行のコードで、ローカルのLLMをインターネット上のリアルタイム情報を補完し、幻覚を減らし、正確性を向上させることができます。
PythonとOllamaを使ってAI検索エージェントを構築する
OllamaのPythonライブラリは、今やOLlama web searchのネイティブな機能を含んでいます。わずか数行のコードで、ローカルのLLMをインターネット上のリアルタイム情報を補完し、幻覚を減らし、正確性を向上させることができます。
RAG スタックに適したベクター DB を選択しましょう
適切な ベクトルストア を選択することは、RAG アプリケーションのパフォーマンス、コスト、スケーラビビリティを決定づけます。この包括的な比較では、2024-2025 年における最も人気のあるオプションを取り上げています。
GoとOllamaを使ってAI検索エージェントを構築する
OllamaのWeb検索APIは、ローカルLLMにリアルタイムのウェブ情報を補完する機能を提供します。このガイドでは、GoでのWeb検索の実装について、単純なAPI呼び出しからフル機能の検索エージェントまでの実装方法を示します。
2026年の優れたローカルLLMホスティングツールを比較します。APIの成熟度、ハードウェアサポート、ツールコール機能、そして実用例です。
ローカルでLLM(大規模言語モデル)を動かすことは、現在、開発者、スタートアップ、さらにはエンタープライズのチームにとって現実的な選択肢となっています。 しかし、適切なツールの選択——Ollama、vLLM、LM Studio、LocalAI、あるいはそれ以外のツール——は、あなたの目標によって異なります。
Goマイクロサービスで堅牢なAI/MLパイプラインを構築する
AIおよびMLワークロードがますます複雑化するにつれて、堅牢なオーケストレーションシステムの必要性が高まっています。 Goのシンプルさ、パフォーマンス、並行処理能力は、モデル自体がPythonで記述されていても、MLパイプラインのオーケストレーション層の構築に理想的な選択肢となります。
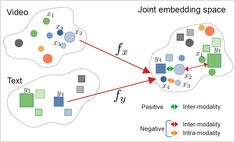
テキスト、画像、音声を共有された埋め込み空間に統一する
クロスモーダル埋め込みは、人工知能において画期的な進展をもたらし、統一された表現空間内で異なるデータタイプ間の理解と推論を可能にします。
オープンモデルを活用して、予算内のハードウェアでエンタープライズAIをデプロイする
AI の民主化はここにやってきました。 Llama、Mistral、Qwen などのオープンソース大規模言語モデル(LLM)が現在、プロプライエタリなモデルと競合するレベルに達しており、チームは 消費级ハードウェアを使用した AI インフラストラクチャ を構築することで、コストを削減しながらもデータプライバシーとデプロイの完全な制御を維持することが可能になりました。
LongRAG、Self-RAG、GraphRAG - 次世代の技術
検索拡張生成 (RAG) は、単純なベクトル類似度検索の域を遥かに超えて進化しました。LongRAG、Self-RAG、GraphRAG は、これらの能力の最先端を代表しています。

GGUF量子化でFLUX.1-devを高速化
FLUX.1-dev は、驚くほど美しい画像を生成できる強力なテキストから画像生成モデルですが、24GB以上のメモリが必要なため、多くのシステムでは実行が難しいです。 GGUF量化されたFLUX.1-dev は、メモリ使用量を約50%削減しながらも、優れた画像品質を維持するという解決策を提供します。
Docker Model Runnerでコンテキストサイズを設定する際の回避策
Docker Model Runnerにおけるコンテキストサイズの設定は、本来よりも複雑です。

テキスト指示を使って画像を拡張するためのAIモデル
ブラックフォレスト・ラボズは、FLUX.1-Kontext-devという高度な画像から画像へのAIモデルをリリースしました。このモデルは、テキストの指示を使って既存の画像を補強します。
NVIDIA CUDAをサポートしたDocker Model RunnerでGPU加速を有効にする
Docker Model Runner は、Dockerが公式に提供するローカルでAIモデルを実行するためのツールですが、
Docker Model RunnerにおけるNVidia GPUの加速の有効化 には特定の設定が必要です。
スマートなトークン最適化でLLMのコストを80%削減
トークンの最適化は、コスト効率の高いLLMアプリケーションと、予算を浪費する実験を分けるための重要なスキルです。
GPT-OSS 120bの3つのAIプラットフォームにおけるベンチマーク
私は、Ollama上でGPT-OSS 120bのパフォーマンステストを3つの異なるプラットフォームで確認しました:NVIDIA DGX Spark, Mac Studio, and RTX 4080。OllamaライブラリのGPT-OSS 120bモデルは65GBあり、これはRTX 4080(または新しいRTX 5080の16GB VRAMには収まらないことを意味します。
Pythonの例を使ってAIアシスタント用のMCPサーバーを構築する
モデルコンテキストプロトコル(MCP)は、AIアシスタントが外部データソースやツールとどのように相互作用するかを革命的に変えてきました。本ガイドでは、ウェブ検索およびスクレイピング機能に焦点を当てた例を用いて、MCPサーバーをPythonで構築する方法について説明します。
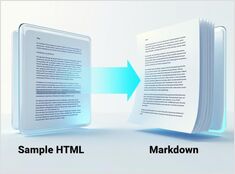
HTMLをクリーンでLLM対応のMarkdownに変換するためのPython
HTMLをMarkdownに変換は、LLM(大規模言語モデル)やドキュメンテーションシステム、Hugoなどの静的サイトジェネレーター向けのウェブコンテンツ準備において、現代の開発ワークフローにおいて基本的なタスクです。このガイドは、2026年のドキュメンテーションツール: Markdown、LaTeX、PDFおよび印刷ワークフロー ハブの一部です。