
Oh My Opencode QuickStart for OpenCode:インストール、設定、実行
Oh My Opencode をインストールして、より高速にリリースしましょう。
Oh My Opencode は、OpenCode をマルチエージェントコーディングハネスへと変えます。オーケストレーターは、並行して実行される専門エージェントに作業を委任します。
Oh My Opencode をインストールして、より高速にリリースしましょう。
Oh My Opencode は、OpenCode をマルチエージェントコーディングハネスへと変えます。オーケストレーターは、並行して実行される専門エージェントに作業を委任します。
OpenCode LLM テスト — コーディングおよび精度の統計
Ollama と llama.cpp でローカルホストされている複数の LLM と、比較のために追加した OpenCode Zen の無料モデルとの組み合わせで、OpenCode がどのように動作するかをテストしました。
シジフォスとその専門エージェントチームをご紹介します。
OpenCode の最大の能力向上は、専門化されたエージェントによるものです:オーケストレーション、計画、実行、調査の意図的な分離です。
CLIインストール、フラグ、ヘッドレス、ローカルモデル
OpenHands は、サンドボックス内でファイルを編集し、コマンドを実行するオープンソースのコーディングエージェントです。本CLIのクイックスタートは、2026年10月26日にパッケージバージョン 1.16.0 に対して検証済みです。
数分で LocalAI を使用して、OpenAI 互換 API をセルフホストできます。
LocalAI は、ご自身のハードウェア(ノート PC、ワークステーション、オンプレミスサーバー)上で AI ワークロードを実行できるように設計された、自己完結型でローカルファーストの推論サーバーです。これは、OpenAI API と互換性のある「差し替え可能な」APIとして動作します。
Prometheus と Grafana を用いた LLM の監視
LLM の推論は「ただの API」のように見えますが、レイテンシが急増し、キューが backlog して、GPU のメモリ使用率が 95% に達しても明確な説明ができない状況に直面した際に、その真の姿が明らかになります。
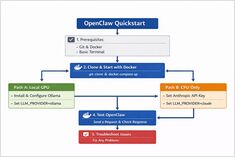
Ollamaを使用してOpenClawをローカルにインストール
OpenClawは、OllamaなどのローカルLLMランタイムや、Claude Sonnetなどのクラウドベースのモデルと併用して実行できる、セルフホスト型のAIアシスタントです。
AWS S3、Garage、MinIO:概要と比較
AWS S3は、オブジェクトストレージにおける「デフォルト」の基準です。完全なマネージドサービスであり、強い整合性を保ち、極めて高い耐久性と可用性のために設計されています。 GarageとMinIOはセルフホスト型で、S3互換の代替手段です。Garageは、軽量で地理的に分散された中小型クラスタのために設計されており、MinIOはより広いS3 API機能のカバレッジと、大規模デプロイにおける高いパフォーマンスを重視しています。
数分でDocker上でGarageを実行する
Garage は、小規模から中規模の展開に最適化された、オープンソースでセルフホスト可能な S3 互換のオブジェクトストレージシステムです。これは、高耐性と地理的分散性を強調しています。
セルフホスト型LLMでデータとモデルを制御
LLM(大規模言語モデル)のセルフホスティングは、データ、モデル、推論をあなたの管理下に保つものであり、チーム、企業、国家にとって AI主権 を実現するための実用的な手段です。
RTX 4080(VRAM 16GB)におけるLLM速度テスト
大規模言語モデル(LLM)をローカルで実行することで、プライバシーの保護、オフラインでの利用、そしてAPIコストのゼロ化を実現できます。 このベンチマークでは、RTX 4080上でOllamaを使用する14のポピュラーなLLMの性能について、何を期待できるかを具体的に明らかにします。
2026年10月にトレンドにのっているGoリポジトリ
Goのエコシステムは引き続き拡大を続けており、今月の注目リストにはAIエージェントのインフラストラクチャ関連プロジェクトが多数ランクインしています。本記事では、今月のGitHubにおける注目Goリポジトリの状況を分析しています。
2025年1月GPUおよびRAM価格チェック
今日、トップレベルの消費者向けGPUとRAMモジュールについて見てみましょう。
特に注目しているのは、RTX-5080およびRTX-5090の価格と、32GB(2x16GB)DDR5 6000です。
ローカルLLM向けのセルフホスト型ChatGPT代替ツール
Open WebUI は、大規模言語モデル(LLM)と対話するための、パワフルで拡張性があり、機能が豊富なセルフホスト型 Web インターフェースです。
2026年のvLLMのインストール、サービング、およびチューニング
vLLMは、UC BerkeleyのSky Computing Labが開発した、大規模言語モデル(LLM)向けの高スループットでメモリ効率の良い推論・サービングエンジンです。