
DockerモデルランナーへのNVIDIA GPUサポートの追加
NVIDIA CUDAをサポートしたDocker Model RunnerでGPU加速を有効にする
Docker Model Runner は、Dockerが公式に提供するローカルでAIモデルを実行するためのツールですが、
Docker Model RunnerにおけるNVidia GPUの加速の有効化 には特定の設定が必要です。
NVIDIA CUDAをサポートしたDocker Model RunnerでGPU加速を有効にする
Docker Model Runner は、Dockerが公式に提供するローカルでAIモデルを実行するためのツールですが、
Docker Model RunnerにおけるNVidia GPUの加速の有効化 には特定の設定が必要です。

ヘッドレスCMSの比較 - 機能、パフォーマンスおよびユースケース
正しい ヘッドレス CMS の選択は、コンテンツ管理戦略を成功させるか、失敗させるかを左右します。 開発者がコンテンツ駆動型アプリケーションを構築する方法に影響を与える3つのオープンソースソリューションを比較してみましょう。

ご自身でホストするAIを活用したバックアップに使用される写真
Immich は、あなたの思い出を完全にコントロールできる、革新的なオープンソースでセルフホスト型の写真および動画管理ソリューションです。Google Photos と競合する機能を備えており、AI による顔認識、スマート検索、自動モバイルバックアップを含みながら、あなたのデータをプライバシーとセキュリティを保ったまま、あなたのサーバー上に保管します。
検索、インデックス作成、および分析のための Elasticsearch コマンド
Elasticsearch は、Apache Lucene を基盤に構築された強力な分散型検索および分析エンジンです。 この包括的なチートシートでは、Elasticsearch クラスターを操作するための重要なコマンド、ベストプラクティス、およびクイックリファレンスを取り上げています。
GPT-OSS 120bの3つのAIプラットフォームにおけるベンチマーク
私は、Ollama上でGPT-OSS 120bのパフォーマンステストを3つの異なるプラットフォームで確認しました:NVIDIA DGX Spark, Mac Studio, and RTX 4080。OllamaライブラリのGPT-OSS 120bモデルは65GBあり、これはRTX 4080(または新しいRTX 5080の16GB VRAMには収まらないことを意味します。
Docker Model Runner コマンドのクイックリファレンス
Docker Model Runner (DMR) は、2025年4月に導入された Docker の公式ソリューションで、AIモデルをローカルで実行するためのものです。このチートシートでは、すべての必須コマンド、構成、およびベストプラクティスのクイックリファレンスを提供しています。
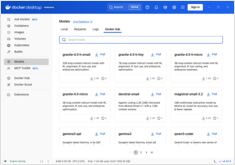
Docker Model RunnerとOllamaを比較してみる:ローカルLLM向け
ローカルで大規模言語モデル(LLM)を実行する は、プライバシー、コスト管理、オフライン機能のためにますます人気になってきています。 2025年4月にDockerが**Docker Model Runner (DMR)**を導入し、AIモデルの展開用の公式ソリューションとして登場したことで、状況は大きく変わりました。
GNOME Boxes による Linux 用のシンプルな仮想マシン管理
現代のコンピューティング環境において、仮想化は開発、テスト、複数のオペレーティングシステムの実行において不可欠となっています。Linuxユーザーが仮想マシンを簡単に管理できる方法を探している場合、GNOME Boxesは、機能性を犠牲にすることなく、軽量で使いやすいオプションとして際立っています。
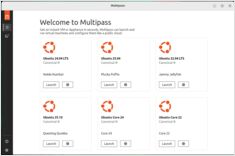
マルチパスのインストール、設定、および基本的なコマンド
Multipass は、Linux、Windows、macOS で Ubuntu クラウドインスタンスを作成および管理するのに役立つ軽量な仮想マシンマネージャです。
グーグルやバイング以外の代替の検索エンジンを探してみましょう
グーグルがグローバル市場シェアの90%以上を占める検索エンジン市場を支配している一方で、代替検索エンジンという成長中のエコシステムが、ウェブ検索に異なるアプローチを提供しています。
ASICおよびカスタムシリコンにより、LLM推論の速度と効率を追求する
コンテンツを所有し、アイデンティティをコントロールしましょう
ウェブはもともと、誰でも公開し、接続できる分散型ネットワークとして設計されていました。しかし、時間が経つにつれて、企業のプラットフォームが権限を集中させ、ユーザーが製品となり、コンテンツがロックインされるウォールド・ガーデンを作り出しました。Indie Web movementは、ウェブの元々の約束を復活させることを目指しています:個人所有、創造の自由、そして本物のつながり。
6カ国の実売価格、供給状況、およびMac Studioとの比較
NVIDIA DGX Spark は実在しており、2025年10月15日に発売開始予定です。CUDA環境でのローカルLLM作業を必要とする開発者向けに、統合されたNVIDIA AIスタックを搭載しています。アメリカのMSRPは3,999ドルですが、英国/ドイツ/日本の小売価格はVAT(付加価値税)や流通経費により高くなります。豪ドル/韓ウォンでの公定価格はまだ広く公開されていません。
ジェミニ - ネットワークの軽量で安全な代替手段
Geminiプロトコルは、インターネット通信の基本に立ち返ったものです。複雑化する現代のウェブに代わる、軽量で安全でプライバシーを尊重する代替手段です。
OllamaとGoの統合:SDKガイド、例、および本番環境でのベストプラクティス
このガイドでは、利用可能な Ollama 用の Go SDK の概要を網羅的に示し、その機能セットを比較します。
これらの2つのモデルの速度、パラメータ、性能を比較する
以下は、Qwen3:30b と GPT-OSS:20bの比較です。 指示への追従(Instruction Following)および性能パラメータ、仕様、速度に焦点を当てています。