
Pythonで堅牢なLLM構造化出力の検証
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
「雰囲気」に頼る解析をやめ、契約を検証せよ。
ほとんどのLLM「構造化出力」チュートリアルは、本気度にかけるものです。 それらは、JSONを丁寧な口調でリクエストし、モデルが適切に動作することを祈る方法を教えます。 それでは検証ではありません。 それは単に括弧で囲まれた楽観主義にすぎません。
エージェント型LLMのチューニングに関する参照資料
このページは、エージェント型LLM推論チューニングの実用的なリファレンス(temperature、top_p、top_k、ペナルティ、およびマルチステップやツール多用なワークフローにおけるそれらの相互作用)です。
より広範なLLMパフォーマンスエンジニアリングハブと併せて参照し、明確なLLMホスティングとサービングの概要と組み合わせることで、モデルがリソース不足に陥った際にはスループットとスケジューリングが依然として支配的ですが、不安定なサンプリングはGPUが処理を終える前にリトライと出力トークンを消費してしまうことがわかります。
このページでは以下をまとめます:
現在、以下に焦点を当てています:
スマートフォンからHermesと会話する
スマートフォンからテキストでヘルメスエージェントとチャットすることはすでに可能でしょう。 今、あなたはエージェントと直接会話し、音声で返信を受け取りたいと考えています。 これは通常、正しい選択です。特にHermesを永続的な自己ホスト型アシスタントとして使用している場合には顕著です。 小さな画面で長いプロンプトをタイプするのは、時間がかかり、誤りも生じやすいものです。
セルフホスト型LLMのHermesカンバンの負荷を制御する。
Hermes Agentには、Kanbanスタイルのボードと、一度に多くのタスクがディスパッチされるとセルフホスト型LLMを飽和状態にしてしまう可能性のあるHermes Gatewayが同梱されています。
著者:Hermes。高速に読み込まれ、安定して動作するスキル。
Hermes Agentは、繰り返し可能なワークフローを教えるデフォルトの方法としてスキルを採用しています。公式ドキュメントでは、スキルはオープンなagentskills.io仕様に準拠したオンデマンド型ナレッジ文書と説明されており、**プログレッシブ・ディスクロージャー(段階的開示)**によってモデルがまず小さなインデックスを見て、タスクが実際に必要としたときにのみ完全な指示を取得する仕組みになっています。
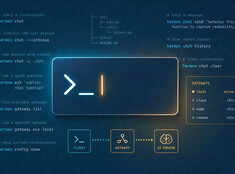
セルフホストされたHermes Agent用シェルおよびTUIコマンド。
Nous Research が提供する Hermes Agent は、モデル非依存型でツール利用可能なアシスタントであり、ローカルまたは VPS で実行し、シェル、全画面表示の TUI、メッセージングゲートウェイのいずれからでも利用できます。
NemoClawでOpenClawを安全に実行
大多数のAIエージェントスタックは、セキュリティをデモ後の修正事項として扱っています。 NemoClawは対極の前提から始まり、隔離、ポリシー、ルーティングを初期設定(Day-Zero defaults)として採用しています。
単一のチャットスレッドを超えた持続的なナレッジ。
このセクションでは、AIシステムの永続的な知識とメモリに関するガイドをまとめています。アシスタントがすべてのトークンを1つのプロンプトに詰め込むことなく、セッションをまたいで事実、設定、抽出されたコンテキストをどのように保持するかについて解説しています。ここでは、メモリとは意図的な保持(ユーザーの事実、要約、プラグイン連携によるストア)を指し、GPU RAMやモデルの重みを指すものではありません。
キャプチャポリシーの重要性は、リコールと同等までに高まっている。
2026年9月更新: MnemosyneとMemoriを追加し、HonchoとHindsightの設定を拡張しました。また、元のインフラストラクチャ表に加えてキャプチャポリシー比較表を追加しました。
タブを閉じるとすべての記憶を失う現代のAIアシスタントに対し、コンテキストウィンドウを超えて永続化する何かが必要になります。エージェントメモリプロバイダーとは、セッション間で事実や要約を保持するサービスやライブラリであり、フレームワークをスリムに保ちつつメモリをスケーリングするために、多くの場合プラグインとして組み込まれます。
本ガイドでは、Hermes Agentの外部メモリプラグインとして提供されるメモリバックエンド(Honcho、OpenViking、Mem0、Hindsight、Holographic、RetainDB、ByteRover、Supermemory、Mnemosyne、Memori)を比較し、それらがより広い**AIシステムのスタックにどのように組み込まれるかを説明します。同じベンダーは、コミュニティまたは公式統合を通じて、OpenClawや他のエージェントツールにも登場します。AIシステム メモリハブ**には、この記事に加えCogneeや関連するガイドがリストされています。
Hermesに固有のバウンデッドコアメモリ(MEMORY.mdとUSER.md)、フリーズ動作、トリガーについては、**Hermes Agent メモリシステム**を参照してください。HermesのネイティブメモリプロバイダーがOpenClawに対する採用優位性の拡大(GitHubスター数、OpenRouterトークンランキング、エコシステム規模の比較など)にどのように貢献しているかという背景については、OpenClaw vs Hermes Agent: Stars, Downloads & Usage 2026を参照してください。
メモリこそが、ツールとパートナーとの違いを創り出す。
AI エージェントとのチャットを開始し、プロジェクトの概要を説明し、好みを共有し、いくつかの作業を行い、タブを閉じる。その翌週にもう一度戻ってくると、まるで見知らぬ人と話しているかのようですね。すべてのコンテキストが失われ、すべての好みは忘れられ、プロジェクトはゼロから再説明しなければなりません。
OpenClawは急速に台頭し、その後、さらに急速に姿を消した。
OpenClawは製品として失敗したわけではありません。単に「燃料」を失っただけです。
再起動せずにLLMを配信・切り替え可能。
長らく、llama.cpp には致命的な制限がありました。
それは、1プロセスにつき1つのモデルしか提供できず、モデルを切り替えるには再起動が必要だった点です。
本番環境で耐えるClaude Skillsの構築
ほとんどのチームは、Claude Skillsの使い方を2つのいずれかの誤った方法で運用しています。SKILL.mdを単なるゴミ箱のように使っているか、巨大なプロンプトの切り貼りから抜け出せずにいるかのどちらかです。
本格的なワークロード向け「Profile-first」Hermes設定
公式にはHermes Agentとして文書化されているHermes AIアシスタントは、単なるチャットラッパーとしては位置づけられていません。
保持すべきスキルと、スキップしてよいスキル
OpenClawには2つの拡張ストーリーがあり、それらは混同されやすいものです。
プラグインはランタイムを拡張します。スキルはエージェントの振る舞いを拡張します。
まずはプラグイン。スキルの名称を簡潔に。
この記事は、チャネル、モデルプロバイダー、ツール、音声、メモリ、メディア、Web 検索、その他ランタイムの表面機能などを追加するネイティブゲートウェイパッケージであるOpenClaw プラグインについて解説します。