LLM

llama.swap モデル切り換え器の OpenAI 互換ローカル LLM 向けクイックスタート

llama.swap モデル切り換え器の OpenAI 互換ローカル LLM 向けクイックスタート

クライアントを変更せずにホットスワップ可能なローカル LLM。

まもなく vLLM や llama.cpp など、それぞれのスタックが独自のポートで稼働している状態に陥ります。下流のシステムはすべて**/v1というベース URL を求めるため、ポート、プロファイル、ワンオフスクリプトを頻繁に変更することになります。llama-swapは、これらのスタックの前に配置される/v1**プロキシです。
LocalAI QuickStart: ローカルで OpenAI 互換 LLM を実行する

LocalAI QuickStart: ローカルで OpenAI 互換 LLM を実行する

数分で LocalAI を使用して、OpenAI 互換 API をセルフホストできます。

LocalAI は、ご自身のハードウェア(ノート PC、ワークステーション、オンプレミスサーバー)上で AI ワークロードを実行できるように設計された、自己完結型でローカルファーストの推論サーバーです。これは、OpenAI API と互換性のある「差し替え可能な」APIとして動作します。

llama.cpp クイックスタート:CLIとサーバー

llama.cpp クイックスタート:CLIとサーバー

OpenCode のインストール、設定、および使用方法

ローカル推論にllama.cppに何度も戻っています。Ollamaなどが抽象化している制御を直接手に入れられる上、動作も安定しています。GGUFモデルをllama-cliで対話的に実行したり、llama-serverOpenAI互換のHTTP APIを公開したりするのが簡単です。

AI開発ツール:AI駆動開発の完全ガイド

AI開発ツール:AI駆動開発の完全ガイド

人工知能(AI)は、ソフトウェアの書き方、レビュー、デプロイ、および保守のあり方を根本から変えています。AIコーディングアシスタントからGitOps自動化、DevOpsワークフローに至るまで、開発者は現在、ソフトウェアライフサイクル全体にわたってAI駆動型ツールに頼っています。

このページは、当サイトにおけるAI開発ツールに関連するすべての情報への中核ハブです。チュートリアル、比較、チートシート、そして最新のAI支援開発ワークフローに関するディープダイブ記事を結びつける役割を果たしています。


AI開発ツールとは?

AI開発ツールとは、機械学習や大規模言語モデル(LLM)を活用し、以下のようなタスクを支援するソフトウェアアプリケーションです。

  • コード生成
  • リファクタリング
  • ドキュメント作成
  • デバッグ
  • テスト作成
  • CI/CD自動化
  • インフラ管理
  • DevOpsワークフロー
  • コードレビューおよびセキュリティ分析

これらは以下の環境に統合されます。

OpenCodeクイックスタート:ターミナルAIコーディングエージェントのインストール、設定、使用

OpenCodeクイックスタート:ターミナルAIコーディングエージェントのインストール、設定、使用

OpenCodeのインストール、設定、および使用方法

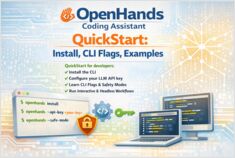
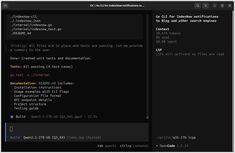
OpenCodeは、ターミナル(TUI + CLI)で実行できるオープンソースのAIコーディングエージェントです。オプションとしてデスクトップおよびIDE向けのインターフェースも提供されています。これはOpenCode クイックスタートです:インストール、確認、モデル/プロバイダーの接続、そして実際のワークフロー(CLI + API)の実行方法を紹介します。

GoでTemporalを用いたワークフローアプリケーションの実装:完全ガイド

GoでTemporalを用いたワークフローアプリケーションの実装:完全ガイド

Temporal SDKを使用してGoでワークフローを構築

Temporal はオープンソースでエンタープライズグレードのワークフローエンジンであり、Go のような馴染みのあるプログラミング言語を使用して、耐障害性があり、スケーラブルで、フォールトトレラントなワークフローアプリケーションを構築することを開発者に可能にします。

LLMシステムの可観測性:本番環境におけるメトリクス、トレース、ログ、およびテスト

LLMシステムの可観測性:本番環境におけるメトリクス、トレース、ログ、およびテスト

LLM推論およびLLMアプリケーションのためのエンドツーエンドの可視化戦略

LLM(大規模言語モデル)システムは、従来のAPIモニタリングでは検知できない方法で失敗します。キューが静かに埋め尽くされ、CPUが忙しい状態になる遥か前にGPUメモリが飽和し、レイテンシはアプリケーションレイヤーではなくバッチ処理レイヤーで急増します。